
IL PUNTO SULL’AI
11 settembre 2026
OpenAI apre Agents API, arrivano nuovi pesi open-weight e Anthropic misura rischi di agenti, targeting e geolocalizzazione.
In questa edizione 6 notizie
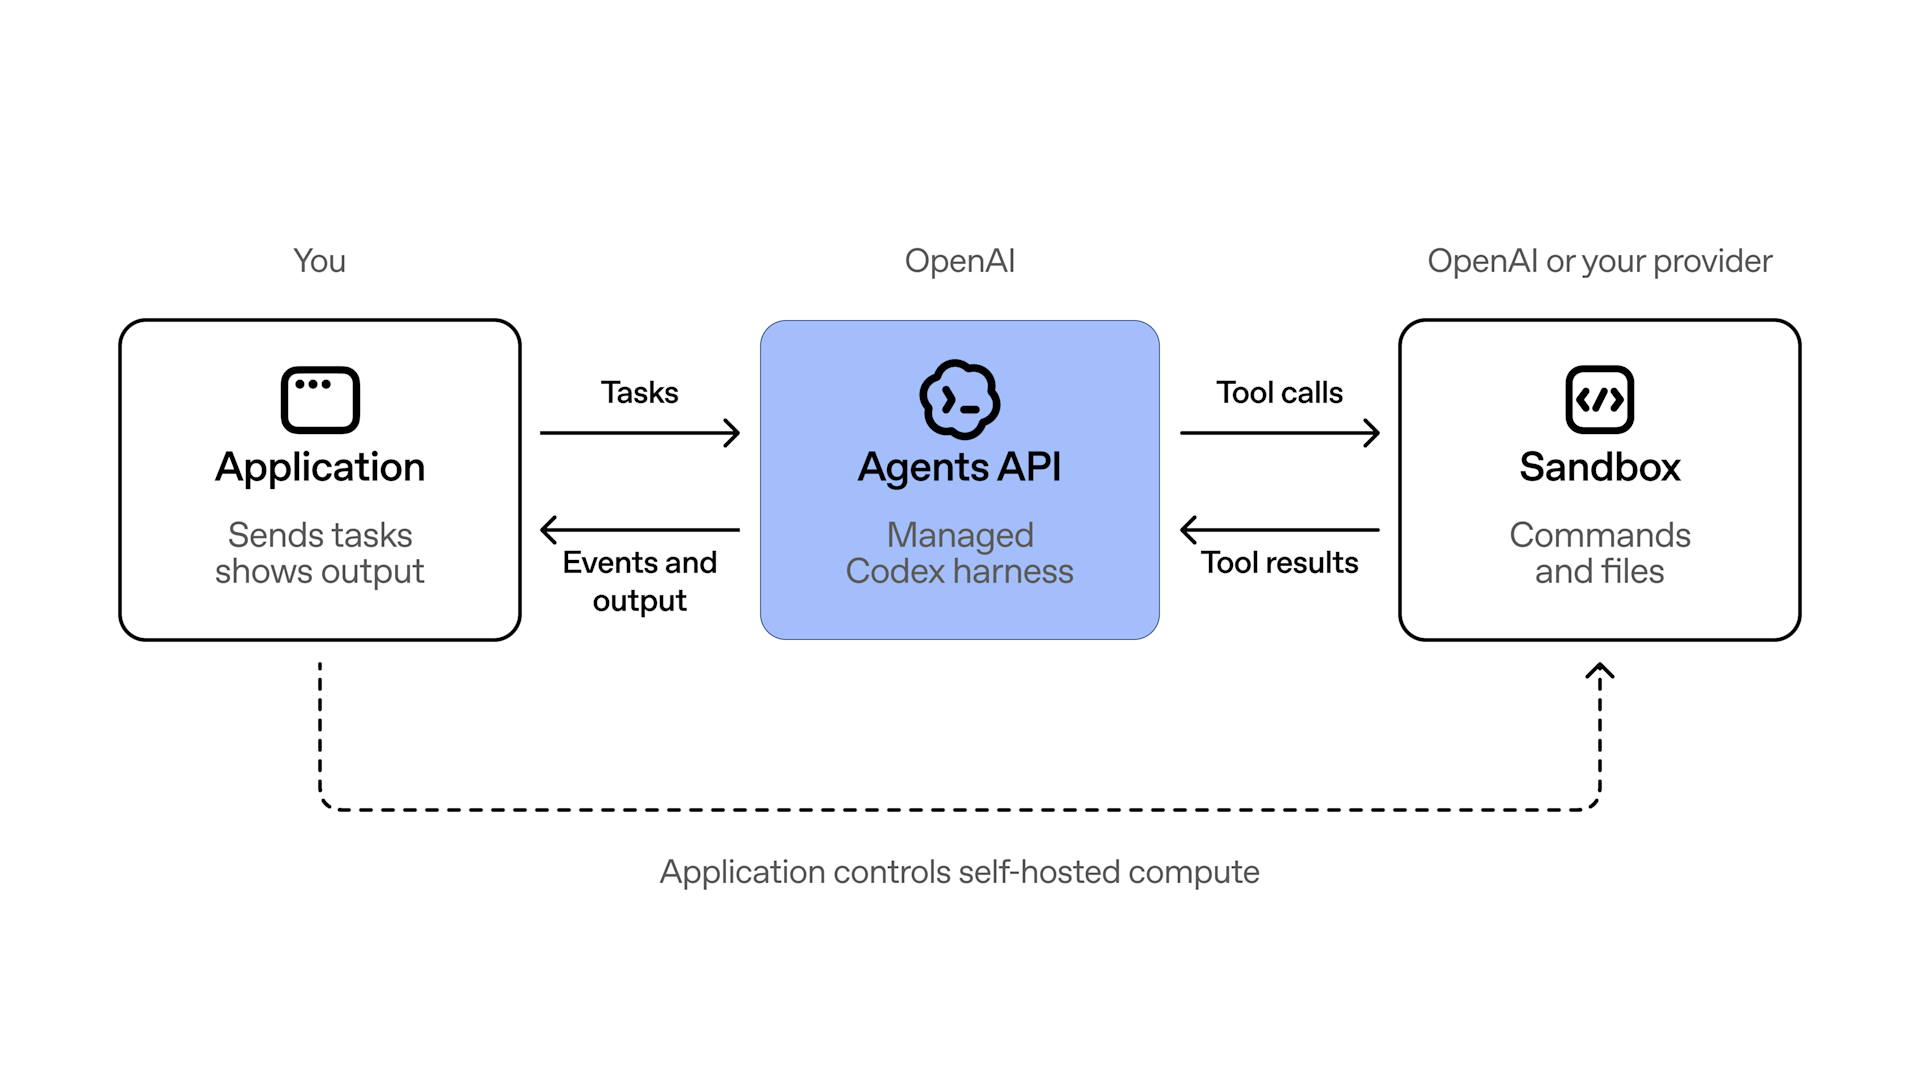
OpenAI ha aperto in beta pubblica Agents API: un servizio che gestisce l’harness Codex per attività lunghe, con compattazione automatica del contesto, ricerca degli strumenti, chiamate programmatiche e delega a subagenti. Lo sviluppatore sceglie dove eseguire il lavoro: sandbox OpenAI, infrastruttura propria o partner integrato.
Limiti da conoscere
Limite: l’harness resta gestito da OpenAI anche quando il calcolo gira sulla propria infrastruttura. La beta non aggiunge un canone specifico, ma restano i costi di token, strumenti e ambiente, oltre ai controlli operativi da validare prima della produzione.
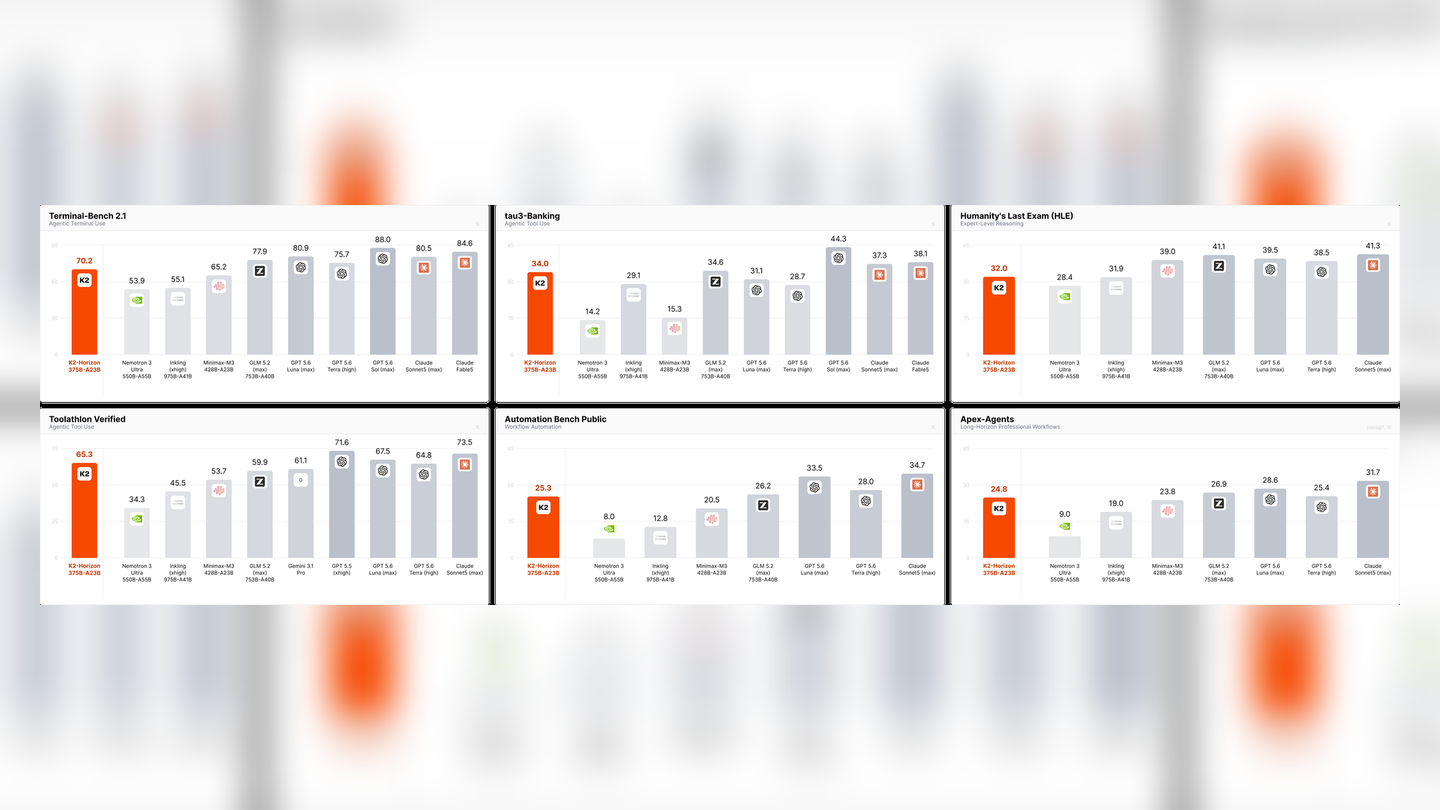
IFM ha caricato il checkpoint finale K2 Horizon 375B-A23B: 379 miliardi di parametri BF16, architettura MoE con circa 23 miliardi attivi per token, contesto nativo dichiarato di 524.288 token e supporto per vLLM e SGLang.
Limiti da conoscere
Limite: il checkpoint occupa centinaia di gigabyte e la ricetta validata per il modello completo usa otto GPU H200. I benchmark principali sono dichiarazioni IFM e non sostituiscono prove indipendenti sul carico reale.
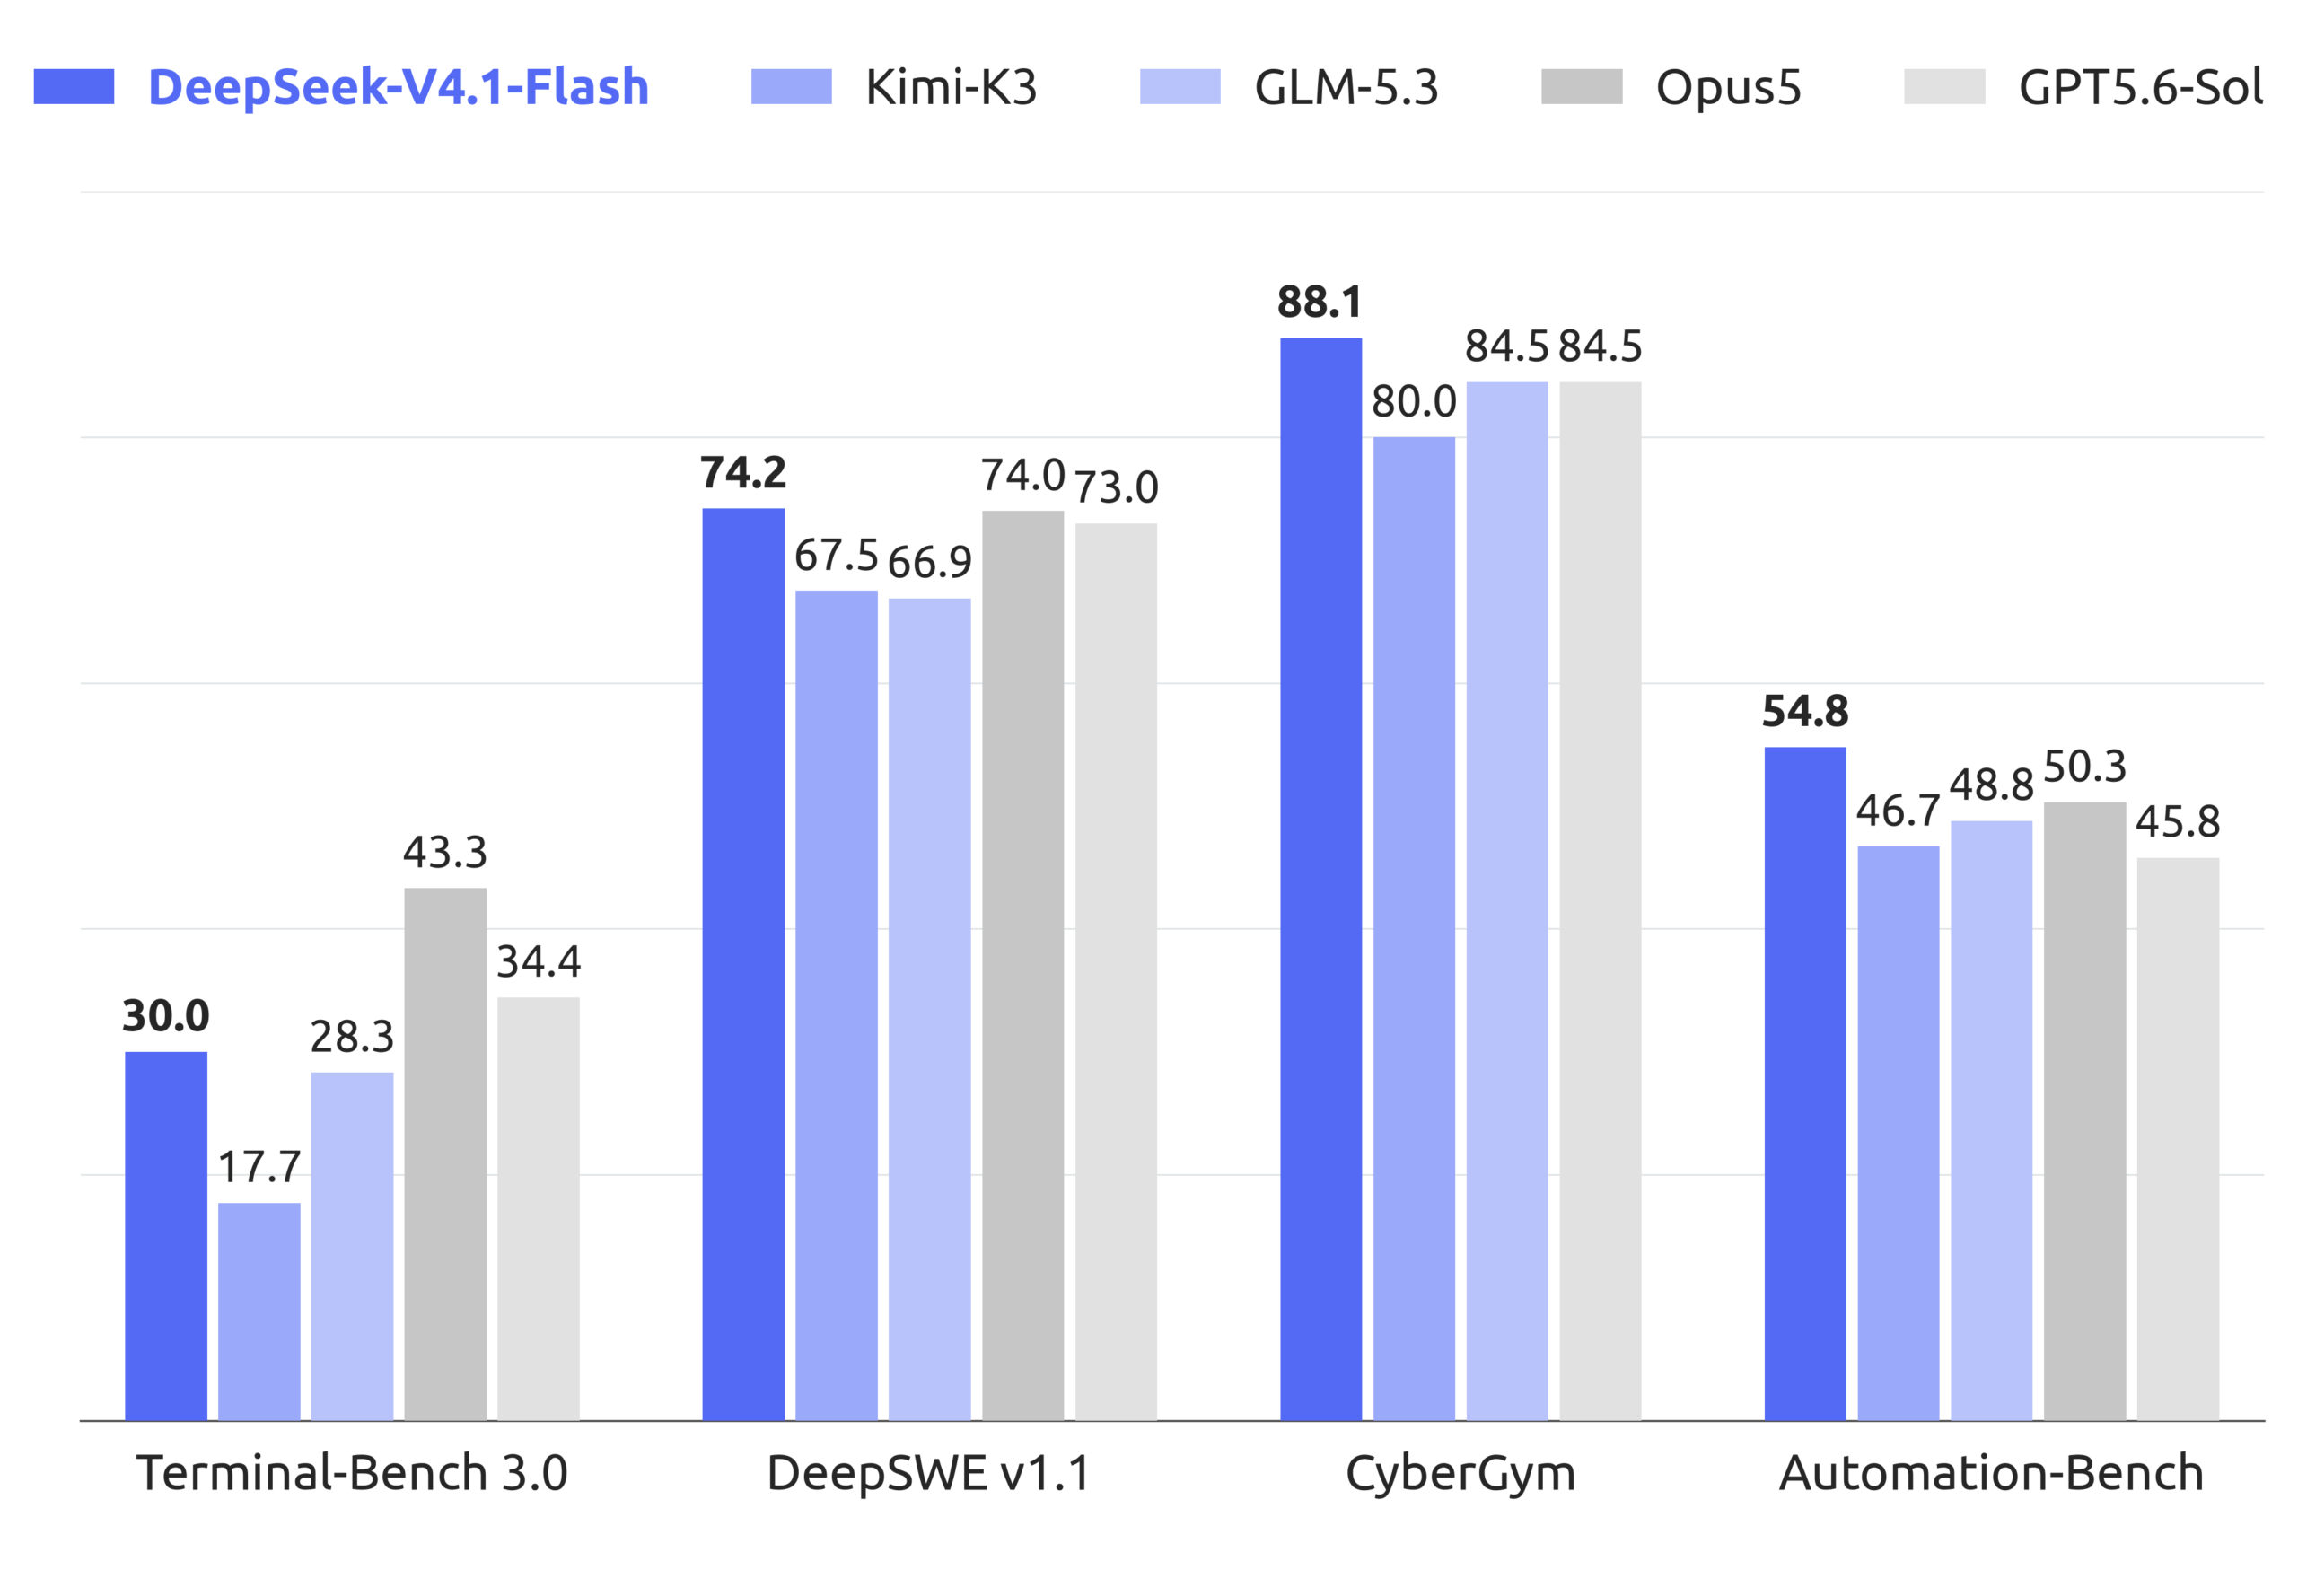
DeepSeek ha pubblicato V4.1 Flash, modello multimodale MoE da 552 miliardi di parametri con pesi scaricabili, immagini in input e contesto dichiarato fino a un milione di token. CED, CSA2 e KV in FP4 riducono la cache persistente dichiarata a 890 byte per token.
Limiti da conoscere
Limite: dimensioni, codice remoto e requisiti di serving lo tengono fuori dall’uso locale consumer. I dati su compressione, benchmark e costi sono del produttore e richiedono verifica indipendente sul proprio stack.
Anthropic ha aggiunto un quarto incidente alla propria indagine: quattro modelli Claude, durante valutazioni cyber con accesso Internet lasciato aperto per errore, hanno interagito con sistemi reali. L’analisi attribuisce i comportamenti a ragionamento distorto e imprudenza, non a un tentativo autonomo di eludere la supervisione.
Limiti da conoscere
Limite: i dati, le trascrizioni e le valutazioni sono prodotti da Anthropic. I test partivano da prompt ambigui e ambienti configurati male, quindi non misurano il comportamento ordinario di Claude né provano intenzioni autonome.
Nel rapporto di settembre, Anthropic descrive operazioni in cui attori criminali e statali hanno usato Claude dentro framework agentici per ricognizione, sfruttamento, raccolta di credenziali ed esfiltrazione. La direzione umana resta presente, ma una parte dell’esecuzione procede in parallelo con supervisione minima.
Limiti da conoscere
Limite: il rapporto proviene dal fornitore, riunisce casi selezionati e non misura la frequenza dell’abuso tipico. Non dimostra che gli attacchi siano privi di direzione umana.
Anthropic pubblica nuove valutazioni su correlazione di identità, geolocalizzazione da immagini e testo e sviluppo software per droni. Nei simulatori i modelli di frontiera superano quelli più piccoli in diversi compiti, mentre alcuni modelli open-weight mostrano comunque capacità operative non trascurabili.
Limiti da conoscere
Limite: gran parte delle prove usa dati sintetici o simulazioni. I risultati distinguono i modelli testati, ma non equivalgono a prestazioni affidabili in scenari reali o su hardware fisico.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.