
L’ANALISI
GitHub HydraFusion orchestra più modelli per qualità e costo nel coding
HydraFusion sceglie tra esecuzione singola, cascata e critica indipendente in GitHub Copilot. Come leggere benchmark, costi e limiti della preview.
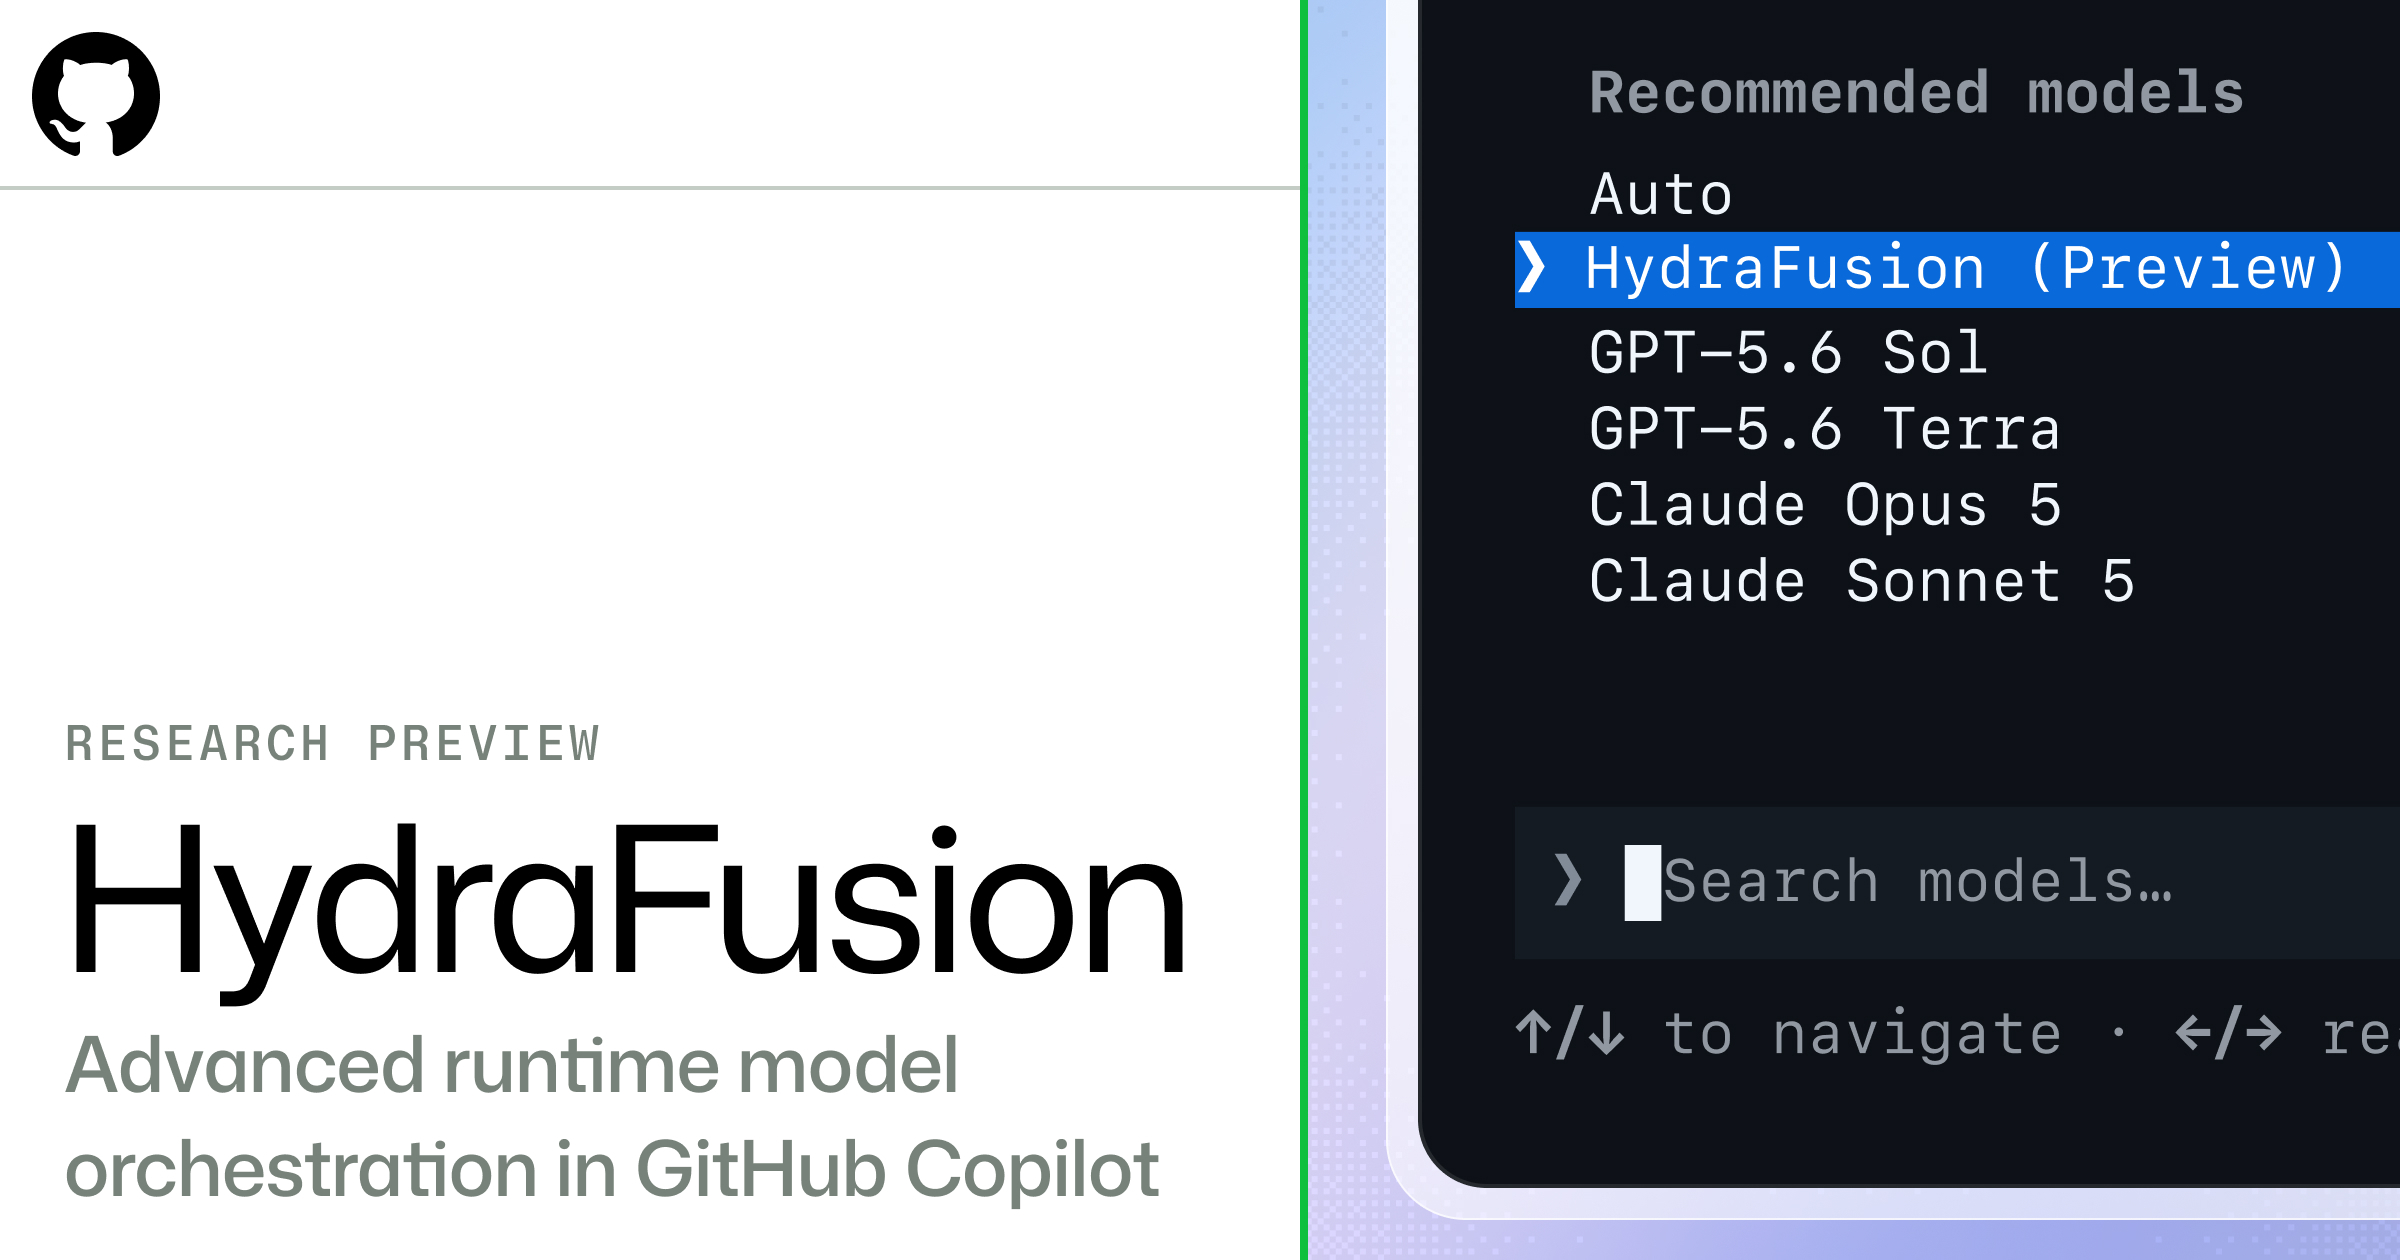
In breve: GitHub introduce HydraFusion in research preview: il runtime sceglie tra modello singolo, cascata e critica indipendente per bilanciare qualità, costo e latenza nei task di coding. Non è un nuovo modello: è un livello di orchestrazione che decide quando spendere una seconda chiamata o coinvolgere un modello più forte.
Che cosa cambia in Copilot
HydraFusion appare come una scelta unica, ma costruisce il piano di esecuzione dietro le quinte. Può affidare tutto a un modello, partire con un modello efficiente e salire di livello solo se il controllo fallisce, oppure far revisionare la bozza a un critico read-only di una famiglia diversa.
Le tre modalità operative
Single privilegia velocità e costo. Cascade aggiunge un gate prima dell’escalation. Critique separa autore e revisore, poi concede una sola revisione al modello che ha prodotto la bozza. GitHub dichiara timeout, contabilizzazione completa, isolamento del critico e nessuna patch applicata se il flusso viene annullato o non supera la validazione.
Come leggere i benchmark
Su TerminalBench 2.1 GitHub riporta 4,9 punti percentuali in più di qualità verificata e un costo stimato inferiore del 67% rispetto a Claude Opus 5. Su DeepSWE la qualità è inferiore di 1,5 punti con costo inferiore del 36%; su CheckpointBench lo scarto è di 0,1 punti con costo inferiore del 65%. Sono confronti del vendor a reasoning medio, non prove indipendenti.
Dove può essere utile
Il vantaggio potenziale emerge quando molti task non richiedono sempre il modello più costoso, ma alcuni necessitano escalation o revisione. Per team che già alternano manualmente modelli, la preview prova a rendere quella scelta parte del runtime e della telemetria.
Condizioni e limiti
I risultati sono valutazioni offline di GitHub, eseguite con configurazioni e prezzi specifici. La preview è consigliata soprattutto per task singoli e ben delimitati; multi-turno, latenza e affidabilità su repository reali restano da validare. Anche CheckpointBench è interno a GitHub, pur essendo costruito su sessioni ancorate a repository e commit pubblici.
Checklist di prova
- Scegliere task a singolo prompt con criteri di accettazione verificabili.
- Confrontare HydraFusion e un modello fisso sugli stessi repository e commit.
- Registrare qualità finale, latenza, costo totale e numero di escalation.
- Controllare che annullamenti e fallimenti non applichino patch parziali.
- Ripetere il test sui task multi-turno prima di adottarlo nel lavoro quotidiano.