
L’ANALISI
Minima porta Qwen3.8-27B a 17,5 GiB con NVFP4 su tutti i layer
Minima comprime Qwen3.8-27B a 17,5 GiB con NVFP4 W4A4 su tutti i layer. Risultati dichiarati, limiti e procedura di verifica locale.
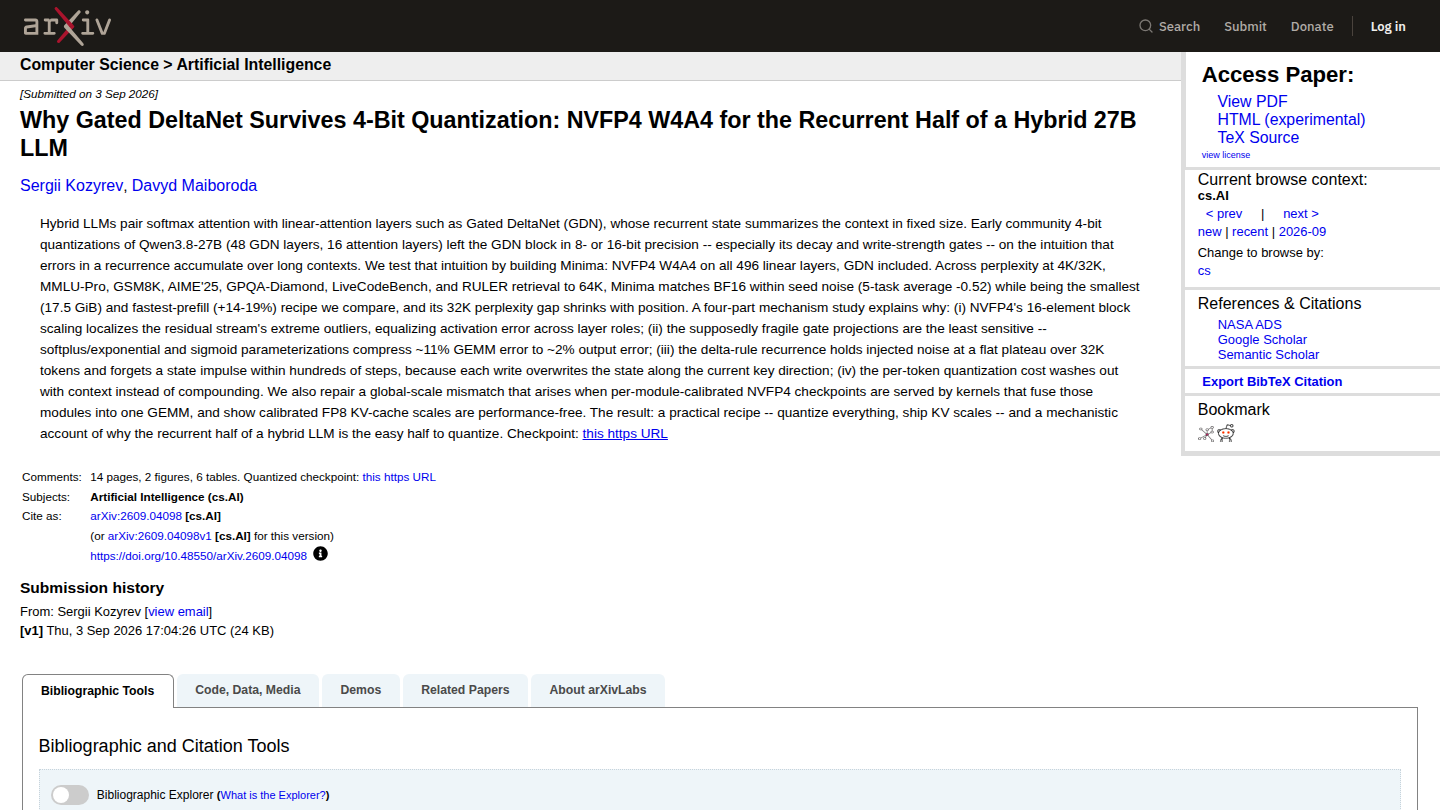
In breve: Il paper Minima quantizza in NVFP4 W4A4 tutti i 496 layer lineari di Qwen3.8-27B, inclusa la parte ricorrente Gated DeltaNet. Gli autori riportano 17,5 GiB e un prefill più rapido del 14-19% nelle configurazioni confrontate.
Cosa è stato pubblicato
Il paper Minima quantizza in NVFP4 W4A4 tutti i 496 layer lineari di Qwen3.8-27B, inclusa la parte ricorrente Gated DeltaNet. Gli autori riportano 17,5 GiB e un prefill più rapido del 14-19% nelle configurazioni confrontate.
Perché conta
Il lavoro mette alla prova l’idea che gli strati ricorrenti debbano restare a precisione più alta e propone una ricetta riproducibile per ridurre memoria e tempo di prefill.
Come leggere i numeri
17,5 GiB, il vantaggio di prefill e lo scarto medio dichiarato derivano dal setup del paper. Hardware, runtime, kernel e lunghezza del contesto possono cambiare il risultato.
Condizioni e limiti
È un preprint degli autori del checkpoint, non una replica indipendente. Il risultato dipende inoltre da kernel compatibili e dalla corretta gestione delle scale globali e della KV cache.
Checklist pratica
- Verificare supporto NVFP4 reale di GPU e runtime.
- Controllare che le scale per modulo non vengano fuse in modo incompatibile.
- Confrontare lo stesso prompt set con BF16 o un quant noto.
- Misurare qualità e velocità a 4K, 32K e sul contesto operativo.