
L’ANALISI
llama.cpp b11003 porta Mimir 1B in GGUF: cosa funziona e cosa manca
La nuova build aggiunge il percorso completo per HRM-Text, dalla conversione al grafo di inferenza. Mimir 1B ora parte in llama.cpp, ma la modalità prefix-LM resta assente e cambia il significato dei confronti qualitativi.
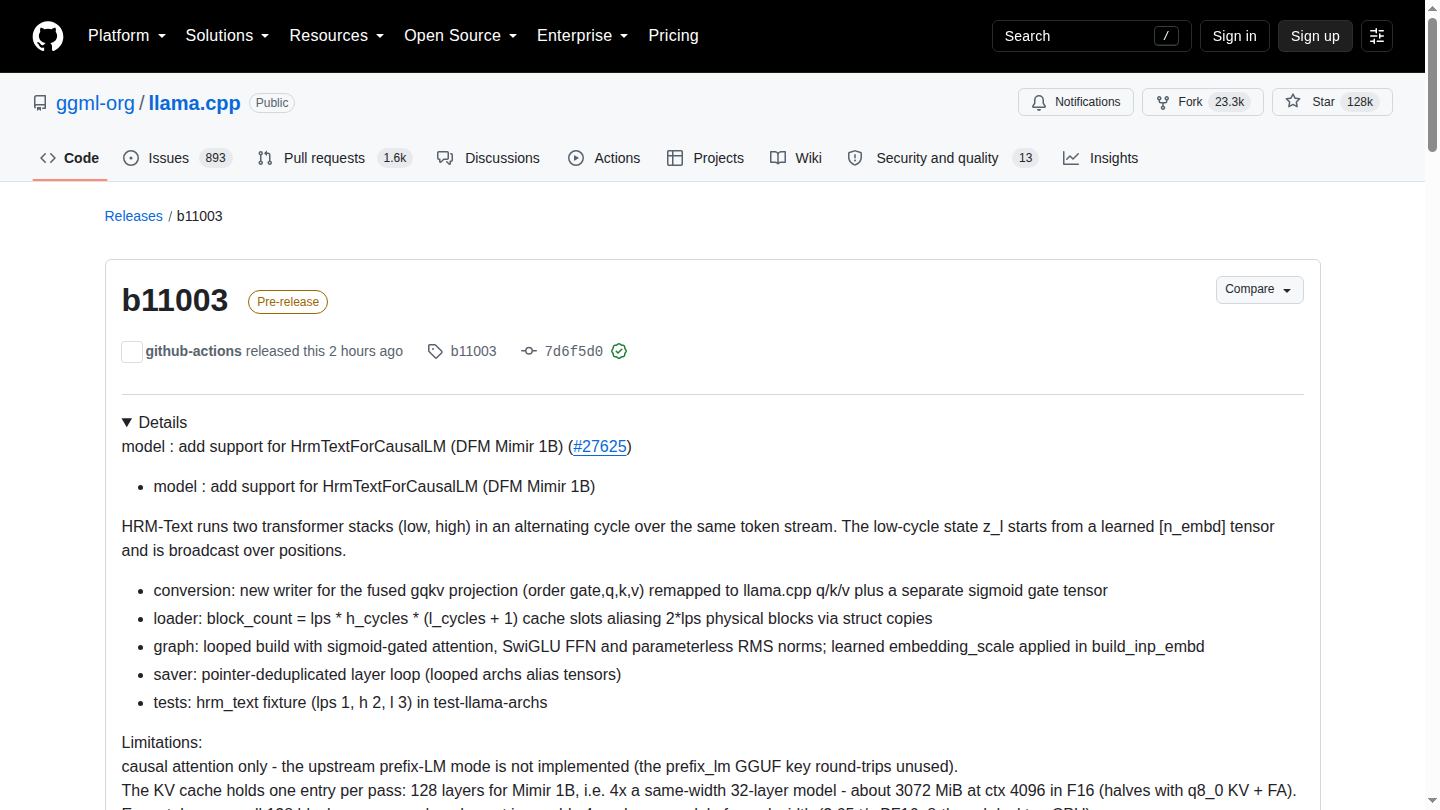
In breve: b11003 rende Mimir 1B convertibile ed eseguibile in GGUF, quindi il modello entra nel flusso locale di llama.cpp. Non riproduce però la modalità prefix-LM del riferimento: serve per prove tecniche e compatibilità, non per attribuire automaticamente al port le prestazioni dichiarate dal modello originale.
Cosa aggiunge davvero b11003
Il contributo introduce un writer per la proiezione gQKV fusa, il caricamento dei metadati HRM, il grafo con attenzione gated e i cicli alternati dei due stack transformer. Aggiunge inoltre salvataggio con deduplicazione dei tensori e test dell’architettura, rendendo possibile convertire i checkpoint compatibili e avviarli con il runtime standard.
Come è stato verificato il port
La release riporta argmax identico in 334 posizioni su 334, su 20 prompt, confrontando GGUF BF16 e riferimento FP32. Per Q8_0 dichiara il 95,8% di coincidenza top-1, con gli scarti rimanenti entro la top-5 del riferimento. Sono controlli del contributore, non una valutazione indipendente della qualità generale.
Perché prefix-LM cambia il confronto
Mimir è stato addestrato affinché i token del prompt possano vedersi in entrambe le direzioni, mentre i token generati restano causali. Questa prima implementazione usa attenzione causale anche durante la lettura del prompt. La compatibilità binaria non equivale quindi a riprodurre il comportamento di inferenza del codice originale.
Costo di memoria e velocità
HRM-Text ripete 128 passaggi di blocco per token. L’autore stima circa 3072 MiB di KV cache a contesto 4096 in F16, dimezzabili con cache Q8_0 e Flash Attention, e misura 2,65 token/s in BF16 su una CPU desktop a 8 thread. Sono dati circoscritti alla configurazione dichiarata, non un benchmark universale.
Condizioni e limitazioni
b11003 è una pre-release e l’autore dichiara il supporto sperimentale. La modalità prefix-LM è ignorata, i test riportati verificano soprattutto equivalenza del percorso causale e quantizzazione, e non sostituiscono prove su accuratezza, prompt lunghi, GPU diverse o stabilità operativa.
Checklist pratica
- Installare b11003 o una build successiva che includa la pull request #27625.
- Scaricare un GGUF Mimir compatibile e conservarne quantizzazione, hash e provenienza.
- Avviare prima un prompt breve e confrontare l’output con il riferimento Transformers.
- Misurare token/s e memoria con il proprio contesto, numero di thread e backend.
- Non confrontare benchmark del port con quelli del modello originale senza una prova prefix-LM equivalente.
- Trattare il supporto come sperimentale e mantenere una build precedente per il rollback.