
L’ANALISI
K2-Horizon: 3.7B, nuovo 7B e versioni MLX a confronto
La famiglia K2-Horizon ora comprende modelli densi 3.7B e 7B con contesto 512K, più conversioni MLX: cosa è scaricabile, come servirli e quali limiti misurare.
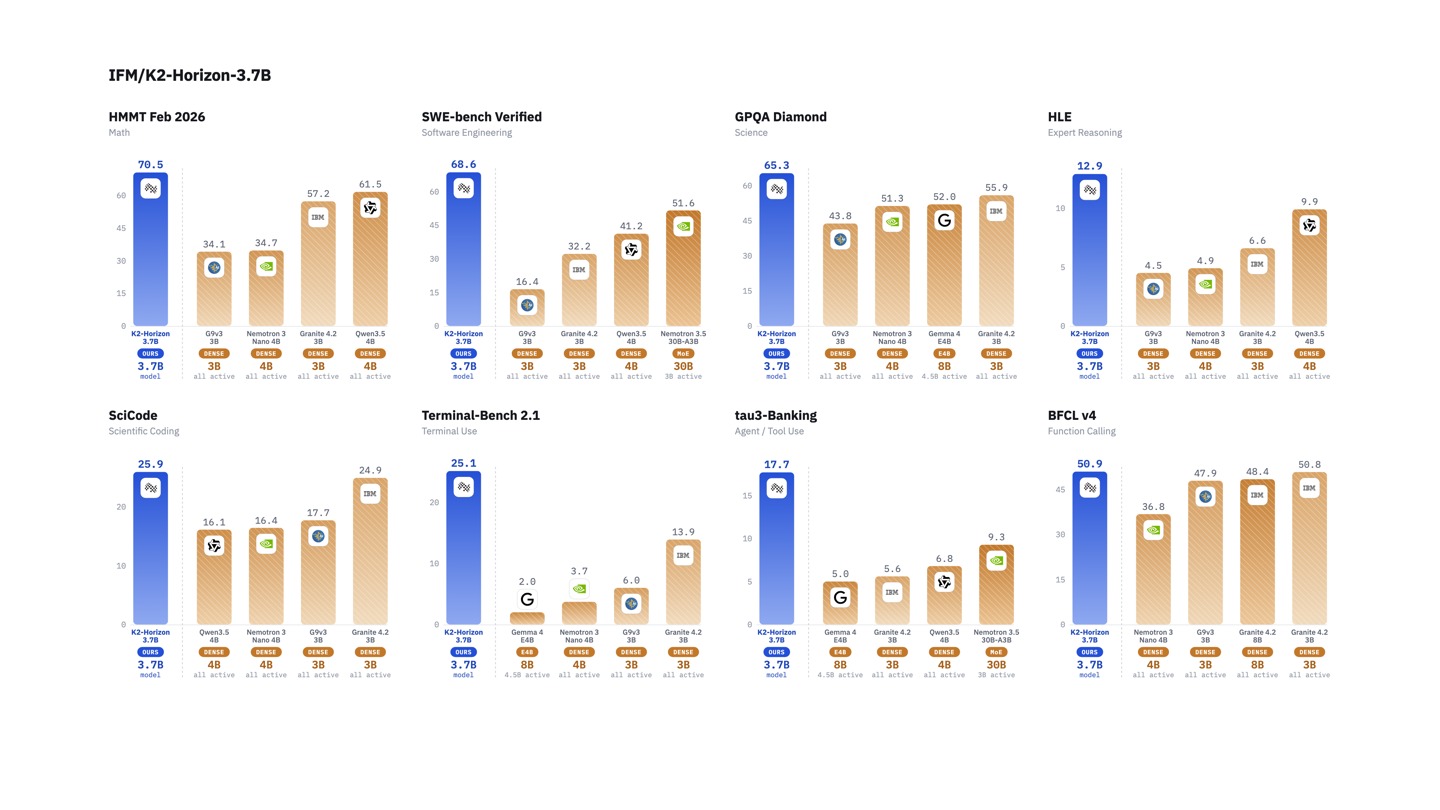
In breve: il nuovo 7B è un rilascio IFM completo, non una semplice conversione. Offre pesi, codice, checkpoint intermedi e ricette vLLM/SGLang; le versioni MLX restano invece artefatti della community utili su Apple Silicon. Il contesto nominale 512K e i benchmark ufficiali richiedono ancora verifica sul proprio hardware e carico.
Che cosa cambia con il 7B
Il repository K2-Horizon-7B rende disponibili 36 shard Safetensors, configurazione, tokenizer, codice del modello, checkpoint intermedi e figure di valutazione. Rispetto al 3.7B già pubblicato, aumenta la capacità del modello mantenendo architettura densa e finestra nativa di 524.288 token.
Benchmark dichiarati
IFM riporta 70,6 su SWE-bench Verified, 39,1 su Terminal-Bench 2.1 e 59,0 su BrowseComp. Sono risultati del produttore: la stessa scheda segnala che BrowseComp usa il protocollo Discard-all@95k e che i confronti possono adottare harness differenti.
Serving e requisiti
La ricetta vLLM usa bfloat16, tensor parallel 1, parser dedicati per reasoning e tool call e limita il contesto iniziale a 131.072 token. SGLang dispone di una revisione validata. Entrambe le strade eseguono codice remoto del repository, che va revisionato e bloccato a commit.
Rapporto con 3.7B e MLX
Il 3.7B resta l’opzione più compatta della famiglia. Le conversioni MLX consentono prove su Apple Silicon, ma non sono release IFM né supporto nativo di mlx-lm. Il 7B ufficiale è quindi un nuovo artefatto scaricabile; MLX è un percorso operativo separato.
Contesto 512K e memoria
La finestra dichiarata non equivale a una prova end-to-end. La KV cache cresce con il contesto e il quickstart ufficiale parte da 128K. Vanno misurati prefill, throughput, memoria di picco e capacità di recupero prima di decidere se il modello è adatto a documenti molto lunghi.
Condizioni e limiti
Mancano test indipendenti sufficienti su italiano, sicurezza del codice remoto, qualità a 512K e confronto a parità di harness. I punteggi ufficiali orientano una prova, ma non dimostrano il risultato sul proprio stack.
Checklist pratica
- Bloccare commit e hash dei pesi prima del download.
- Revisionare modeling_k2_horizon.py prima di abilitare trust-remote-code.
- Partire dalla ricetta ufficiale a 131.072 token.
- Misurare VRAM, prefill, token al secondo e latenza.
- Confrontare 3.7B e 7B sugli stessi prompt italiani.
- Provare tool calling e formato reasoning.
- Aumentare il contesto per gradini verificando recupero e stabilità.
- Separare i risultati IFM da quelli delle conversioni MLX.