
IL PUNTO SULL’AI
17 novembre 2026
vLLM 0.34.0 elimina il vecchio runner e cambia cache e requisiti ROCm; llama.cpp corregge tre difetti del prefill OpenCL su Adreno.
In questa edizione 2 notizie
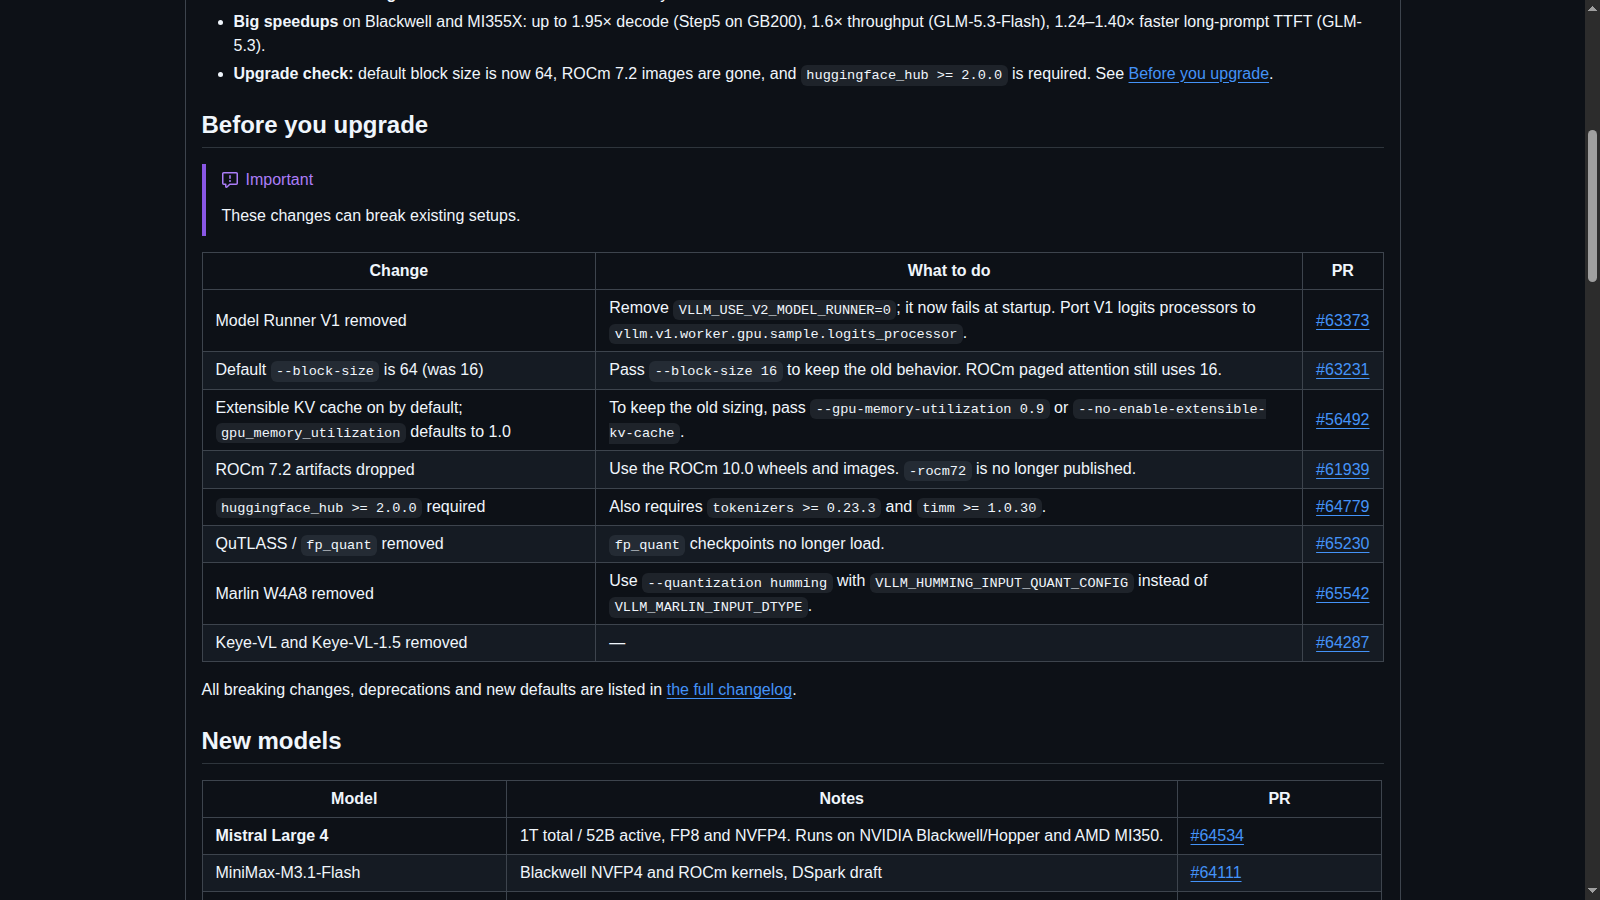
La release stabile rimuove Model Runner V1, attiva la cache KV estensibile per default e porta il block size ordinario a 64. Cambiano anche gli artefatti ROCm e le dipendenze: non è un aggiornamento trasparente per tutte le configurazioni. vLLM 0.34.0: note ufficiali e controlli prima dell’aggiornamento.
Limiti da conoscere
Limite: Le prestazioni riportate sono del progetto e dipendono da modello e hardware. La paged attention ROCm mantiene block size 16. Nessun aggiornamento o benchmark indipendente è stato eseguito qui.
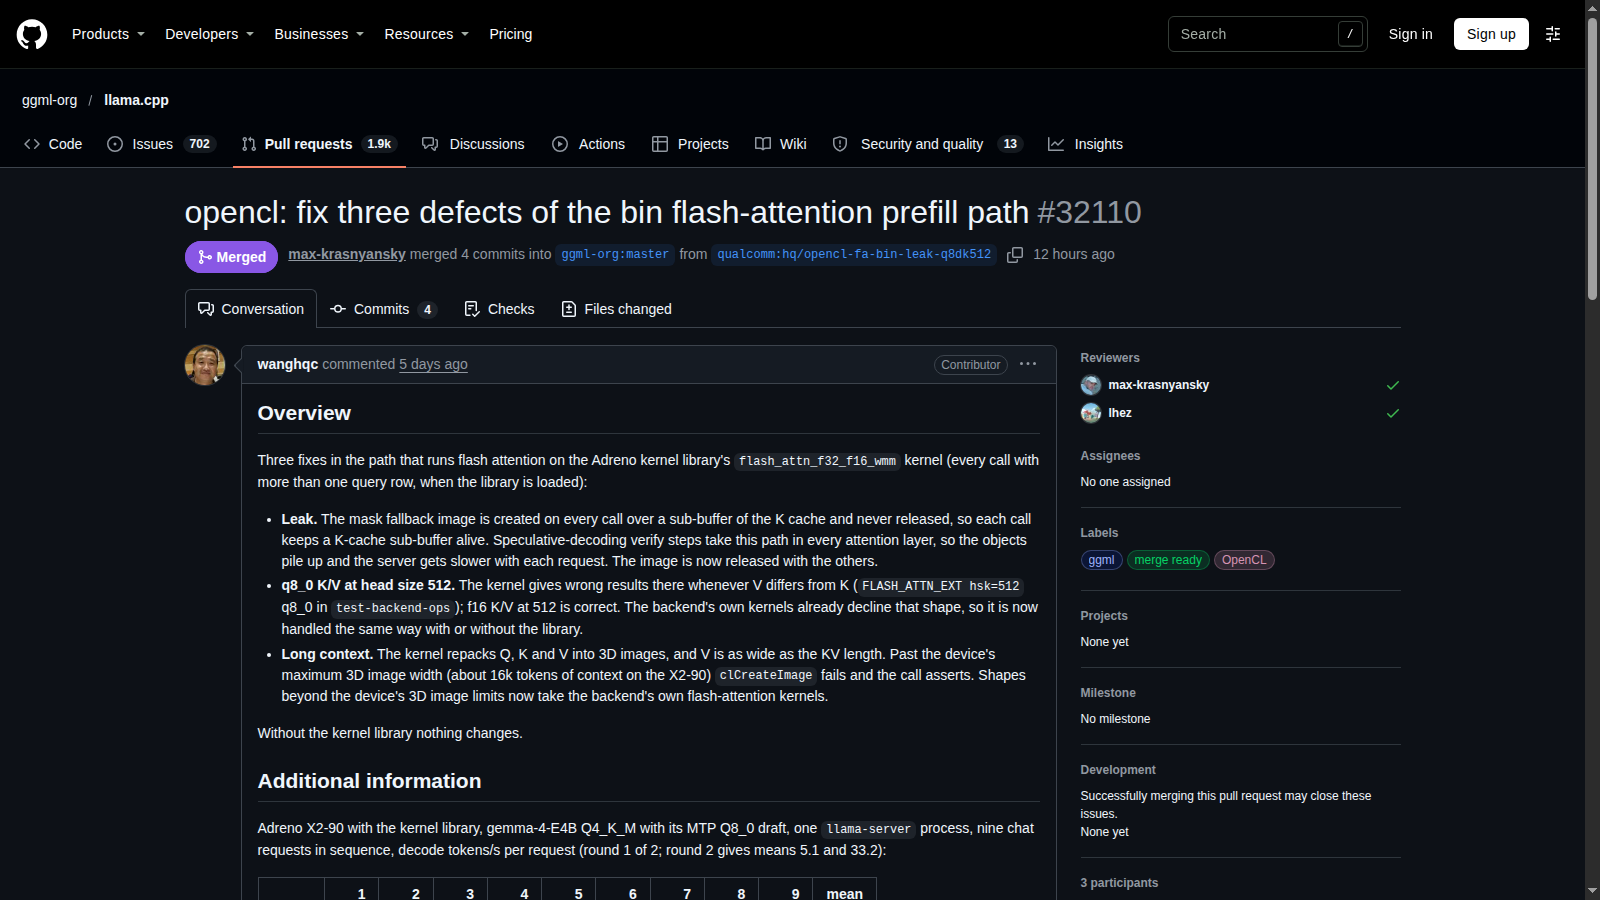
La prerelease b12456 interviene su un’immagine non rilasciata, sui risultati errati con cache K/V q8_0 e head size 512 e sul superamento dei limiti delle immagini 3D. Le correzioni riguardano il percorso della libreria di kernel Adreno. llama.cpp: PR sui tre difetti del prefill flash-attention Adreno.
Limiti da conoscere
Limite: La PR precisa che senza la libreria di kernel il comportamento non cambia. Le misure su Adreno X2-90 sono dell’autore, non benchmark riprodotti né una promessa per tutte le GPU.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.