
L’ANALISI
vLLM 0.34.0: cosa controllare prima di aggiornare
vLLM 0.34.0 rimuove Model Runner V1 e cambia cache KV e block size. ROCm 7.2 lascia posto a 10.0: requisiti e checklist prima dell’upgrade.
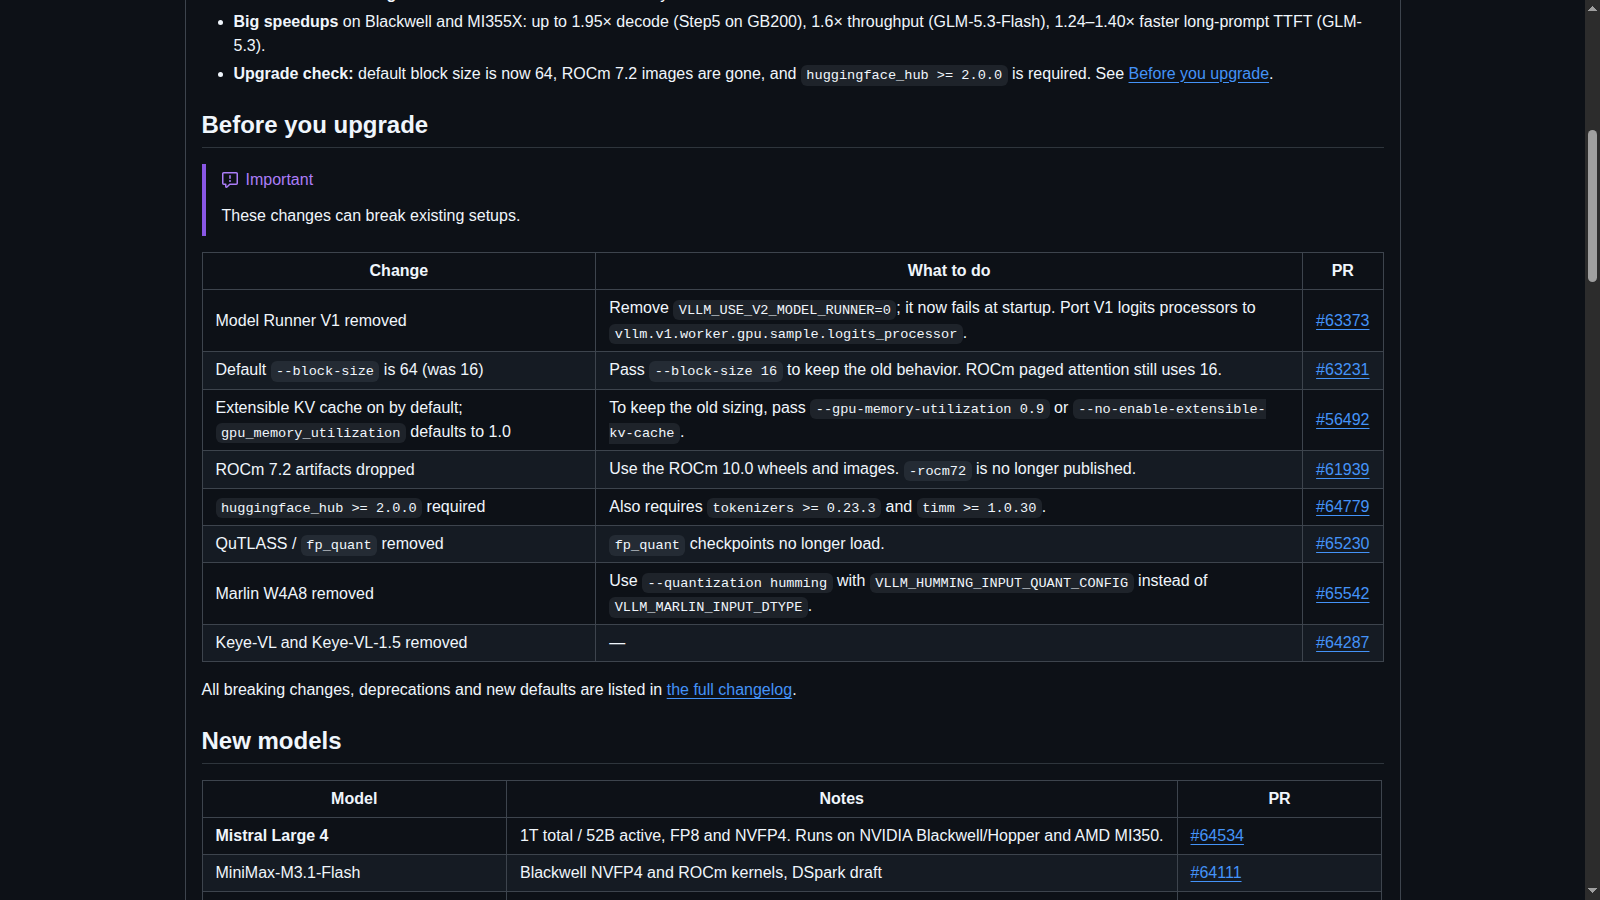
In breve: Prima di passare a vLLM 0.34.0 occorre verificare runner, dimensionamento della cache e ambiente ROCm. La release elimina il vecchio runner GPU e cambia valori predefiniti che possono incidere su avvio e memoria. La scelta utile è un confronto in staging, non assumere che una nuova versione sia più veloce sul proprio server. vLLM 0.34.0: note ufficiali e controlli prima dell’aggiornamento.
Metodo: Analisi documentale delle fonti primarie verificata il 17 novembre 2026. Nessuna installazione, aggiornamento di produzione o prova prestazionale dei progetti è stata eseguita per queste notizie.
Che cosa può impedire l’avvio?
Le note chiedono di rimuovere VLLM_USE_V2_MODEL_RUNNER=0: il fallback a V1 non è più disponibile. Anche i logits processor personalizzati vanno portati al percorso indicato nel changelog. Prima della migrazione conviene inventariare variabili, estensioni e comando effettivo del servizio, non soltanto il pacchetto installato. Una configurazione rimasta valida per mesi può ora fermarsi all’avvio. vLLM 0.34.0: note ufficiali e controlli prima dell’aggiornamento.
Come cambiano cache KV e block size?
La cache estensibile viene dimensionata sulla memoria libera dopo warmup e cattura dei grafi. Il block size predefinito passa da 16 a 64, con l’eccezione della paged attention ROCm. Le note indicano opzioni per mantenere parte del comportamento precedente. Il confronto proposto deve registrare memoria occupata, concorrenza, tempo al primo token e latenza per token: una cache più grande non dimostra da sola che ogni richiesta termini prima. vLLM 0.34.0: note ufficiali e controlli prima dell’aggiornamento.
Quali ambienti richiedono una verifica separata?
Gli artefatti ROCm 7.2 non vengono più pubblicati e le note rimandano a ROCm 10.0. Cambiano inoltre i requisiti minimi di huggingface_hub, tokenizers e timm. Per chi usa immagini fissate o una GPU condivisa, la procedura prudente è risolvere tutte le dipendenze in un ambiente separato, salvare l’immagine precedente e controllare il caricamento del proprio checkpoint prima di sostituire il servizio. vLLM 0.34.0: note ufficiali e controlli prima dell’aggiornamento.
Quando ha senso promuovere l’aggiornamento?
Solo dopo un confronto sullo stesso carico. La proposta operativa è fissare modello, quantizzazione, prompt e richieste concorrenti; verificare prima la correttezza e poi misurare latenza e memoria. I miglioramenti pubblicati su acceleratori specifici sono indicazioni per scegliere una prova, non un risultato già ottenuto sull’hardware del lettore. Un peggioramento sul carico principale è un motivo per mantenere la versione precedente. vLLM 0.34.0: note ufficiali e controlli prima dell’aggiornamento.
Condizioni e limitazioni
Le prestazioni riportate sono del progetto e dipendono da modello e hardware. La paged attention ROCm mantiene block size 16. Nessun aggiornamento o benchmark indipendente è stato eseguito qui. vLLM 0.34.0: note ufficiali e controlli prima dell’aggiornamento.
Checklist pratica proposta
- Salvare versione, immagine, variabili e comando attuali.
- Cercare il fallback a Runner V1 e i logits processor personalizzati.
- Controllare driver, artefatto ROCm e dipendenze richieste.
- Provare lo stesso modello e carico in staging senza dati sensibili.
- Confrontare correttezza, memoria, TTFT e latenza per token.
- Promuovere solo con una soglia operativa e un rollback definiti.