
L’ANALISI
llama.cpp OpenCL: tre fix per Adreno, con limiti
llama.cpp b12456 corregge tre difetti del prefill OpenCL su Adreno. Senza la libreria di kernel coinvolta il comportamento non cambia.
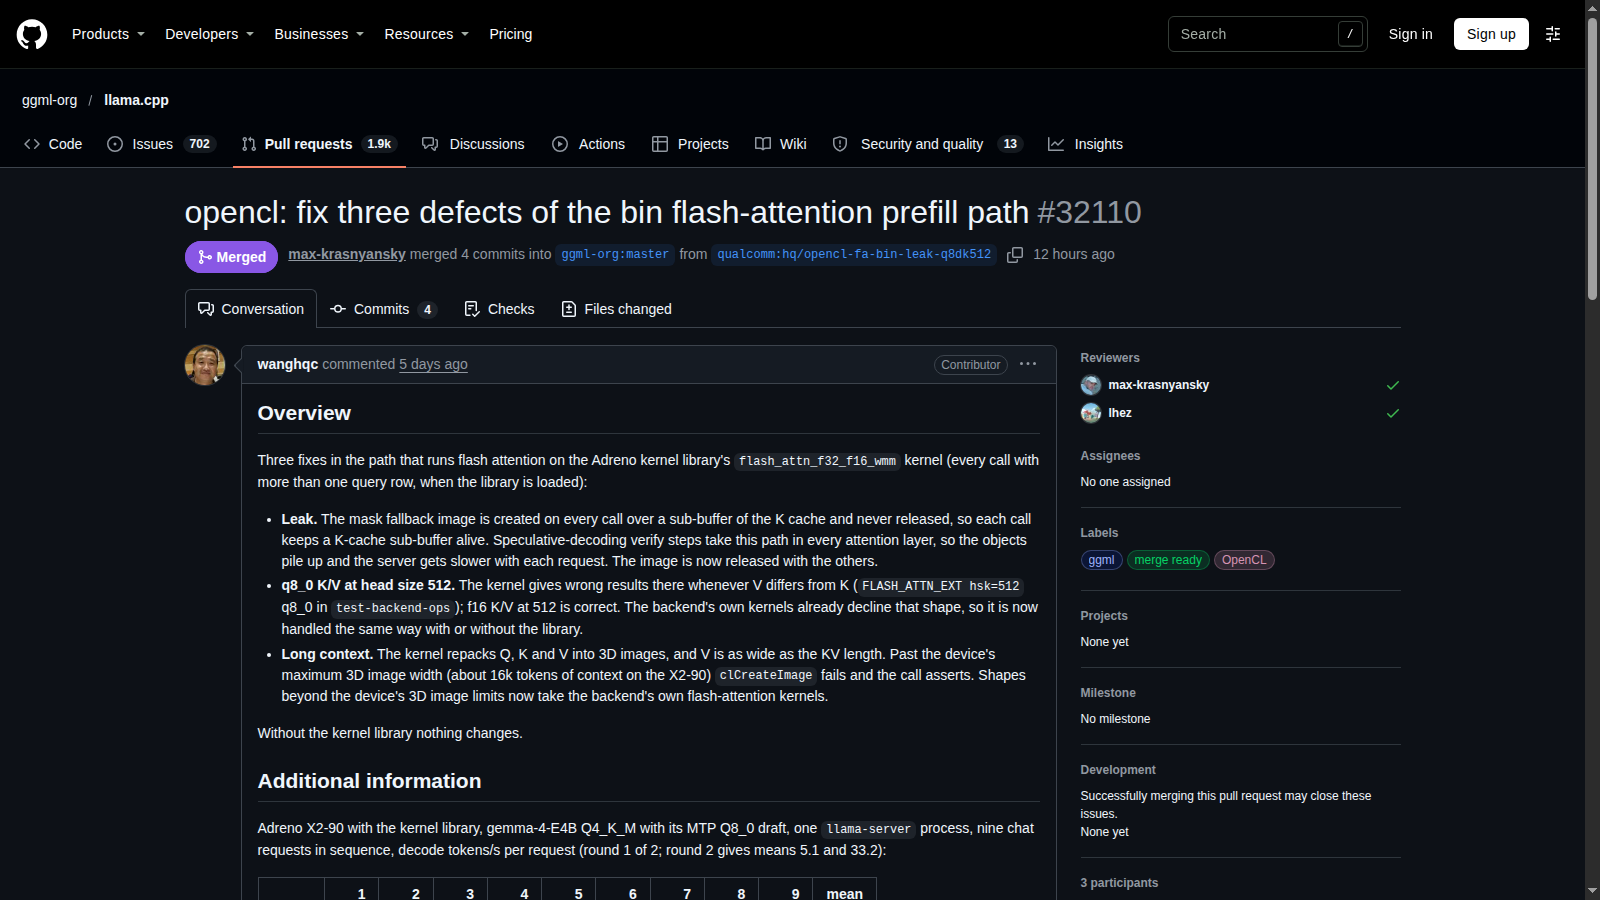
In breve: Il delta di b12456 è una correzione mirata di memoria e correttezza nel prefill OpenCL Adreno. Non è una nuova accelerazione generale di llama.cpp. Prima di considerarlo rilevante bisogna capire se la propria build carica la libreria di kernel descritta nella PR e se usa le forme di attenzione interessate. llama.cpp: PR sui tre difetti del prefill flash-attention Adreno.
Metodo: Analisi documentale delle fonti primarie verificata il 17 novembre 2026. Nessuna installazione, aggiornamento di produzione o prova prestazionale dei progetti è stata eseguita per queste notizie.
Quale percorso è interessato?
La PR riguarda il kernel flash-attention della libreria Adreno quando una chiamata ha più di una riga di query. Include quindi anche verifiche nella decodifica speculativa. Il primo controllo proposto è leggere build e log del backend: avere una GPU Qualcomm o usare OpenCL non basta a dimostrare che la chiamata passi proprio da quel kernel. llama.cpp: PR sui tre difetti del prefill flash-attention Adreno.
Perché il server poteva rallentare nel tempo?
Una delle immagini temporanee manteneva vivo un sotto-buffer della cache K. Ripetendo le richieste, gli oggetti si accumulavano. La correzione ne aggiunge il rilascio. Per valutarla non basta misurare una sola risposta: il test utile è una sequenza controllata di richieste con osservazione della memoria e della velocità, lasciando invariati modello e impostazioni. llama.cpp: PR sui tre difetti del prefill flash-attention Adreno.
Che cosa cambia per correttezza e contesti lunghi?
Il percorso coinvolto dava risultati errati con K/V q8_0 e head size 512; quella forma viene ora instradata come già avveniva senza la libreria. Anche le forme oltre i limiti 3D del dispositivo usano il percorso ordinario. Il contesto indicato per X2-90 è una condizione del caso descritto, non un limite unico di llama.cpp o di ogni modello. llama.cpp: PR sui tre difetti del prefill flash-attention Adreno.
Come confrontare il risultato senza generalizzarlo?
L’autore pubblica configurazione e misure prima/dopo su X2-90. Sono utili per costruire una fixture, non per attribuire lo stesso incremento a un’altra GPU. La proposta è confrontare una build precedente e una con il fix, ripetere più richieste e verificare il risultato numerico prima della velocità. Nessuna di queste prove hardware è stata eseguita per questa scheda. llama.cpp: PR sui tre difetti del prefill flash-attention Adreno.
Condizioni e limitazioni
La PR precisa che senza la libreria di kernel il comportamento non cambia. Le misure su Adreno X2-90 sono dell’autore, non benchmark riprodotti né una promessa per tutte le GPU. llama.cpp b12456: prerelease che contiene le correzioni.
Checklist pratica proposta
- Annotare tag o commit, driver e backend realmente usato.
- Verificare se la libreria di kernel Adreno è caricata.
- Registrare tipo K/V, head size e lunghezza del contesto.
- Ripetere richieste identiche osservando memoria e latenza.
- Eseguire i test di correttezza pertinenti prima del benchmark.
- Conservare i risultati per dispositivo senza estenderli ad altre GPU.