
L’ANALISI
tandem.cpp: offload MoE e build ROCm, cosa verificare
tandem.cpp distribuisce gli esperti MoE fra GPU, RAM e CPU. La build ROCm è documentata, ma il launcher automatico resta Linux e NVIDIA.
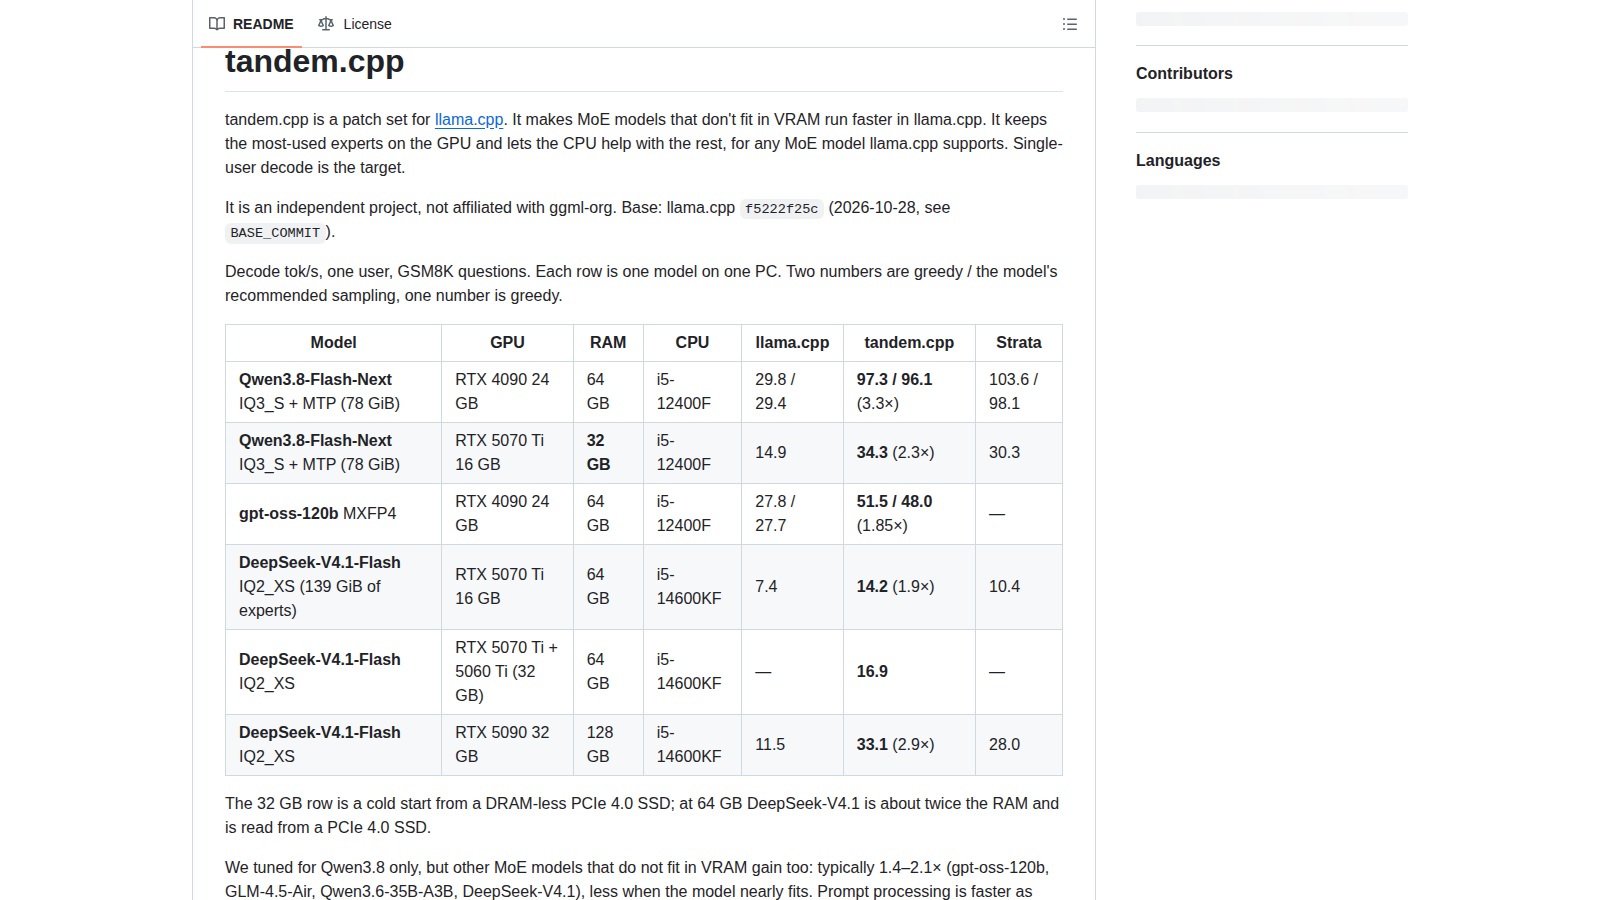
In breve: tandem.cpp è una patch indipendente per eseguire modelli MoE più grandi della VRAM, usando una cache GPU e il contributo della CPU. La build HIP/ROCm è documentata; il launcher tandem-run.py resta limitato a Linux con NVIDIA. Non è un aggiornamento ufficiale di llama.cpp né un benchmark indipendente. tandem.cpp: repository e README al commit verificato.
Verifica documentale del repository e del commit 8fba592242860c1dcb002dd1a8e84f66f073d0a9. Nessuna compilazione, inferenza o misura su GPU eseguita in questo ciclo. I confronti di velocità appartengono agli autori e non sono risultati di Francesco.
Che cosa cambia rispetto a llama.cpp normale?
La differenza è nella collocazione e nell’esecuzione degli esperti MoE. Il progetto mantiene in VRAM una cache degli esperti richiesti più spesso; quando un esperto manca, il lavoro viene ripartito fra CPU e caricamento sulla GPU. Il target dichiarato è la generazione per un solo utente, non un servizio con molte sessioni concorrenti. Gli autori indicano come base il commit llama.cpp f5222f25c del 28 ottobre: non va confusa con l’ultima prerelease upstream.
tandem.cpp: repository e README al commit verificato.
Il supporto AMD comprende anche il launcher?
No. Il README presenta istruzioni di compilazione HIP e abilita i grafi HIP, con GPU_TARGETS da adattare alla scheda. Descrive una prova degli autori su RX 7900 XTX, ma specifica che tandem-run.py supporta Linux e NVIDIA. Su AMD bisogna quindi distinguere il percorso manuale documentato dalla scelta automatica delle opzioni. La presenza del comando di build non prova che funzioni su qualsiasi scheda o installazione ROCm.
tandem.cpp: repository e README al commit verificato.
Che cosa sappiamo del commit del 14 novembre?
Il commit 8fba592242860c1dcb002dd1a8e84f66f073d0a9 è registrato il 14 novembre alle 18:11 UTC, cioè alle 19:11 italiane. Il README associato descrive modifiche nel codice condiviso CUDA/HIP per il ritorno dei risultati di routing, il mixing e le copie di stato, ma usa il titolo datato 15 novembre. È una discrepanza di etichetta da conservare, non un motivo per spostare la data del commit. L’endpoint release consultato non elenca release del progetto: qui si descrive codice versionato, non una versione stabile certificata.
tandem.cpp: repository e README al commit verificato · Commit del 14 novembre: modifiche CUDA/HIP e README · API GitHub: inventario delle release consultato.
Come impostare un confronto che abbia senso?
La prova proposta deve usare lo stesso modello quantizzato, gli stessi prompt e la stessa configurazione di decoding nei due percorsi. Va registrato se il modello entra nella RAM o richiede letture da SSD, insieme al contesto, al tempo del primo token e alla velocità di generazione. La modalità --fast del launcher è descritta come approssimata: non andrebbe confrontata con un percorso esatto senza dichiararlo. Un numero di token al secondo, da solo, non dimostra qualità equivalente né vantaggi sul proprio PC.
tandem.cpp: repository e README al commit verificato.
Checklist pratica proposta
- Conservare il commit della patch e il commit base di llama.cpp, senza applicarla al ramo mobile main alla cieca.
- Annotare GPU, VRAM, RAM, CPU, SSD, sistema operativo e versione CUDA o ROCm prima della prova.
- Su AMD seguire il percorso manuale HIP documentato; non attribuire al launcher il supporto ROCm.
- Usare un modello di cui si possiedano i diritti e controllare separatamente la sua licenza e lo spazio necessario.
- Confrontare gli stessi prompt, quantizzazione, contesto e decoding; distinguere modalità esatta e approssimata.
- Salvare output, tempo del primo token, velocità e letture da SSD; non estendere un test a tutti i modelli MoE.
Condizioni e limitazioni
Lo snapshot è del 14 novembre, ma il README intitola la sezione nuova 15 novembre. Build ROCm documentata, non provata qui; launcher solo Linux/NVIDIA e risultati dipendenti da CPU, RAM, SSD e modello.
Modelli AI locali: come scegliere LLM, hardware e runtime