
L’ANALISI
llama.cpp: Qwen2.5-VL e scale NVFP4
llama.cpp corregge tre scale FFN nel grafo Qwen2.5-VL con pesi NVFP4. Il commit è nel tag b12385; i risultati sono prove degli autori.
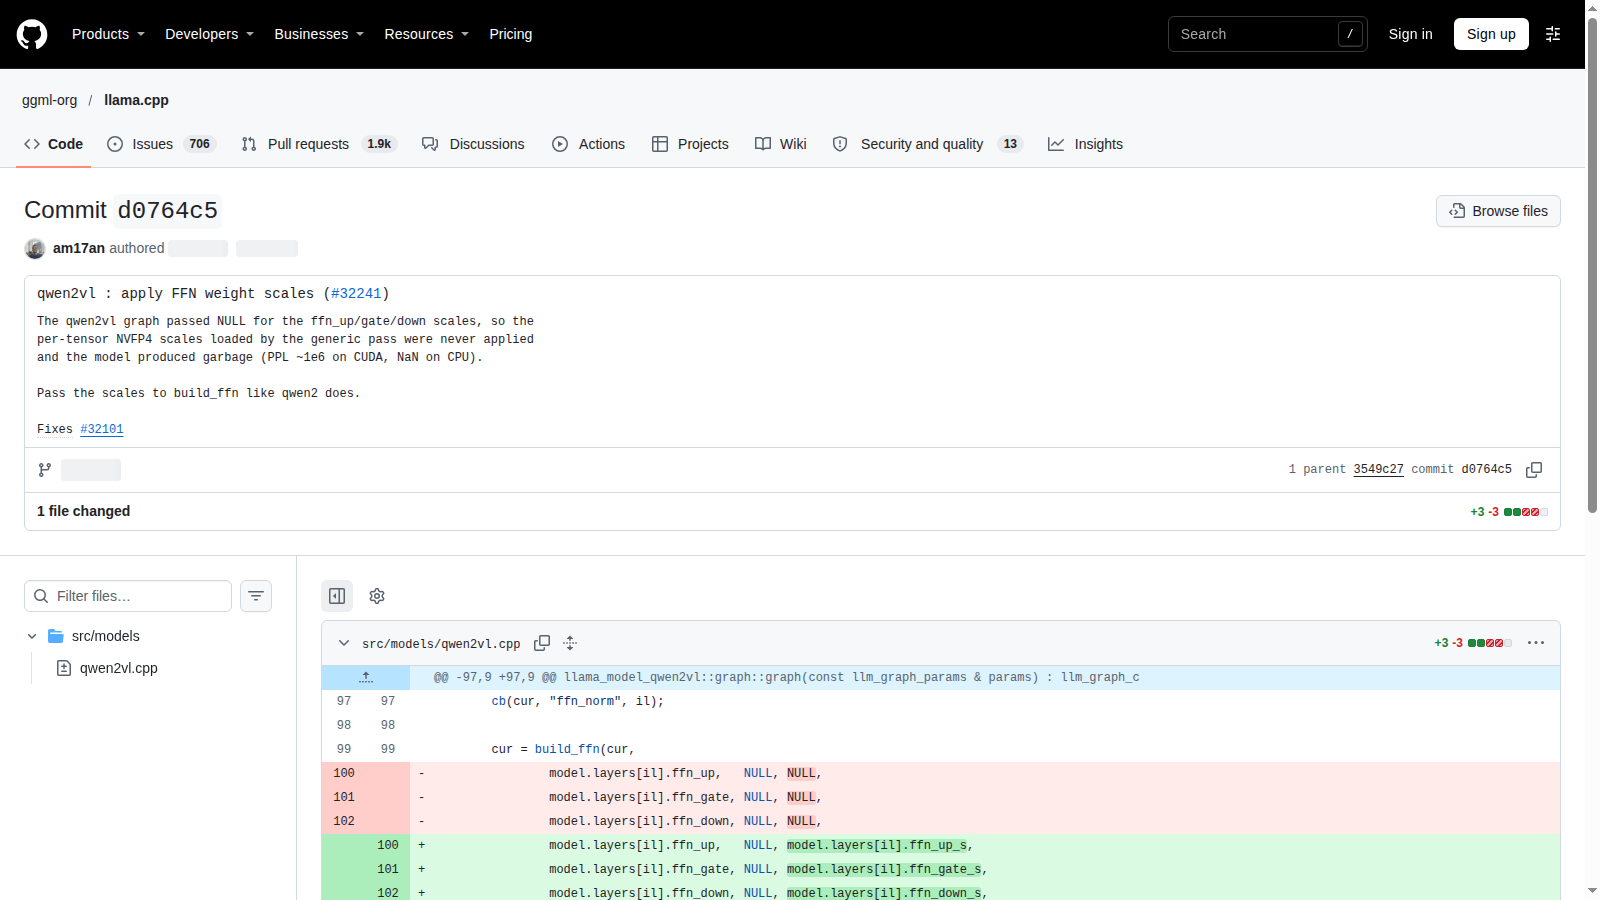
In breve: La correzione llama.cpp del 14 novembre collega tre scale FFN NVFP4 al grafo qwen2vl. L’autore segnala output privi di senso prima del fix e risultati di perplexity coerenti dopo, per uno specifico Qwen2.5-VL. Il commit è verificato e il tag b12385 vi punta; non lo presentiamo come una release stabile confermata dall’API. llama.cpp: commit d0764c5 e diff della correzione.
Verificati PR, issue, diff del commit e riferimento Git b12385 il 14 novembre 2026. L’API releases/tags/b12385 ha restituito 404 mentre il riferimento Git esiste. Nessuna conversione, compilazione o misura di perplexity è stata eseguita qui; i numeri tecnici restano quelli dichiarati dagli autori.
Quale errore viene corretto?
Nel file qwen2vl.cpp il loader poteva aver caricato le scale per-tensor NVFP4, ma il grafo passava NULL per tre argomenti di build_ffn. Il diff sostituisce quei valori con ffn_up_s, ffn_gate_s e ffn_down_s. L’autore collega il problema al modello nvidia/Qwen2.5-VL-7B-Instruct-NVFP4 convertito in GGUF. Il punto pratico è la correttezza del calcolo: l’avvio senza errore non dimostra che le scale necessarie siano applicate.
llama.cpp: commit d0764c5 e diff della correzione · PR 32241: condizioni e risultati dichiarati.
Che cosa dimostrano le prove pubblicate?
La PR descrive prove dell’autore su GB10, con un modello convertito dal repository Hugging Face e wikitext-2. Riporta perplexity molto elevata o non numerica prima della modifica e valori intorno a 9 dopo. La perplexity più bassa è favorevole in quel confronto controllato, ma non misura velocità o qualità multimodale generale. Non usiamo quei risultati come benchmark indipendente, né li trasferiamo a un altro modello, conversione o dispositivo.
PR 32241: condizioni e risultati dichiarati.
Il tag b12385 è una release stabile?
Il riferimento Git b12385 restituito dall’API punta esattamente al commit d0764c5ee23a889680147c9342d2b9002cb87b82. Nella stessa verifica l’endpoint REST della release non ha restituito un oggetto disponibile. Perciò distinguiamo il codice e il tag verificati dalla pubblicazione dei pacchetti. Chi deve riprodurre il fix può registrare il commit; chi distribuisce binari deve prima controllare l’effettiva provenienza e revisione del proprio artefatto, senza dedurle dal solo nome del tag.
llama.cpp: commit d0764c5 e diff della correzione · GitHub API: riferimento Git del tag b12385.
Come validare un aggiornamento senza confondere i risultati?
La prova proposta mantiene lo stesso GGUF, dataset e parametri e cambia soltanto la revisione del runtime. Salvare checksum del modello, comando completo e log di entrambi i percorsi. Eseguire prima una generazione breve, poi una misura ripetibile come quella documentata dalla PR, separando CPU e CUDA. Se si vogliono misurare anche tempi e memoria, registrarli come una seconda domanda sperimentale. Questa nota non dimostra un test su hardware locale o su un’applicazione mobile.
llama.cpp: commit d0764c5 e diff della correzione · PR 32241: condizioni e risultati dichiarati.
Checklist pratica proposta
- Accertare che il proprio modello usi il percorso qwen2vl e scale NVFP4 pertinenti.
- Registrare commit del runtime e checksum del GGUF.
- Tenere invariati dataset e parametri nel confronto prima e dopo.
- Controllare output e log, non soltanto l’assenza di errori al caricamento.
- Separare CPU e CUDA e conservare anche eventuali risultati non numerici.
- Verificare i binari realmente distribuiti senza equiparare tag Git e release stabile.
Condizioni e limitazioni
La modifica riguarda qwen2vl ed è documentata su un modello e configurazioni specifici. Non dimostra una correzione di tutte le architetture NVFP4 né un miglioramento di velocità; release REST non confermata.
Modelli AI locali: come scegliere LLM, hardware e runtime