
L’ANALISI
llama.cpp: CUDA integra OCP FP8, con limiti precisi
llama.cpp integra OCP FP8 nel backend CUDA con la PR 28413. Il merge è verificato; MoE e parte del prefill restano fuori dal cambiamento.
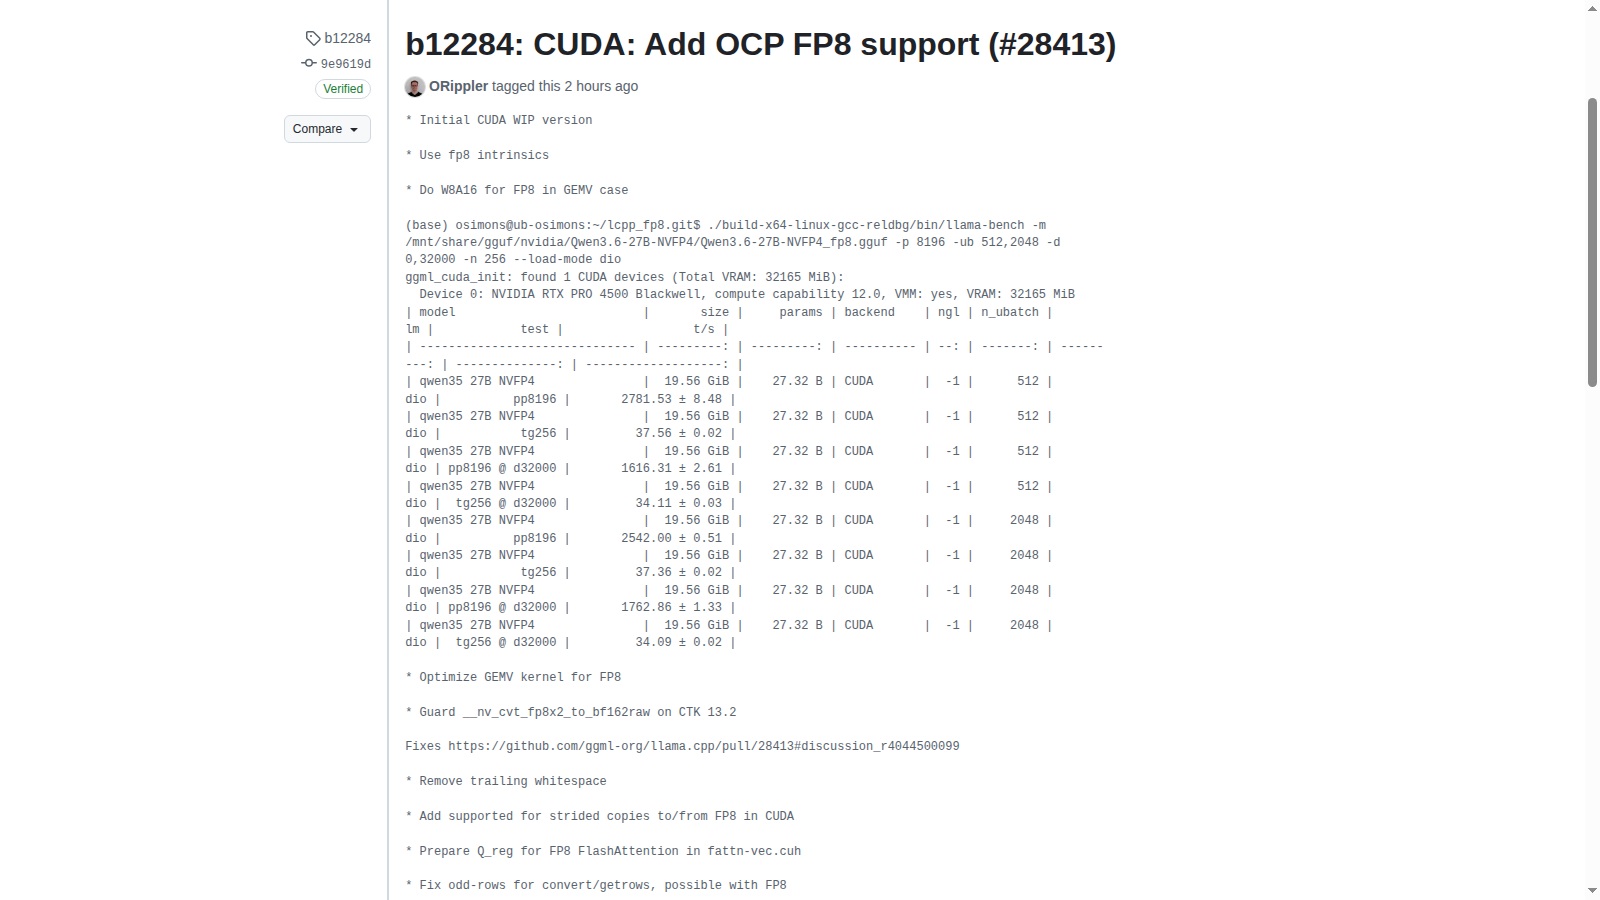
In breve: Il delta verificato è il supporto OCP FP8 nel backend CUDA, non un nuovo modello né una garanzia di velocità. Va distinto dalla cache KV FP8 già introdotta in b12274: formato dei pesi, cache e operazioni accelerate sono verifiche separate. llama.cpp, PR 28413: supporto OCP FP8 in CUDA.
Verifica documentale di PR, file modificati e pagina del tag. Nessuna compilazione CUDA, esecuzione del modello o replica dei benchmark dell’autore. Il merge è dell’11 novembre; l’apertura della PR a settembre non è la data del rilascio.
Che cosa è stato integrato?
La PR chiusa e unita al ramo principale identifica il commit 9e9619d030bbe6b584d826a0a6cf06e38251f52b. Per decidere un aggiornamento conviene fissare quel commit: la presenza di una pagina del tag non equivale alla conferma di una release REST stabile o di binari adatti al proprio sistema.
llama.cpp, PR 28413: supporto OCP FP8 in CUDA · Pagina ufficiale del tag b12284.
Quali operazioni restano fuori?
L’autore rimanda a modifiche successive i kernel MoE, l’uso nativo FP8 nel percorso a tile durante il prefill e parte della gestione della precisione di accumulo. Non basta quindi trovare FP8 nel nome di un file per dedurre che ogni sua operazione segua lo stesso percorso CUDA.
llama.cpp, PR 28413: supporto OCP FP8 in CUDA.
Come distinguere pesi, cache e prestazioni?
Una prova proposta deve tenere separati il formato dei pesi, il tipo della cache KV e il kernel effettivamente usato. Cambiarli insieme rende difficile attribuire un risultato. Chi ha già letto la notizia sulla cache FP8 non sta leggendo lo stesso delta: qui cambia il supporto del backend CUDA.
llama.cpp, PR 28413: supporto OCP FP8 in CUDA · File e modifiche della PR CUDA FP8.
Come impostare una verifica riproducibile?
Protocollo proposto, non eseguito: conservare la build precedente, usare lo stesso checkpoint e lo stesso prompt, registrare GPU, driver, toolkit e opzioni. Separare caricamento, prefill e generazione; confrontare memoria ed errori oltre ai token al secondo. Controllare anche l’output su un piccolo insieme di richieste fissato prima della prova.
Checklist pratica proposta
- Fissare commit e hash del checkpoint, senza sostituire automaticamente la build funzionante.
- Annotare GPU, driver, toolkit CUDA e log del backend effettivamente caricato.
- Tenere identici prompt, contesto, batch e numero di token nei confronti.
- Misurare separatamente prefill, generazione e memoria; registrare anche i fallimenti.
- Verificare gli output e conservare un ritorno alla versione precedente.
Condizioni e limitazioni
Nessun test locale eseguito. I numeri della PR appartengono alla configurazione dell’autore; kernel MoE e parte del prefill sono rinviati. Il 404 REST non autorizza a chiamare b12284 release stabile.
Per confrontare il metodo: llama.cpp: cache KV FP8 in b12274, supporto e limiti.