
L’ANALISI
llama.cpp: cache KV FP8 in b12274, supporto e limiti
llama.cpp b12274 introduce la cache KV FP8 l’11 novembre 2026. Scale opzionali e prerelease: nessuna garanzia generale su RAM o velocità.
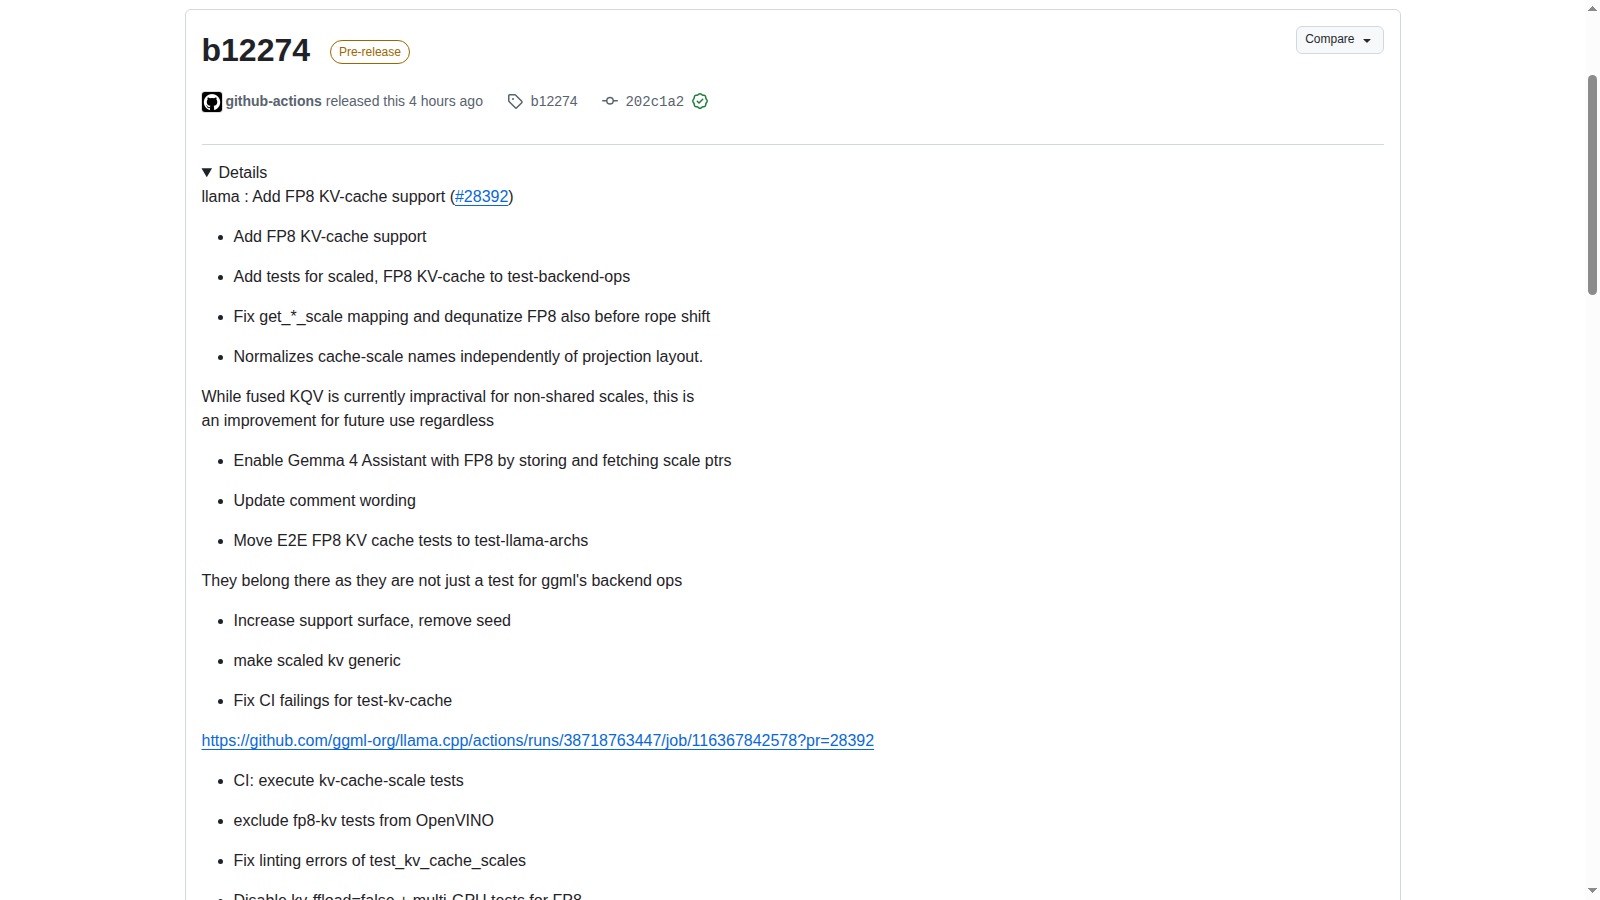
In breve: llama.cpp b12274, pubblicata l'11 novembre 2026 alle 02:52:55 UTC e marcata prerelease, aggiunge il supporto alle cache KV OCP FP8 con scale statiche per tensore opzionali, gestite a runtime. La PR 28392 era stata integrata il 10 novembre: merge e pubblicazione non sono la stessa data. La novità non garantisce meno RAM totale o più velocità su qualunque configurazione. llama.cpp b12274: FP8 KV-cache, modifiche e note sui test.
Revisione documentale dell'11 novembre 2026: GET della release, dei metadati GitHub e della PR 28392, confrontati con le copie primarie recenti. Verificati published_at, stato prerelease e corrispondenza tra target_commitish della release e merge_commit_sha della PR. Nessun download dei pesi, installazione, inferenza o benchmark eseguito.
La novità è del 10 o dell'11 novembre?
In breve: b12274 è pubblicata l'11 novembre alle 02:52:55 UTC; è marcata prerelease; include il supporto FP8 KV-cache della PR 28392; il merge risale al 10 novembre alle 16:08:33 UTC. Il commit indicato dalla release coincide con quello del merge. Per questa notizia uso la data di pubblicazione della release, non created_at né il giorno in cui il codice è entrato nel ramo. La distinzione permette di raccontare il cambiamento disponibile in quella build senza retrodatare la distribuzione o trasformare il controllo odierno in un nuovo rilascio.
llama.cpp b12274: FP8 KV-cache, modifiche e note sui test · API GitHub: release pubblicata l'11 novembre 2026 alle 02:52:55 UTC, prerelease true · PR 28392: supporto OCP FP8 e scale opzionali della cache KV, merge del 10 novembre 2026.
Che cosa introduce FP8 nella cache KV?
La PR descrive cache KV basate su OCP FP8 e scale statiche per tensore opzionali, gestite a runtime. Lo scaling viene applicato nel grafo, senza modificare ggml_flash_attn_ext; l'obiettivo dichiarato è condividere la logica tra percorsi di attenzione. Il punto utile per chi integra è che non si tratta di rinominare la quantizzazione dei pesi: la modifica riguarda la rappresentazione della cache e la gestione delle scale. Prima di confrontare due esecuzioni proporrei quindi di registrare separatamente formato dei pesi, formato della cache e metadati di scaling.
llama.cpp b12274: FP8 KV-cache, modifiche e note sui test · PR 28392: supporto OCP FP8 e scale opzionali della cache KV, merge del 10 novembre 2026.
Si può già promettere meno memoria e più velocità?
No: queste fonti attestano un supporto software, non una misura universale dell'esecuzione. Non userei la sigla FP8 per promettere che tutta la memoria del processo diminuisca nella stessa proporzione o che ogni richiesta acceleri. La domanda da valutare sarebbe quanto pesi la cache nella specifica configurazione, insieme al costo del percorso che la usa. Un confronto proposto dovrebbe tenere fissi modello, contesto, backend e carico, registrando sia memoria sia qualità dell'output. Finché quel confronto non viene eseguito, il vantaggio resta un'ipotesi operativa, non un risultato di questo articolo.
llama.cpp b12274: FP8 KV-cache, modifiche e note sui test · PR 28392: supporto OCP FP8 e scale opzionali della cache KV, merge del 10 novembre 2026.
Che cosa dicono davvero i test e le esclusioni nel changelog?
La PR elenca prove su conversione, caricamento, spostamenti del contesto e correttezza delle scale. Il changelog della release menziona anche esclusioni di test FP8 per OpenVINO, alcune configurazioni multi-GPU e modelli che consumano direttamente la cache. Non abbiamo esaminato ogni job CI né riprodotto quelle prove. Leggerei perciò queste righe come segnali del perimetro da approfondire: un'esclusione di test non certifica il funzionamento e, da sola, non dimostra neppure che un backend sia sempre inutilizzabile. La marcatura prerelease rende ancora più importante evitare estrapolazioni a configurazioni non documentate.
llama.cpp b12274: FP8 KV-cache, modifiche e note sui test · API GitHub: release pubblicata l'11 novembre 2026 alle 02:52:55 UTC, prerelease true · PR 28392: supporto OCP FP8 e scale opzionali della cache KV, merge del 10 novembre 2026.
Come valuterei FP8 KV-cache: procedura proposta
Fisserei una revisione e un modello compatibile dichiarato dal progetto, poi preparerei un confronto con la stessa configurazione e un formato di cache di riferimento. Separerei caricamento, generazione breve, contesto lungo e spostamenti del contesto, controllando eventuali errori prima delle prestazioni. Annoterei scale, backend, dispositivo e impostazioni effettive, quindi validerei risposte su compiti sintetici ripetibili. Solo dopo proporrei misure di memoria e tempi sull'hardware destinato all'uso. La procedura non è stata eseguita: qui la conferma riguarda la presenza della modifica nei documenti ufficiali di b12274.
API GitHub: release pubblicata l'11 novembre 2026 alle 02:52:55 UTC, prerelease true · PR 28392: supporto OCP FP8 e scale opzionali della cache KV, merge del 10 novembre 2026.
Checklist pratica
- Procedura proposta, non eseguita: fissare revisione, modello, backend e dispositivo del confronto.
- Distinguere formato dei pesi, formato della cache KV e presenza delle scale.
- Accertare il supporto della configurazione specifica, senza dedurlo dalla sola disponibilità di un binario.
- Separare prove di caricamento, contesto lungo e spostamenti del contesto.
- Confrontare qualità, memoria e tempi con impostazioni identiche prima di dichiarare un vantaggio.
- Mantenere espliciti stato prerelease, esclusioni documentate e differenza tra merge del 10 e release dell'11 novembre.
Condizioni e limitazioni
Non abbiamo verificato la disponibilità operativa di FP8 per ogni architettura o backend. Il changelog contiene esclusioni di test e modifiche per casi specifici: non è una matrice universale di supporto. Memoria complessiva, latenza, throughput e qualità non sono stati misurati qui; i test citati nelle fonti appartengono al progetto.