
L’ANALISI
llama.cpp: che cosa cambia su iGPU e Intel Arc
llama.cpp distingue tre modifiche: fallback mmap sulle iGPU, SDPA per Arc A-series e toolchain SYCL. I test degli autori non sono generali.
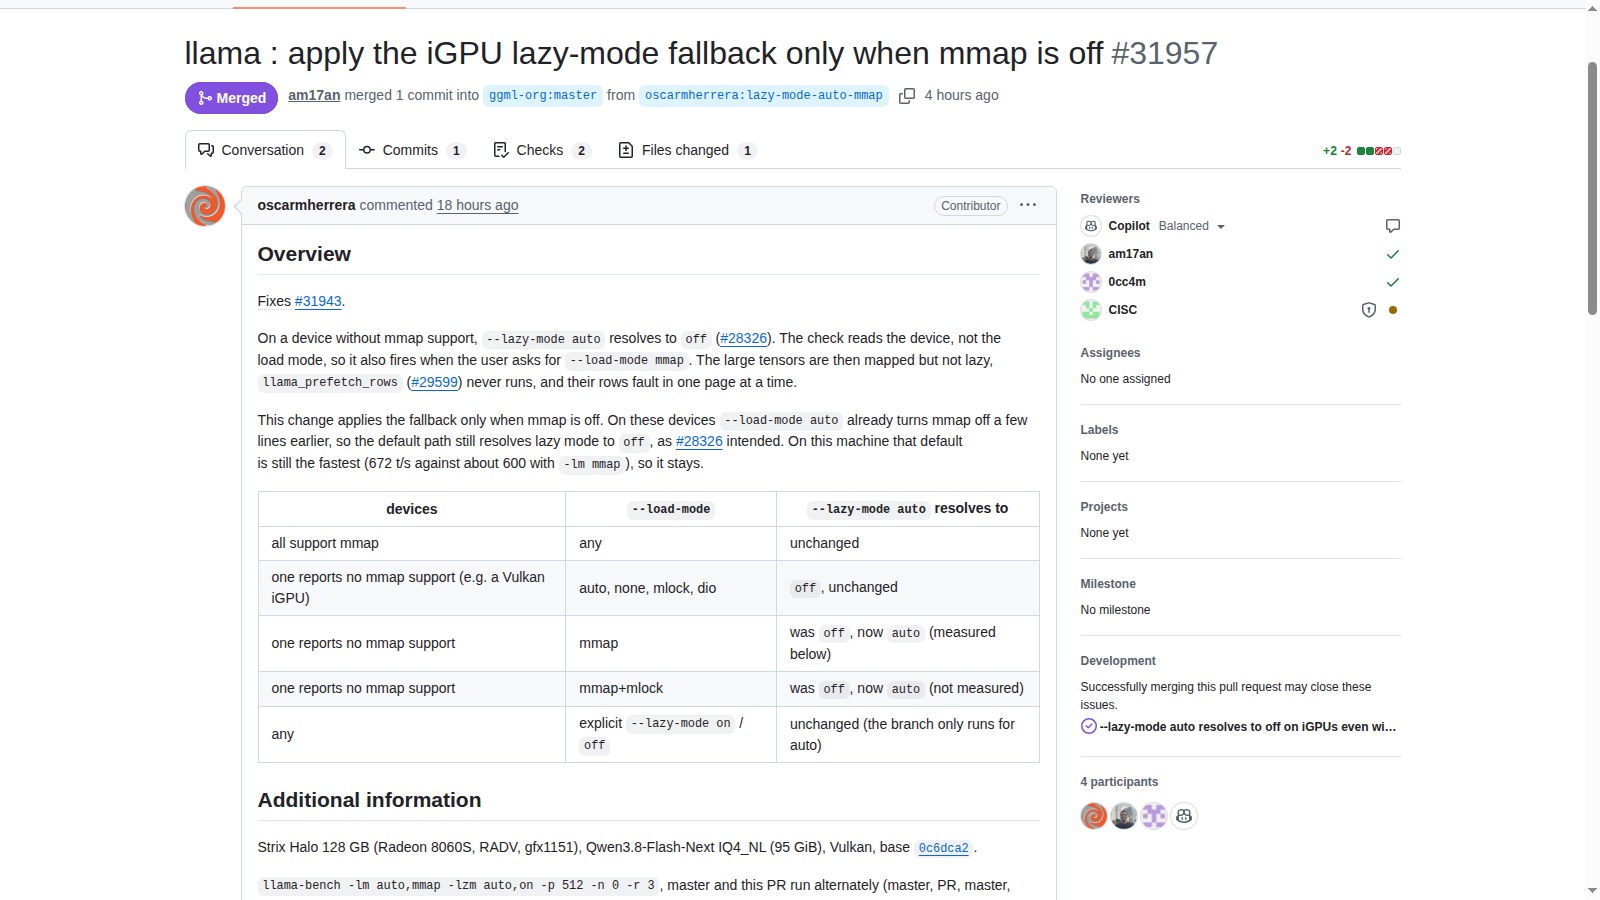
In breve: Le modifiche a llama.cpp sono tre e non vanno confuse: una corregge il fallback lazy-mode quando mmap è richiesto, una riapre uno specifico percorso SDPA sulle Arc A-series e una aggiorna la toolchain Intel. Nessuna dimostra che tutti i modelli o tutte le GPU siano più veloci. llama.cpp PR 31957: fallback iGPU e mmap.
Analisi delle tre pull request unite e delle release REST ufficiali il 10 novembre 2026. Nessun benchmark hardware eseguito per questa pagina; tutte le misure citate restano prove degli autori nei rispettivi ambienti.
Quale caso iGPU viene corretto?
La PR 31957 limita il fallback che disattiva lazy-mode ai casi in cui mmap è spento. Quando si richiede mmap, il caricamento non viene più trattato come il percorso senza mmap soltanto perché il dispositivo dichiara di non supportarlo. Il percorso automatico predefinito resta invariato: la modifica non suggerisce di forzare mmap su ogni macchina.
llama.cpp PR 31957: fallback iGPU e mmap.
Quale limite viene rimosso sulle Intel Arc?
La PR 31574 rimuove l'esclusione oneDNN SDPA per Arc A-series con head_dim pari a 64. L'autore mantiene l'avvertenza sul vecchio stack Linux IGC e indica GGML_SYCL_FA_ONEDNN=0 come via di esclusione del percorso. Prima di interpretare un risultato vanno quindi registrati anche driver, runtime e forma del modello, non soltanto il nome della scheda.
llama.cpp PR 31574: SDPA su Intel Arc A-series.
Perché prompt e generazione vanno separati?
La PR 31540 aggiorna oneAPI, oneDNN e Level Zero. Nel confronto riportato su Arc B570 cambia l'elaborazione del prompt, mentre la velocità di generazione resta sostanzialmente uguale. Per una prova propria conviene conservare modello, quantizzazione, contesto e parametri identici e misurare le due fasi separatamente: un solo valore medio nasconderebbe il comportamento rilevante.
llama.cpp PR 31540: aggiornamento toolchain SYCL.
Come scegliere una build senza confondere tag e rilascio?
Le release REST verificate espongono b12243 e b12244 come prerelease; b12245 non risulta disponibile nello stesso controllo. Il merge è sufficiente a descrivere una modifica al codice, non a promettere un pacchetto scaricabile. Per una valutazione riproducibile salvare il commit o l'asset esatto e tenere pronto il binario precedente, senza aggiornare un servizio operativo soltanto per provare il titolo della notizia.
Release ufficiali llama.cpp e stato prerelease.
Checklist pratica
- Identificare backend, GPU, driver e runtime prima di scegliere il percorso pertinente.
- Fissare commit o build e controllare se l'asset è prerelease.
- Usare lo stesso modello, quantizzazione, contesto e carico nei confronti.
- Misurare prompt processing e generazione separatamente e dichiarare le ripetizioni.
- Tenere il test isolato e verificare il ritorno alla build precedente.
Condizioni e limitazioni
Il percorso iGPU predefinito auto resta invariato. Il caso Arc richiede attenzione ai vecchi runtime Linux. Nel confronto B570 dell'autore migliora il prompt processing, non la generazione. b12245 restituisce 404 nell'API verificata; b12243 e b12244 sono prerelease.