
L’ANALISI
llama.cpp e Gemma 4: audio streaming in ingresso
llama.cpp b12237 aggiunge lo streaming audio in ingresso per Gemma 4 con step di 480 ms. È distinto dalla sintesi vocale e resta una prerelease.
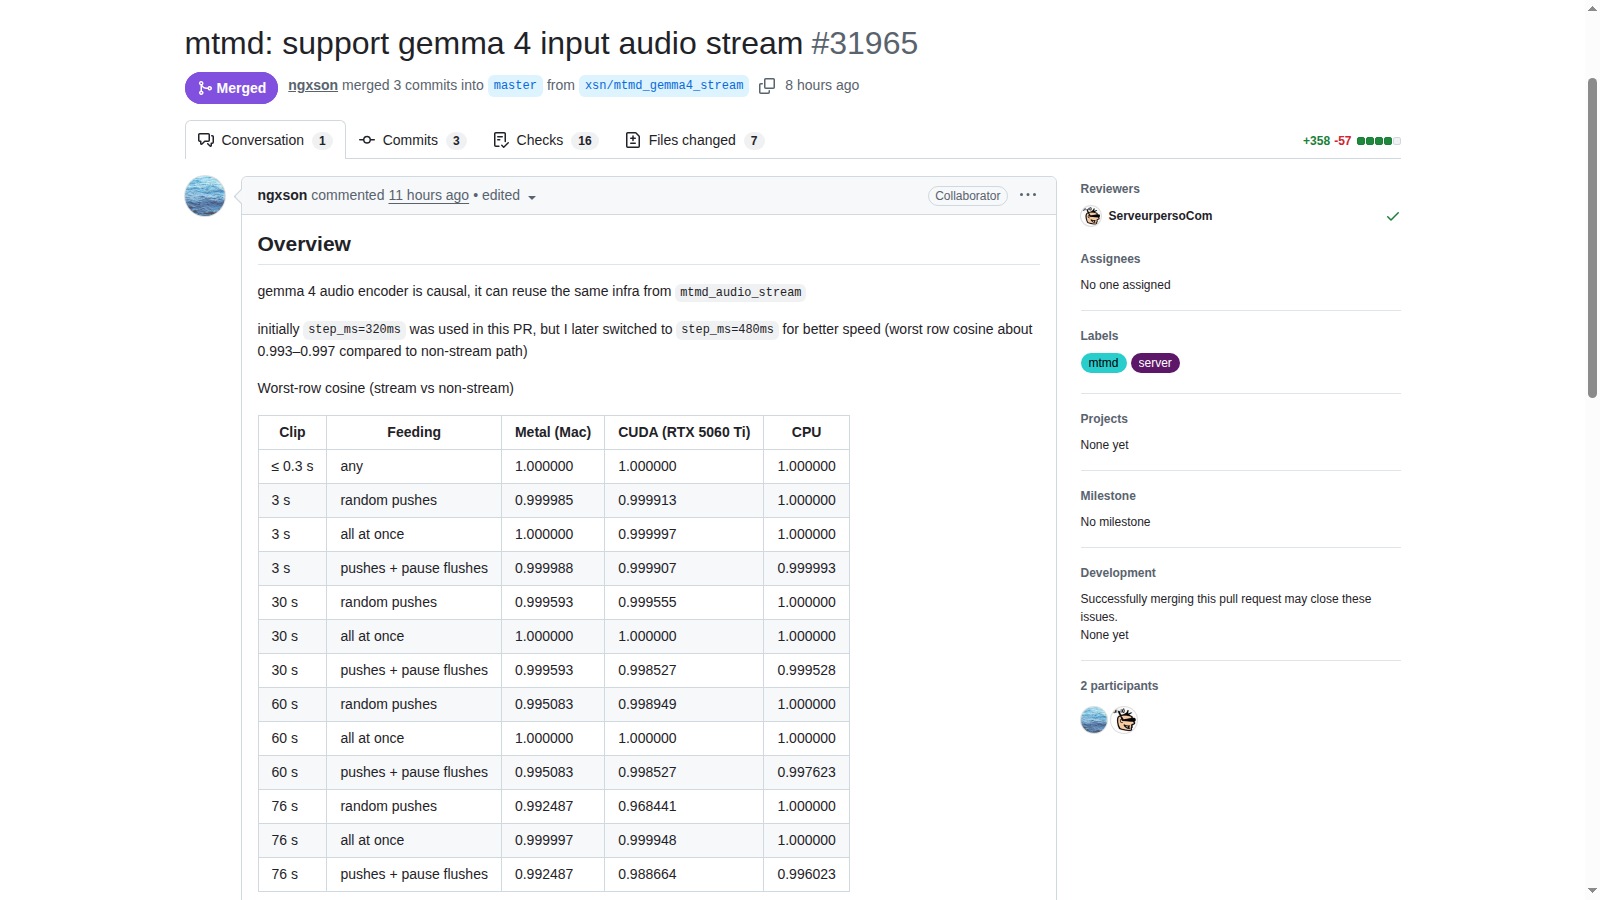
In breve: llama.cpp b12237 aggiunge lo streaming audio in ingresso per Gemma 4 e corregge un problema del primo batch nel percorso realtime. Lo step di 480 ms è un parametro di elaborazione del codice, non una latenza end-to-end garantita. llama.cpp: PR 31965, streaming audio Gemma 4.
Verificati PR 31965, merge e note della release b12237. Non eseguiti compilazione, prove realtime, trascrizione o benchmark audio indipendenti.
Audio in ingresso significa anche sintesi vocale?
No. La PR riguarda il percorso che alimenta il modello con audio in streaming e usa l’encoder causale di Gemma 4. È distinta dall’endpoint /v1/audio/speech aggiunto nella build successiva, che genera parlato a partire dal testo. Separare le due direzioni evita una promessa errata: avere un modello capace di ricevere audio non dimostra che lo stesso checkpoint possa produrre una voce. Configurazione, modello e prova devono seguire la funzione realmente richiesta.
llama.cpp: PR 31965, streaming audio Gemma 4 · llama.cpp b12237: note e stato della release.
Che cosa rappresentano i 480 millisecondi?
La descrizione racconta il passaggio da step di 320 ms a 480 ms per il percorso di elaborazione. Non è un tempo totale garantito fra ingresso del suono e risposta finale. La PR riporta confronti di similarità tra streaming e percorso non streaming su hardware e modalità di alimentazione diverse. Questi valori descrivono un confronto tecnico dell’autore, non un nostro benchmark e non una misura automatica della correttezza di ciò che il modello comprende.
llama.cpp: PR 31965, streaming audio Gemma 4 · llama.cpp b12237: note e stato della release.
Quale errore del server viene corretto?
Le note spiegano che lo slot realtime forzava le embeddings, marcando ogni riga del batch come output. Un modello chat con streaming audio, come Gemma 4 nel caso descritto, poteva abortire al primo batch perché non riservava gli output come un modello che genera audio. La correzione abilita le realtime embeddings soltanto per la generazione audio. È una distinzione tra percorsi del server, non una promessa di correzione per ogni possibile problema realtime.
llama.cpp b12237: note e stato della release.
Come separare funzionamento e qualità in una prova?
Fissare build, modello e backend e partire da clip brevi controllate. Registrare prima se il primo batch viene elaborato senza abortire; poi osservare il contenuto della risposta. In una fase separata confrontare alimentazione completa e a porzioni, mantenendo lo stesso audio e annotando pause e dimensione dei blocchi. Misurare la latenza dal punto realmente rilevante per l’utente, non ricavarla dal parametro step. Nessuna prova di questo tipo è stata eseguita per la presente analisi.
llama.cpp: PR 31965, streaming audio Gemma 4 · llama.cpp b12237: note e stato della release.
Condizioni e limitazioni
Build marcata prerelease, nessun audio elaborato qui. Le comparazioni numeriche della PR sono dell’autore e non misurano da sole comprensione, qualità della trascrizione o latenza dell’applicazione.
Checklist pratica
- Verificare modello, backend e build prima della prova.
- Distinguere audio ricevuto da audio generato.
- Controllare l’elaborazione del primo batch.
- Ripetere le stesse clip con alimentazione completa e a blocchi.
- Misurare la latenza reale senza usarla come sinonimo dello step di 480 ms.