
IL PUNTO SULL’AI
8 novembre 2026
NVIDIA e Rebellions pianificano prefill GPU e decode NPU per il 2028; llama.cpp aggiorna CPU e cache, llama-modchip corregge le route API.
In questa edizione 10 notizie
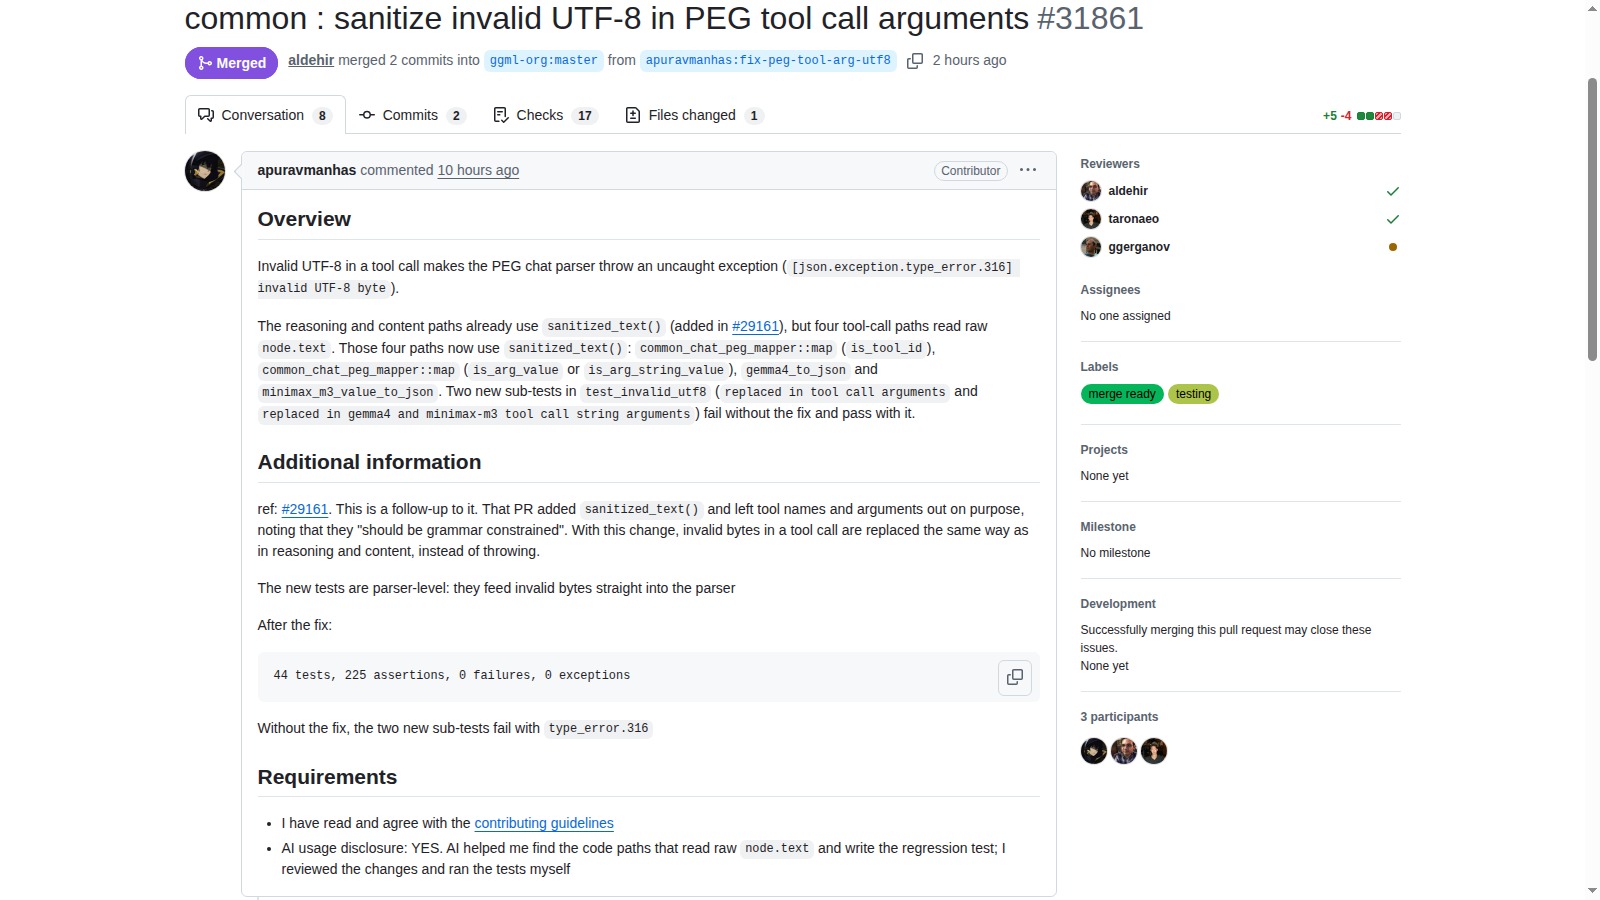
La prerelease b12199 dell'8 novembre corregge quattro percorsi del parser PEG che usavano testo grezzo nelle tool call. Byte UTF-8 non validi potevano provocare un'eccezione JSON non gestita. Il diff passa a sanitized_text(): è una correzione di robustezza, non un nuovo modello né uno speedup.
Limiti da conoscere
Limite: Lettura della prerelease, della pull request e del diff al merge 372dc5ca157276beb6c67b2e92477e8d662e964a. Nessuna compilazione o inferenza eseguita qui. I test dichiarati dal contributore non sono stati riprodotti; il diff acquisito contiene un solo file del parser. Nessuna classificazione CVE o gravità di sicurezza attribuita.
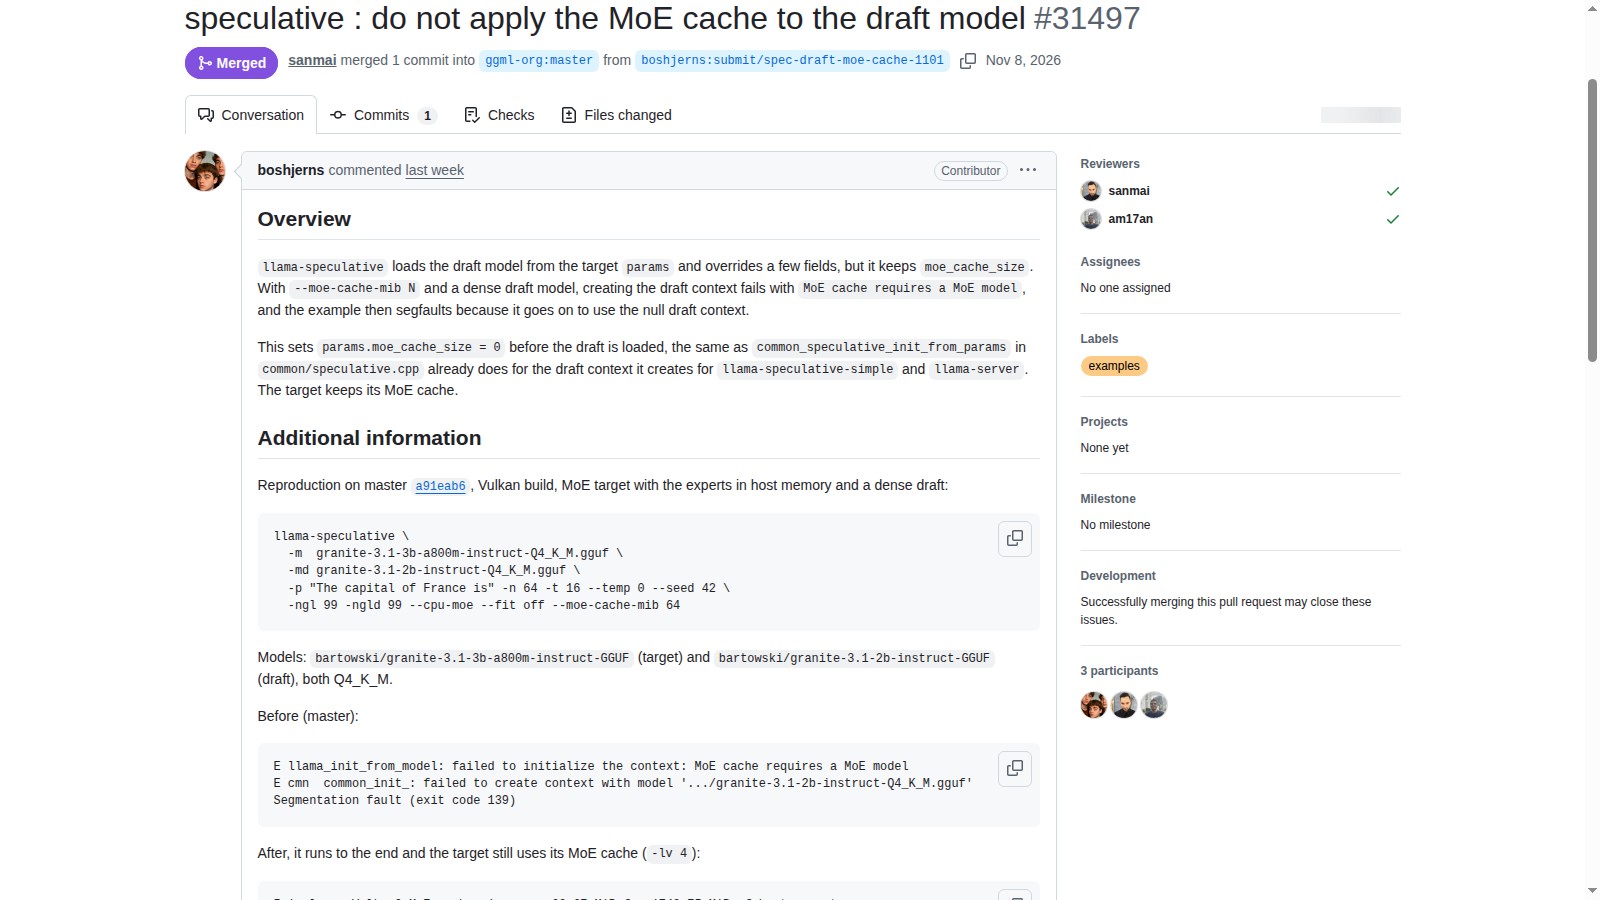
La prerelease b12201 corregge l'esempio llama-speculative quando un target MoE con cache abilitata viene affiancato da un draft denso. Prima di inizializzare il draft, il parametro moe_cache_size viene azzerato; la cache del target resta attiva. La pull request documenta un errore di inizializzazione seguito da un crash: non è un nuovo fix generale di llama-server.
Limiti da conoscere
Limite: Analisi documentale della prerelease e del diff al merge a2b301831d05b07860de508d229d430207127802. Nessuna compilazione o inferenza riprodotta. I log upstream usano Vulkan con Mesa llvmpipe: non sono una nostra prova su GPU fisica e non dimostrano uno speedup. Il nuovo accesso a GitHub ha restituito errori di rete; sono conservate le fonti primarie acquisite e verificate in mattinata.
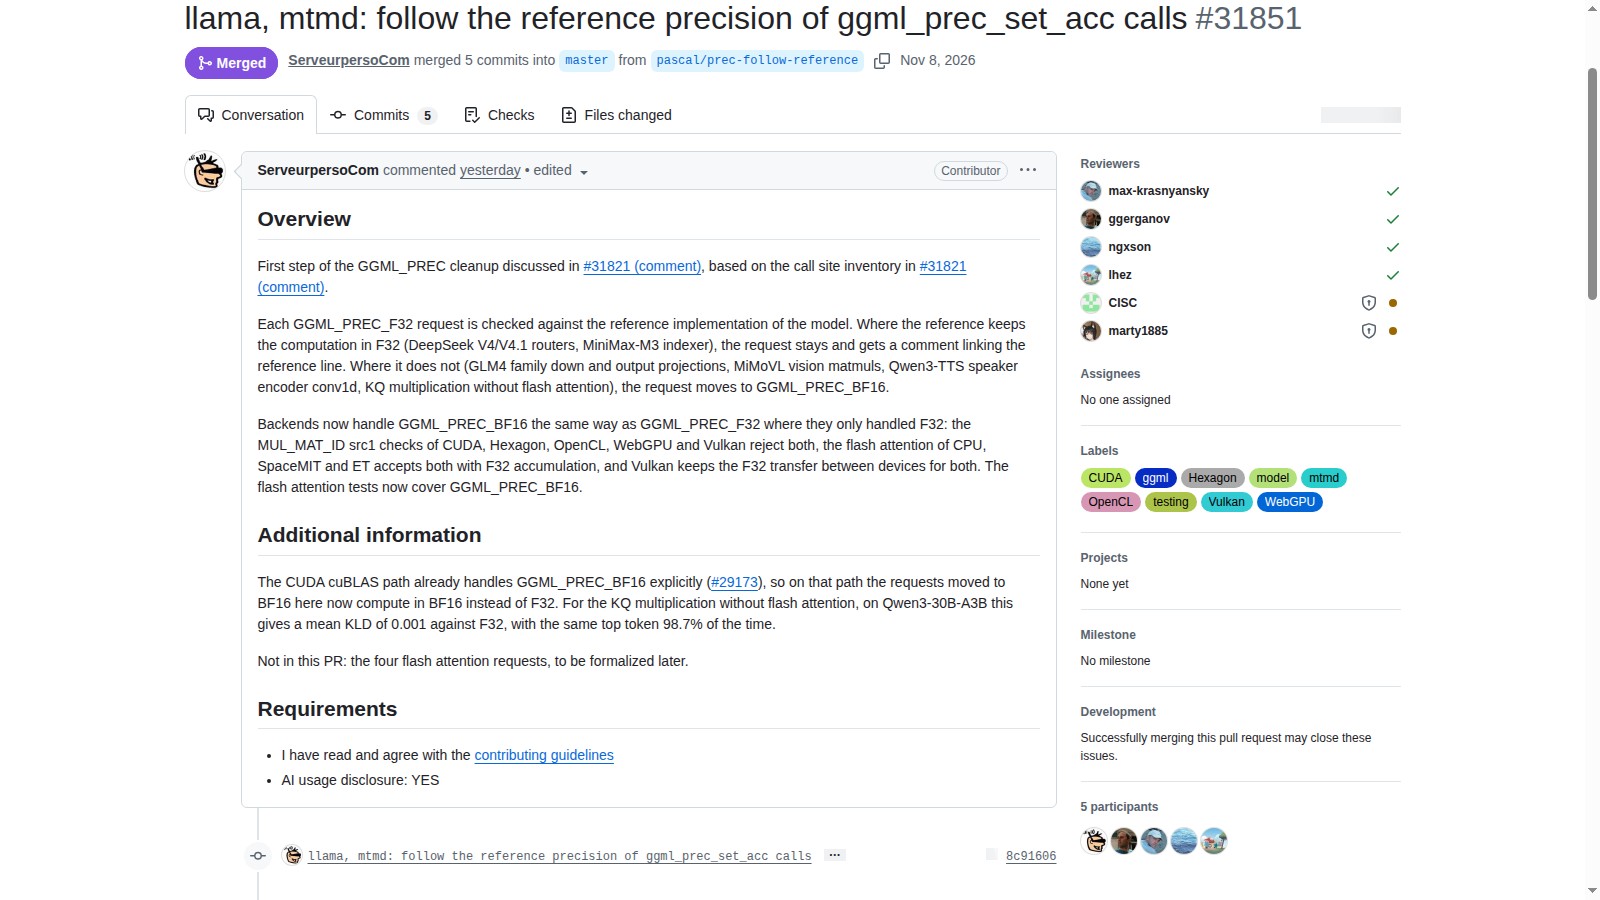
La prerelease b12202 allinea alcune richieste di precisione al codice di riferimento dei modelli: diversi punti passano da GGML_PREC_F32 a GGML_PREC_BF16. Il risultato dipende dal backend: la flash attention CPU continua a usare accumulazioni F32, mentre il percorso CUDA cuBLAS già distingue BF16. La patch aggiorna anche i controlli dei backend e i test.
Limiti da conoscere
Limite: Diff di 17 file e descrizione della pull request 31851 al merge d6be065572cdb7bf64014c8c5771e210c9570e44. Nessuna build o inferenza locale, nessuna equivalenza degli output o velocità dimostrata. La prerelease è uno stato dell'API acquisita in mattinata; alcuni readback HTML non erano allineati e il successivo accesso a GitHub ha restituito errori di rete. Il delta b12203 non è incluso in questa analisi.
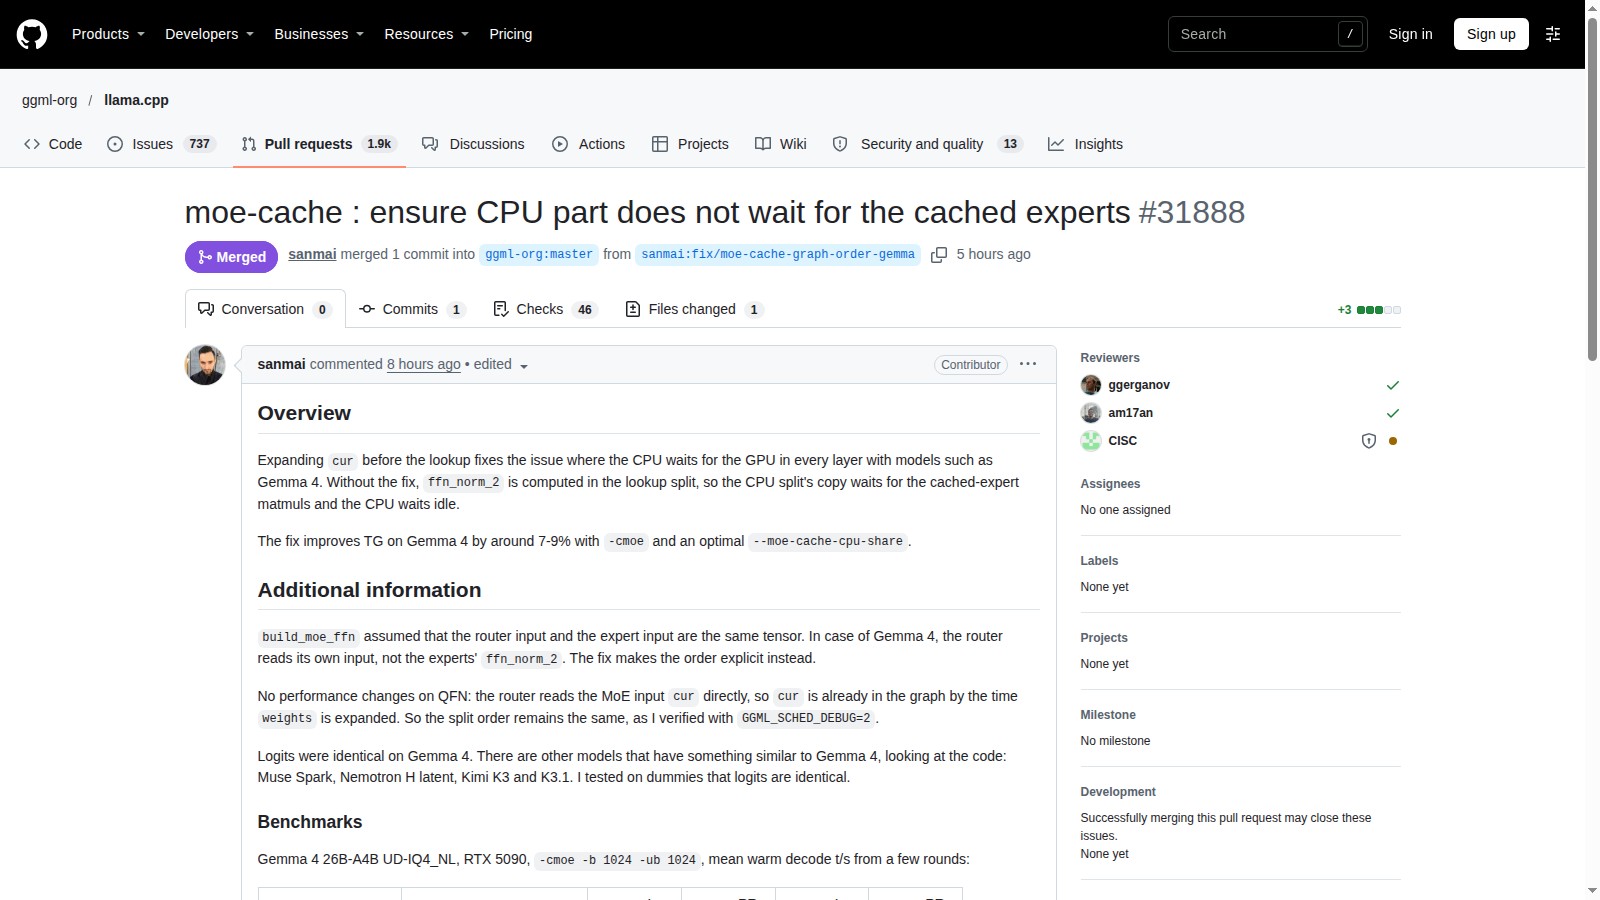
La prerelease b12206 corregge l’ordine del grafo nella cache MoE: l’input degli esperti viene espanso prima della ricerca degli slot. Serve a evitare un’attesa della parte CPU quando router ed esperti leggono tensori diversi, come nel caso Gemma 4 descritto nella PR. Il guadagno riportato dal contributore riguarda configurazioni specifiche, non ogni modello o GPU.
Limiti da conoscere
Limite: Il 7-9% è una stima del contributore per Gemma 4 con cache MoE e quota CPU opportunamente scelta, non un risultato locale o trasferibile ad altri sistemi. La PR riporta anche casi quasi invariati e nessun cambiamento nel confronto interamente GPU senza cache MoE. Non abbiamo eseguito compilazioni, inferenza o benchmark.
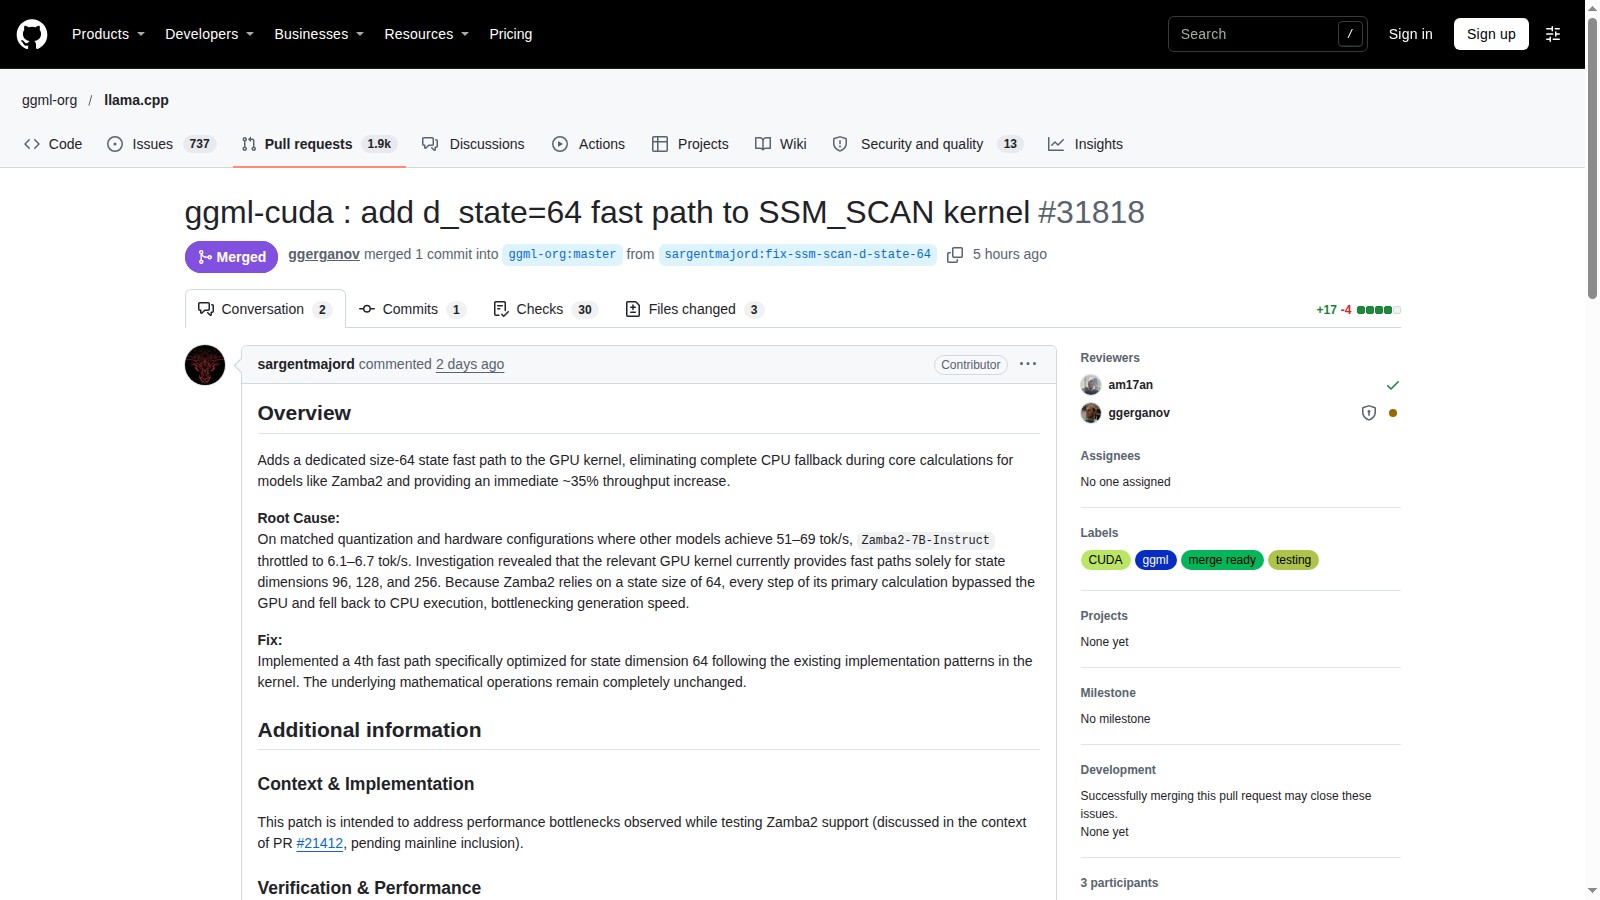
La prerelease b12207 aggiunge un percorso CUDA dedicato a SSM_SCAN con dimensione dello stato pari a 64, oltre ai casi già previsti. Il diff aggiorna il controllo di supporto, il lancio del kernel e tre casi di test. È una modifica a un operatore, non la prova che Zamba2 sia completamente supportato né che tutto il suo calcolo rimanga sulla GPU.
Limiti da conoscere
Limite: Un fast path del kernel non dimostra il supporto completo a Zamba2. Il contributore segnala ancora circa il 28% di operazioni interessate in fallback CPU nelle proprie prove. I 28 test superati e il passaggio da circa 11 a 15,1 token/s sono dichiarati nella PR, non replicati da noi; nessuna compilazione o inferenza locale eseguita.
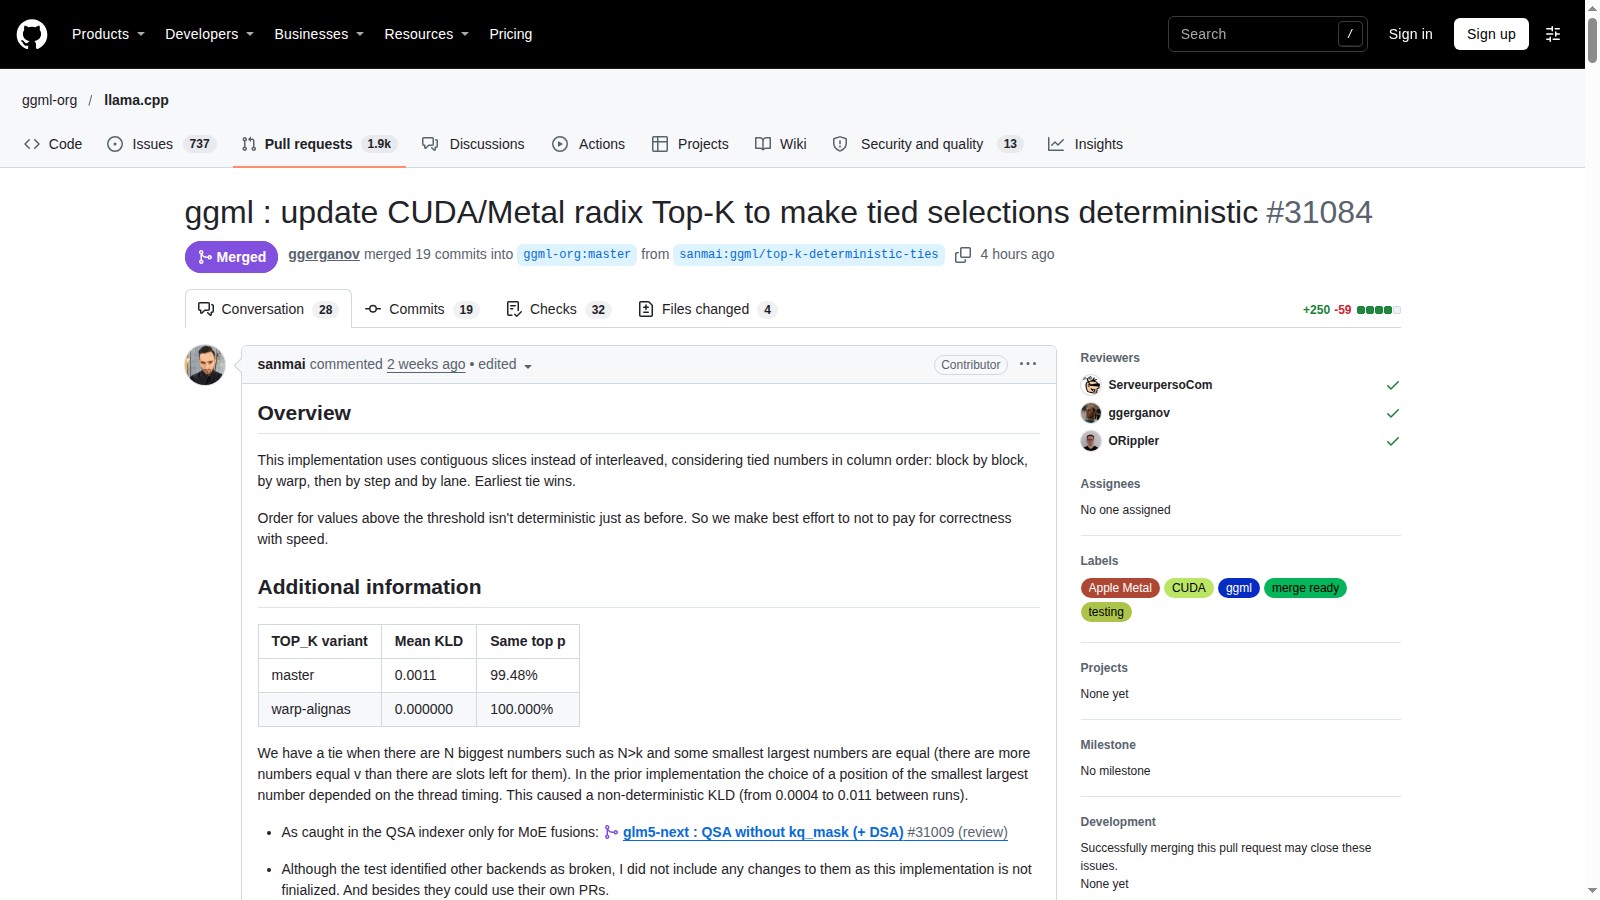
La prerelease b12208 corrisponde alla PR 31084 e rende deterministica la scelta dei candidati a pari valore nel percorso radix Top-K di CUDA e Metal. Il diff modifica quattro file e aggiunge un controllo di ripetibilità per backend selezionati. Restano eccezioni, fra cui il percorso CUDA DeviceTopK per poche righe: non è una garanzia di generazione identica fra esecuzioni o dispositivi.
Limiti da conoscere
Limite: Il perimetro è la selezione Top-K nei percorsi modificati, non tutta l’inferenza. CUDA può ancora usare DeviceTopK per una o due righe e mantenere pareggi non deterministici. Il test confronta insiemi di indici sullo stesso backend, non identità universale dell’ordine o dei byte fra backend; Vulkan e SYCL restano fuori dal controllo. Nessun test locale eseguito.
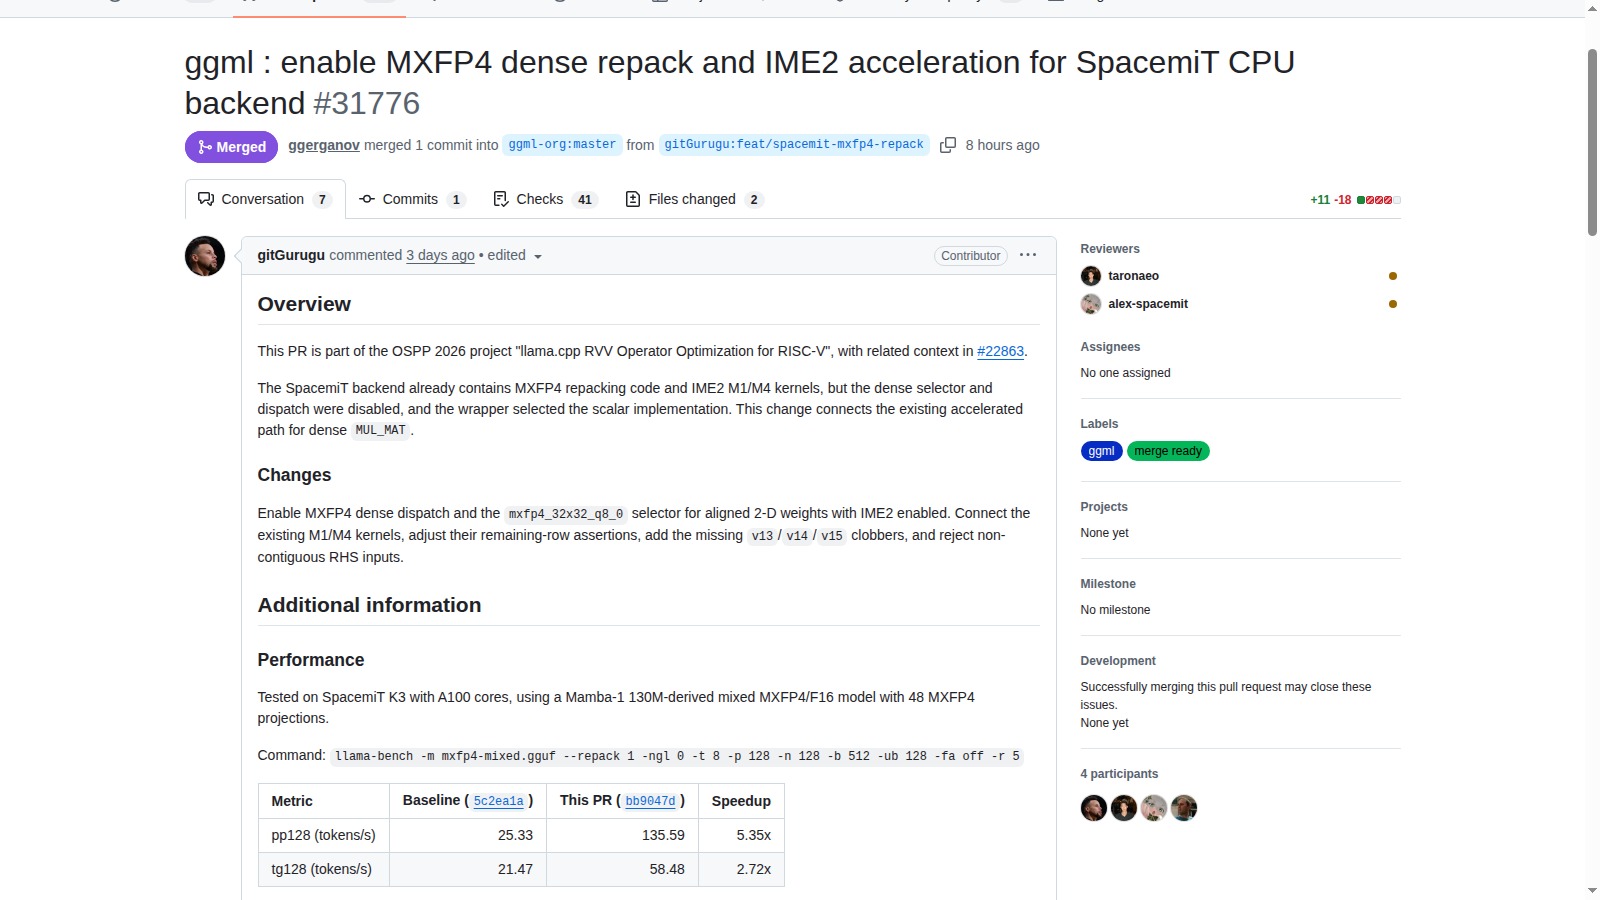
La prerelease b12210 collega il repack MXFP4 ai kernel IME2 già presenti nel backend SpacemiT per le moltiplicazioni dense. La selezione richiede pesi bidimensionali con entrambe le dimensioni multiple di 32 e IME2 abilitato. Il benchmark della PR riguarda uno specifico modello Mamba-1 derivato su SpacemiT K3: non dimostra un’accelerazione generale delle CPU.
Limiti da conoscere
Limite: Il test upstream usa SpacemiT K3 con core CPU A100, otto thread e un Mamba-1 130M derivato, misto MXFP4/F16. A100 qui non indica una GPU NVIDIA. Non abbiamo riprodotto il benchmark.
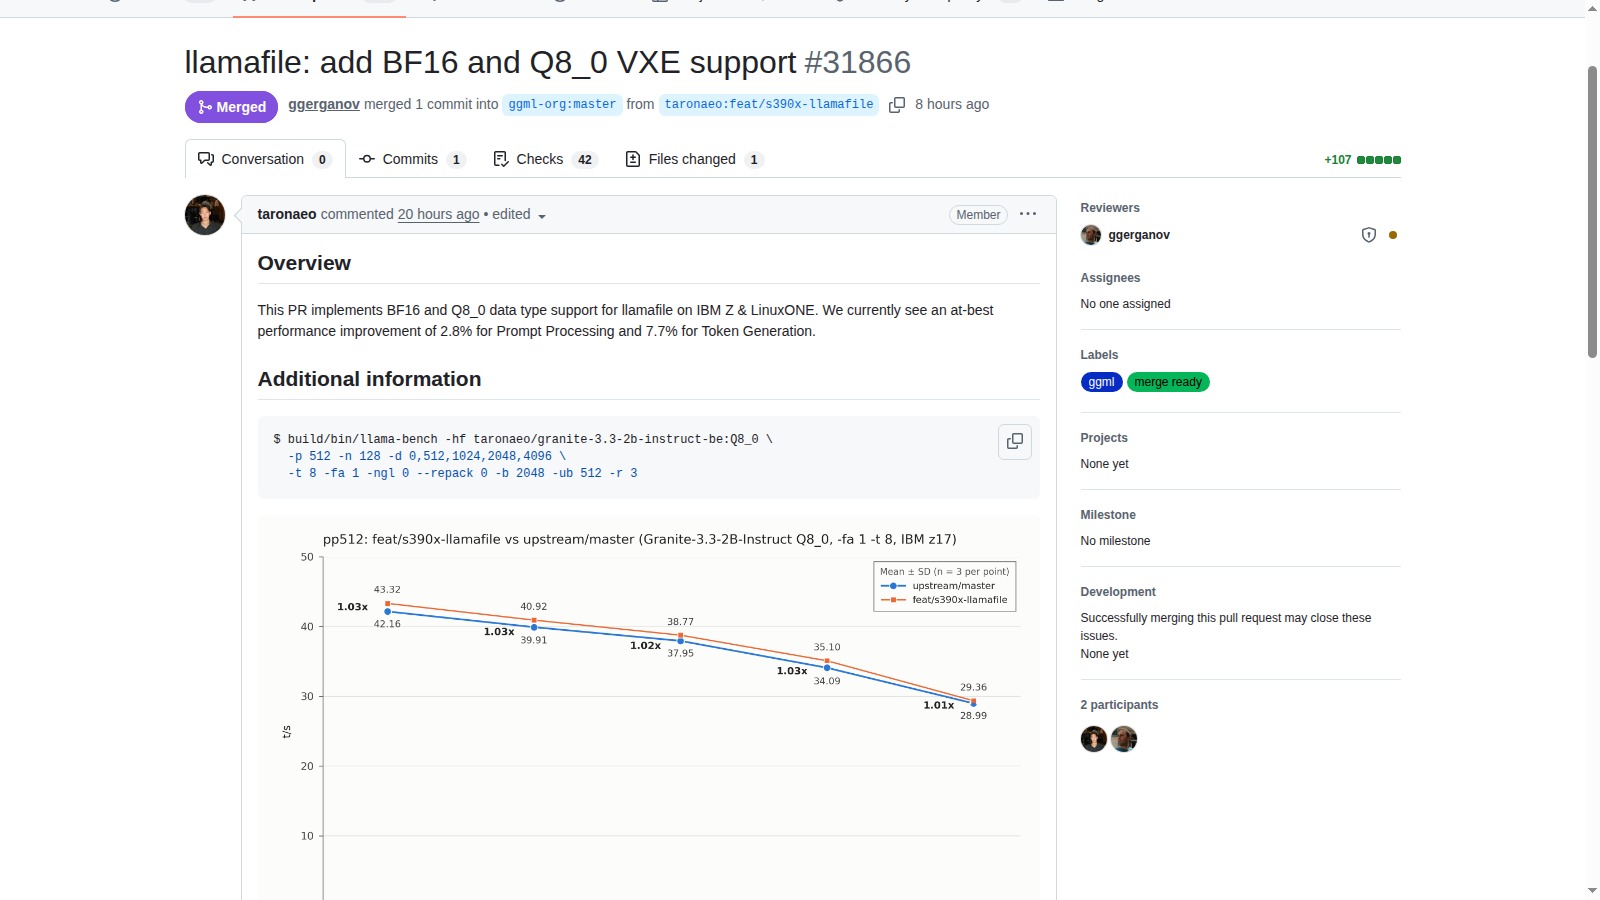
La prerelease b12209 aggiunge percorsi BF16 e Q8_0 VXE nel codice llamafile di llama.cpp per IBM Z e LinuxONE. Il dispatch Q8_0 richiede m e n pari per i blocchi 2×2. La tabella della PR include piccoli miglioramenti ma anche regressioni in alcuni test di generazione: non è uno speedup garantito né la stessa modifica BF16 di b12202.
Limiti da conoscere
Limite: I percorsi aggiunti sono protetti da __VXE__ o __VXE2__. La PR usa Granite 2B Q8_0 e otto thread; alcuni test tg128 sono più lenti della baseline. Nessuna prestazione propria misurata.
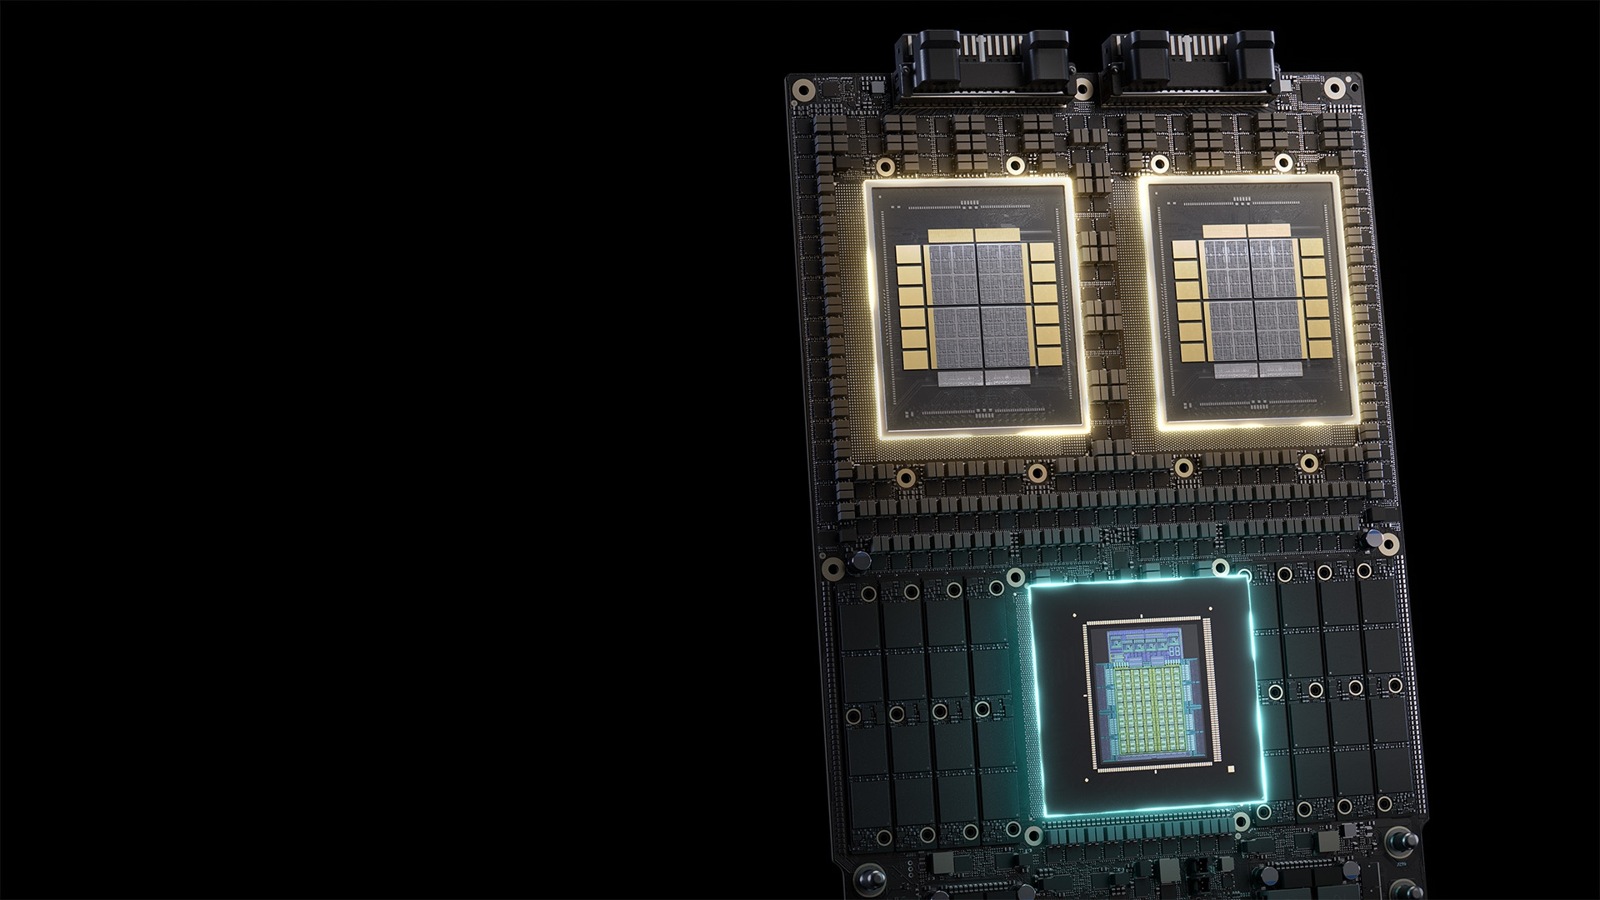
NVIDIA, Rebellions e SK Telecom annunciano un progetto che collega le NPU Rebel R200 a NVLink Fusion e all’architettura rack MGX. Il lavoro pianificato comprende GPU NVIDIA per il prefill e NPU Rebellions per il decode. La disponibilità dei sistemi R200 è attesa nel 2028: non è un’infrastruttura acquistabile o collaudata oggi da questa redazione.
Limiti da conoscere
Limite: Il deployment è previsto per il 2028. Throughput, efficienza energetica e bassa latenza sono obiettivi del progetto, non risultati indipendenti verificati qui; il comunicato non fornisce un listino o una prova riproducibile.
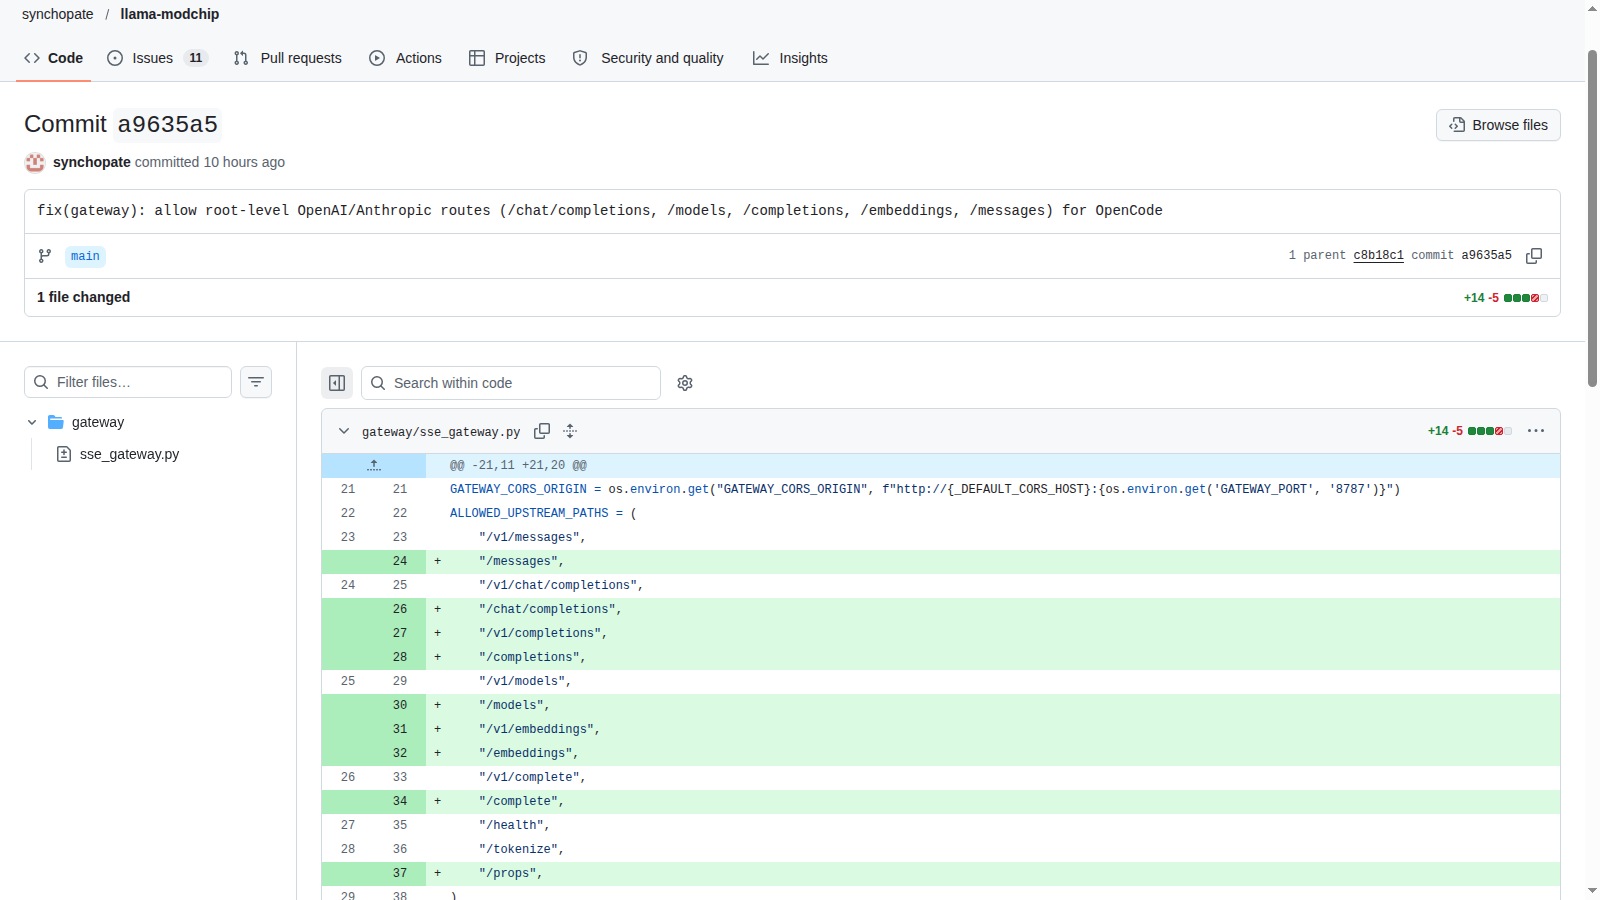
Il commit a9635a5 amplia i percorsi ammessi dal gateway e aggiorna i rami che gestiscono richieste chat e messages anche senza prefisso /v1. Il messaggio del commit cita OpenCode. È un delta di instradamento API dell’8 novembre, distinto dalla release 2.4.0 pubblicata il 4 novembre e dalle dichiarazioni del progetto su RAM o throughput.
Limiti da conoscere
Limite: Ammettere un percorso non prova la semantica completa di un’API. Non abbiamo verificato autenticazione, streaming, tool call o compatibilità OpenCode end-to-end, né riprodotto le prestazioni dichiarate nel README.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.