
L’ANALISI
llama.cpp: IQ3 in OpenCL e correzione DMA Hexagon
llama.cpp b12031 aggiunge IQ3 a OpenCL; b12030 corregge stride DMA oltre 24 bit su Hexagon. Sono 2 prerelease, senza test locale eseguito.
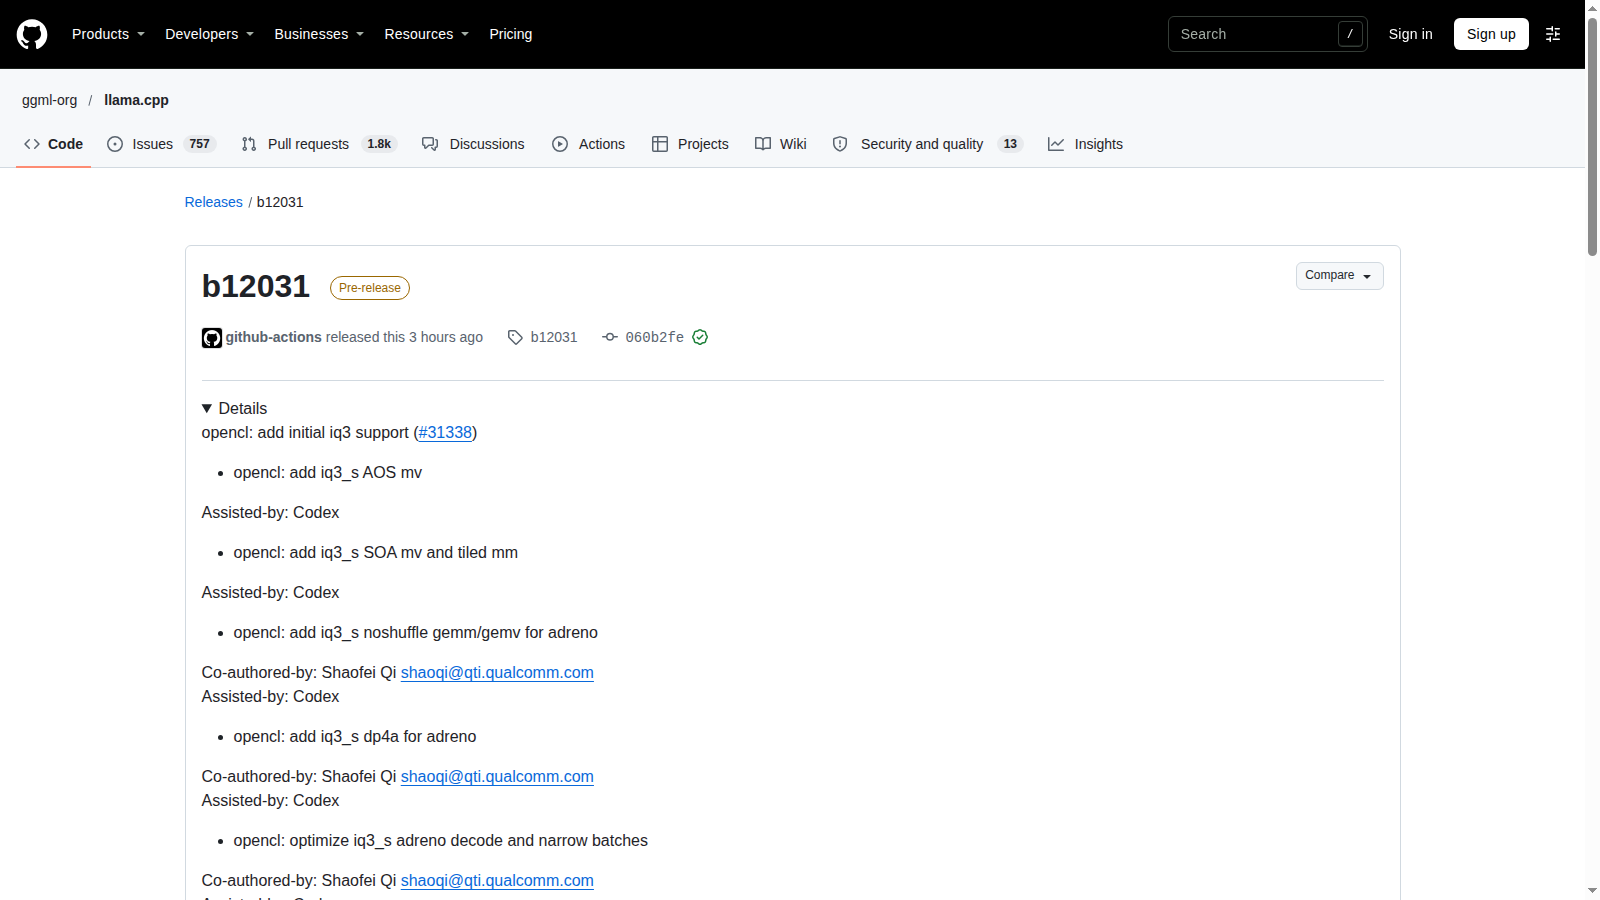
In breve: Le due prerelease di llama.cpp modificano percorsi hardware distinti: b12031 porta il supporto iniziale IQ3 nel backend OpenCL, mentre b12030 corregge un problema di indirizzamento nei trasferimenti DMA Hexagon con stride molto grandi. La scelta pratica è verificare se il proprio backend e il proprio GGUF sono coinvolti, poi confrontare output e tempi a condizioni identiche. Non è una dimostrazione di accelerazione generale.
Verifica documentale del 1 novembre 2026: lette le due release tramite API GitHub ufficiale, controllati published_at e prerelease, letta la pull request Hexagon e acquisita la pagina renderizzata b12031. Pubblicazione b12030 alle 08:16:14 e b12031 alle 08:41:33, ora italiana. Non compilati i sorgenti, non eseguiti modelli e non riprodotti i test hardware del progetto.
Che cosa aggiunge IQ3 a OpenCL?
Il changelog b12031 elenca percorsi IQ3_S e IQ3_XXS per operazioni matrice-vettore e matrice-matrice. Include implementazioni e ottimizzazioni dedicate ad Adreno, oltre a percorsi AOS e SOA. Il fatto verificabile è la presenza di questo supporto nel backend OpenCL della prerelease: non dimostra che qualsiasi file IQ3 funzioni su ogni GPU o che la qualità del modello cambi. Per decidere serve identificare il formato esatto del GGUF e il backend realmente caricato, anziché dedurli dal nome commerciale del dispositivo. llama.cpp b12031: supporto iniziale IQ3 in OpenCL.
Quale errore corregge Hexagon?
La release b12030 descrive i descrittori DMA 2D dei dispositivi v75 e successivi: dimensione della riga e stride hanno campi a 24 bit. Stride di 16 MB o più potevano essere troncati e produrre indirizzi errati. Il fallback precedente divideva il numero di righe, non risolveva lo stride eccessivo. La correzione usa un trasferimento per riga nel caso interessato. Il changelog aggiunge due test CONT con stride sorgente oltre 16 MB. È una correzione di correttezza nel percorso specifico, non un risultato di benchmark. llama.cpp b12030: correzione dei trasferimenti DMA Hexagon.
Sono release stabili o prerelease?
Alla lettura dell'API ufficiale entrambe le release espongono prerelease=true: b12030 è pubblicata il 1 novembre alle 07:16:14 UTC e b12031 alle 07:41:33 UTC. La data rilevata da un feed o il numero del tag non sostituiscono questi campi. Un pacchetto scaricabile non certifica il proprio scenario di produzione. Conviene conservare la build precedente e le sue dipendenze prima di una valutazione isolata, senza aggiornare automaticamente un servizio solo perché il numero è più alto. llama.cpp b12031: supporto iniziale IQ3 in OpenCL.
Come preparare un confronto ripetibile?
Protocollo proposto, non eseguito: scegliere una build precedente e la prerelease appropriata, poi mantenere invariati file GGUF, hash del modello, prompt, seed se supportato, contesto e numero di thread. Annotare sistema, driver, backend effettivo e condizioni termiche. Separare il tempo di caricamento, la valutazione del prompt e la generazione; registrare errori e differenze d'output prima di confrontare i tempi. Ripetere le misure e conservare i log. Un singolo avvio riuscito non equivale a compatibilità generale, e un tempo inferiore non risolve da solo eventuali errori numerici. llama.cpp b12030: correzione dei trasferimenti DMA Hexagon.
Che cosa cambia rispetto al supporto LFM3?
Il precedente aggiornamento Radar sul tensor split LFM3 riguardava la ripartizione del lavoro nel backend Hexagon. Le novità qui considerate sono diverse: formati IQ3 in OpenCL e trasferimenti DMA con stride oltre la capacità del descrittore. Non sostituiscono quella notizia e non consentono di sommare vantaggi presunti. Chi non usa quei backend può annotare il cambiamento senza attribuirgli automaticamente effetti al proprio runtime. Il criterio editoriale è il delta verificabile, non il numero di tag pubblicati nella giornata. llama.cpp b12030: correzione dei trasferimenti DMA Hexagon.
Condizioni e limitazioni
Entrambe sono marcate prerelease nell'API GitHub. Compatibilità, correttezza e prestazioni dipendono da modello, formato GGUF, backend, driver e dispositivo. Nessuna build o prova su hardware locale è stata eseguita: i test citati sono quelli dichiarati dal progetto, non una nostra validazione.
Checklist pratica
- Registrare tag, data pubblicazione e flag prerelease, senza affidarsi soltanto alla data del feed.
- Identificare modello, hash GGUF, quantizzazione e backend effettivamente usato.
- Verificare piattaforma e driver richiesti prima di scegliere il pacchetto, senza presumere compatibilità dal nome della GPU.
- Conservare build precedente e configurazione per un ripristino controllato.
- Per una prova futura fissare prompt, contesto, thread, rete se usata e condizioni termiche.
- Registrare output, errori e correttezza prima di confrontare i tempi; distinguere caricamento, prompt e generazione.
- Ripetere il confronto e pubblicare i log solo dopo l'esecuzione, senza ricavare benchmark dal changelog.