
L’ANALISI
llama.cpp b11714 porta ricerca e download di Hugging Face nella UI
Analisi pratica di llama.cpp b11714: ricerca GGUF nella UI, download e ripresa, quantizzazioni, draft sidecar, limiti di sicurezza e checklist di verifica.
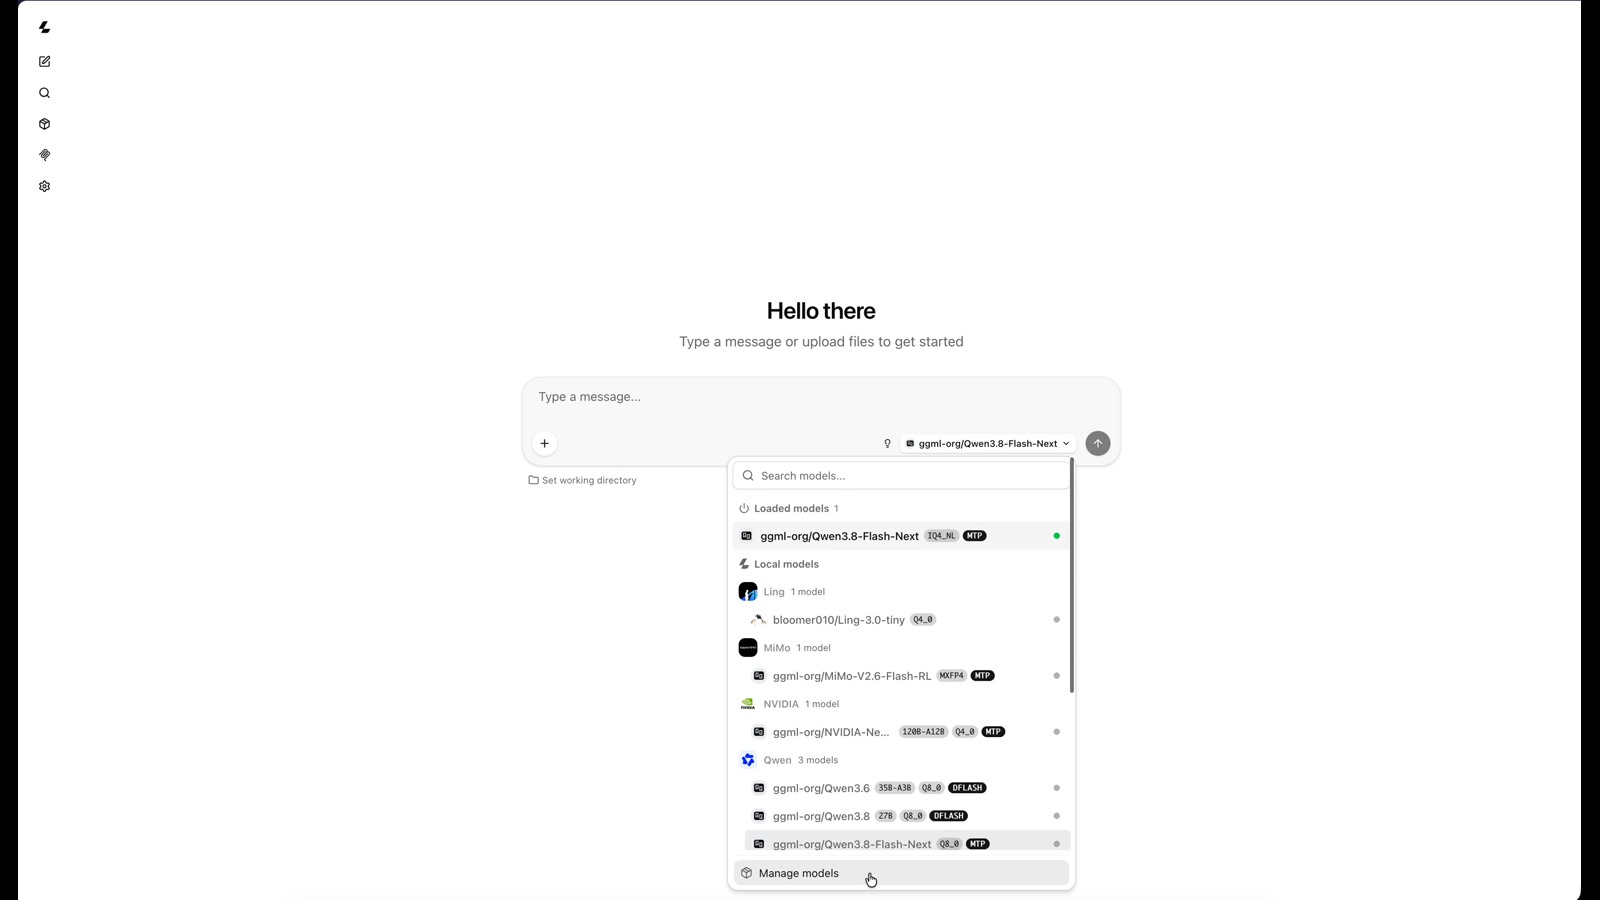
In breve: b11714 riduce il lavoro manuale tra Hugging Face e llama.cpp: dalla UI si può cercare un repository GGUF, confrontare i file, avviare il download e riprenderlo dopo una pausa o un riavvio. Non trasforma però il catalogo in una lista verificata: modello, licenza, memoria, template e qualità devono ancora essere controllati prima di caricare i pesi.
Che cosa aggiunge la build b11714
La nuova vista Discover Models entra nel gestore modelli della UI e resta dietro un’impostazione disattivata per default. Espone catalogo, ricerca con debounce, filtri dimensionali, statistiche Hugging Face, README e pulsanti per le singole quantizzazioni.
Dalla ricerca al file GGUF
Ogni opzione mostra dimensione e indicazioni di compatibilità con la memoria, mentre il comando equivalente resta copiabile. Il flusso riduce gli errori di percorso e nome file, ma la scelta tra Q4, Q5, Q8 o precisioni superiori continua a dipendere da memoria, backend e obiettivo di qualità.
Download, pausa e ripresa
llama.cpp conserva i file parziali quando un download viene fermato, registra le operazioni incompiute e permette di riprenderle anche dopo il riavvio del server. Prima della ripresa controlla l’ETag e ricomincia da zero se il file remoto è cambiato o il server non accetta correttamente la richiesta parziale.
Draft sidecar e speculative decoding
Quando il repository offre un draft compatibile, la UI può abbinarlo alla quantizzazione principale e scaricarlo nello stesso flusso, preferendo DFlash a MTP. I sidecar restano associati al modello e le operazioni di pausa, annullamento o rimozione rispettano la quantizzazione selezionata.
Controlli introdotti nella UI
I README con HTML vengono trattati con DOMPurify e la patch rimuove stili posizionati che potrebbero coprire l’interfaccia. I modelli di classificazione decisionale vengono esclusi perché la UI non può eseguirli come modelli generativi. Questi controlli riducono alcuni rischi di presentazione, non certificano il contenuto del repository.
Impatto pratico per un test locale
Il vantaggio principale è operativo: meno passaggi manuali, stato dei download visibile e recupero più semplice dopo interruzioni. Per un laboratorio locale resta necessario bloccare build e hash, scegliere un repository affidabile, misurare spazio e memoria, verificare il template di chat e confrontare output e prestazioni sul proprio hardware.
Condizioni e limitazioni
Discover Models è disattivato per impostazione predefinita e richiede accesso a Hugging Face. La UI semplifica acquisizione e ripresa dei file, ma non verifica qualità, licenza, provenienza o compatibilità hardware di ogni repository; dimensioni e note di memoria restano stime da controllare prima dell’esecuzione.
Checklist pratica
- Installare o compilare esattamente b11714 e registrare backend, driver e hash del pacchetto usato.
- Lasciare Discover Models disattivato finché non è stato definito quali repository e licenze sono ammessi.
- Controllare pagina del modello, autore, licenza, commit o revisione e checksum prima del caricamento.
- Confrontare dimensione del GGUF con RAM, VRAM, cache KV e spazio necessario per i file parziali.
- Provare pausa, riavvio e ripresa con un file non critico, verificando che il download finale sia integro.
- Scaricare draft sidecar solo quando il modello e il runtime supportano realmente il percorso scelto.
- Eseguire prompt controllati e misurare qualità, velocità e memoria prima di usare il modello in un servizio.