
L’ANALISI
llama.cpp b11706 corregge il calo SYCL dopo il primo turno
Analisi pratica di llama.cpp b11706: regressione SYCL dopo il primo decode, fix per Q4_0 e Q8_0, benchmark su Intel Arc, correttezza e checklist di verifica.
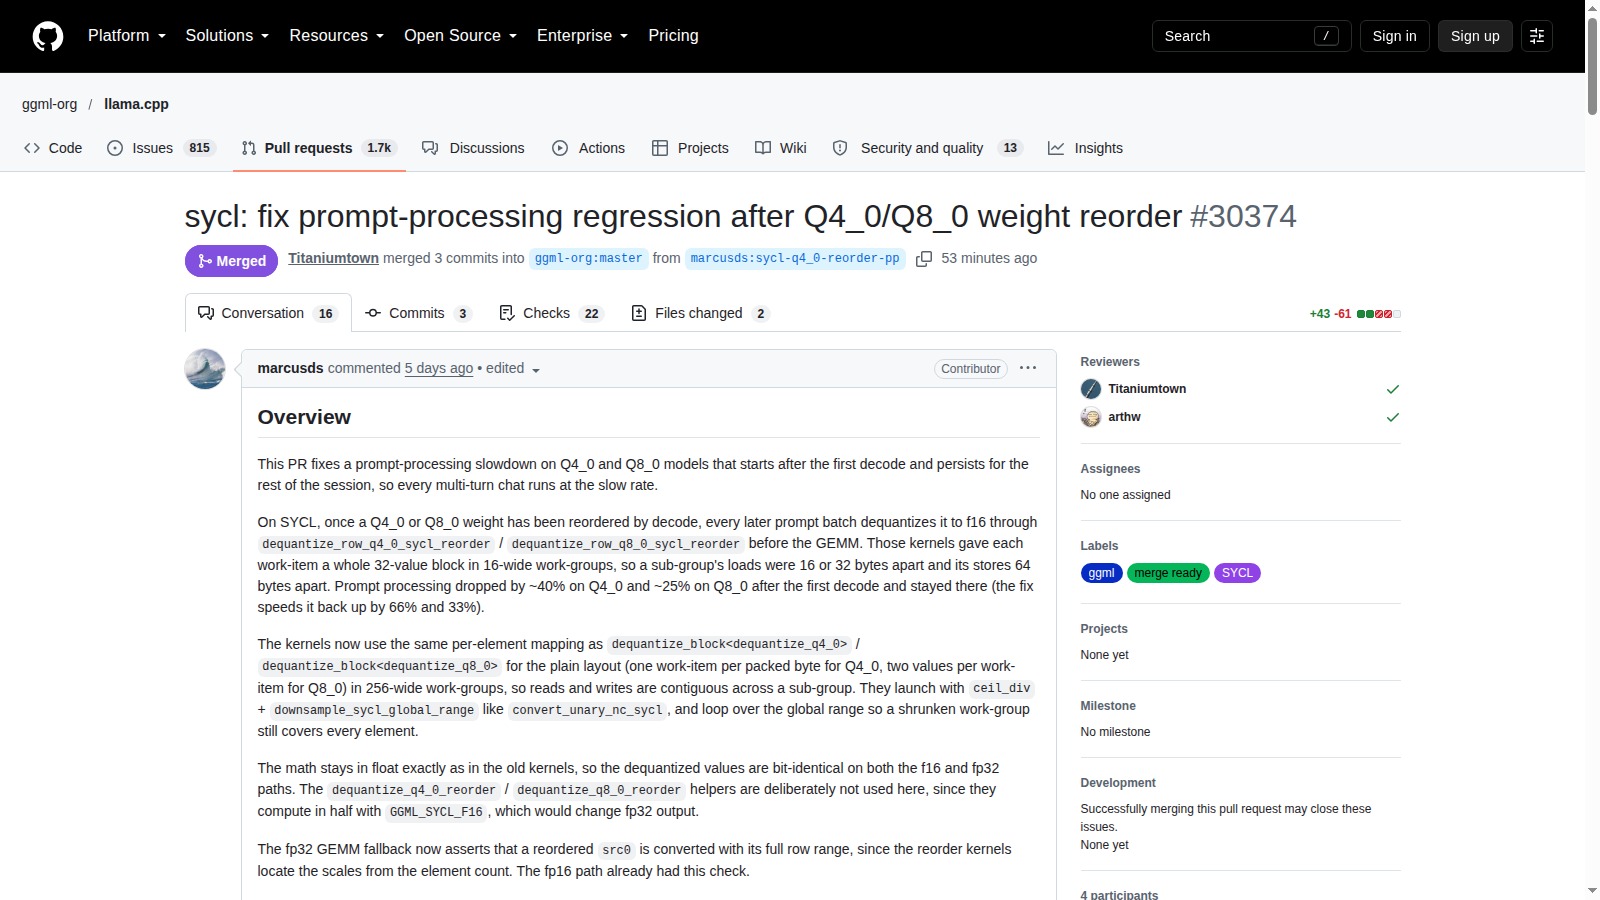
In breve: Il problema non riduceva la velocità del primo prompt, ma degradava i prompt successivi in una chat multi-turno dopo il riordino dei pesi. b11706 cambia il mapping dei kernel di dequantizzazione SYCL per rendere contigui accessi e scritture: nei test pubblicati recupera circa il 66% su Q4_0 e il 33% su Q8_0 rispetto allo stato rallentato, senza cambiare la velocità di generazione o gli output verificati.
Che cosa si rompeva dopo il primo turno
Dopo il primo decode, i pesi Q4_0 e Q8_0 riordinati venivano dequantizzati con un mapping che assegnava un intero blocco da 32 valori a ciascun work-item. Gli accessi non contigui penalizzavano ogni prompt successivo e rendevano lenta l’intera sessione multi-turno, pur lasciando normale il primo prompt.
Come cambia il kernel SYCL
Il fix usa un mapping per elemento in work-group da 256 elementi, con byte e valori distribuiti in modo contiguo nel sub-group. Il percorso conserva i calcoli in float e aggiunge un controllo sul range completo delle righe nel fallback GEMM fp32, evitando di cambiare l’output numerico per ottenere la velocità.
I numeri pubblicati su Intel Arc
Su Arc Pro B50 con Qwen3.5-9B Q4_0, pp512 dopo il decode passa da 607 a 1005 token al secondo e il prompt server da 767 a 1150. Con Qwen3.5-2B Q8_0, pp512 passa da 3117 a 4161 e il prompt server da 3506 a 4335. La generazione tg32 resta rispettivamente a 33 e 81 token al secondo.
Correttezza e riproducibilità
Il pull request riporta perplexity Wikitext-2 invariata, 128 token greedy identici dopo prompt da 7,3K e 17K token e 2272 test MUL_MAT superati. Pubblica anche il comando llama-bench usato, così il confronto può essere ripetuto prima e dopo l’aggiornamento sullo stesso modello.
Quando il delta è rilevante
Il fix interessa chi usa il backend SYCL con GPU Intel e modelli Q4_0 o Q8_0 in chat persistenti, server o workflow con più prompt consecutivi. Non è una promessa generale di accelerazione: chi usa CUDA, ROCm, Metal o altre quantizzazioni non deve attribuirsi automaticamente lo stesso miglioramento.
Condizioni e limitazioni
Le misure provengono dal contributore e coprono Intel Arc Pro B50 e UHD 730 con specifici modelli Qwen3.5, non ogni GPU SYCL o quantizzazione. b11706 è una prerelease: prima di aggiornare un servizio stabile vanno ripetuti benchmark, test multi-turno e controlli di output sul proprio hardware.
Checklist pratica
- Fissare la build precedente e b11706, conservando hash dei binari e del GGUF usato nel confronto.
- Riprodurre il test con lo stesso modello Q4_0 o Q8_0, stesso backend SYCL e identici parametri di llama-bench.
- Misurare separatamente il primo pp512 e il pp512 dopo almeno un decode, perché la regressione appare solo dopo il riordino.
- Ripetere una conversazione multi-turno reale e registrare prompt processing, token generation, memoria e latenza totale.
- Confrontare perplexity o output greedy per escludere differenze introdotte dalla build e dal proprio stack.
- Promuovere la prerelease solo dopo test di stabilità; mantenere disponibile il rollback alla build precedente.