
L’ANALISI
K2-Horizon-32B Stage 1: pesi disponibili, contesto 512K e limiti pratici
Analisi di K2-Horizon-32B Stage 1: pesi Apache 2.0, contesto 512K, serving vLLM e SGLang, benchmark dichiarati e checklist di prova.
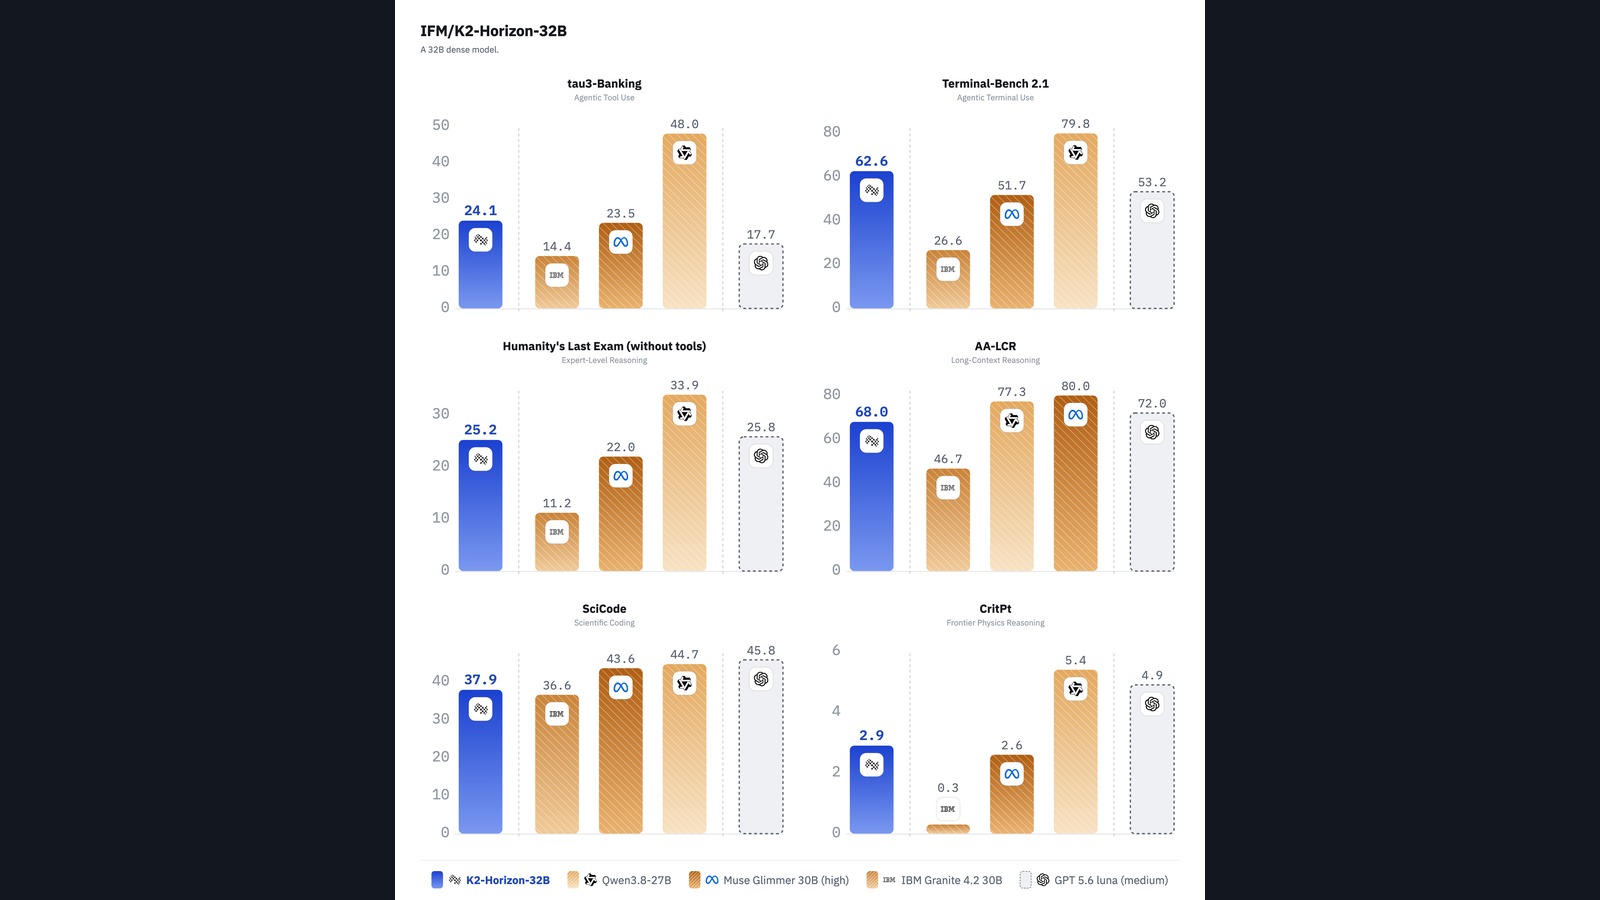
In breve: K2-Horizon-32B-Stage1 è ora un artefatto scaricabile con pesi Safetensors e licenza Apache 2.0. Il contesto nativo dichiarato arriva a 524.288 token, ma il checkpoint è intermedio e le ricette pubblicate richiedono hardware server: non è ancora una scelta locale leggera.
Che cosa è disponibile
Il repository include 64 shard Safetensors, configurazione, tokenizer, template chat e codice modello. La model card identifica un decoder-only dense da 32 miliardi di parametri e lo marca esplicitamente come Stage 1, con checkpoint finale ancora da pubblicare.
Contesto lungo e serving
IFM dichiara un contesto nativo di 524.288 token. L’esempio vLLM usa però max-model-len 131072, tensor parallel 2 e trust-remote-code; la ricetta SGLang è indicata come validata su 2 GPU H200. Il limite teorico e quello pratico vanno quindi misurati separatamente.
Tool use e impostazioni
Le ricette includono parser dedicati k2_horizon per ragionamento e chiamate agli strumenti. La model card raccomanda reasoning_effort high, temperatura 1.0 e top_p 0.95: sono impostazioni del produttore da fissare nei test per evitare confronti incoerenti.
Come leggere i benchmark
IFM pubblica risultati su tau3-Banking, Terminal-Bench 2.1, SciCode, Humanity’s Last Exam, GPQA Diamond e prove di contesto lungo. La stessa tabella mostra diversi casi in cui modelli dense alternativi ottengono punteggi superiori. Sono risultati del progetto, non una replica indipendente.
Apertura e confine operativo
La licenza del repository è Apache 2.0 e i pesi sono presenti. IFM promette inoltre dati, ricetta e codice di training, ma la formulazione al futuro significa che questi elementi non vanno considerati già completi senza verificare i rispettivi repository.
Condizioni e limitazioni
È un checkpoint Stage 1, non il modello finale. La ricetta SGLang è validata dal produttore su 2 GPU H200; la ricetta vLLM limita l’esempio a 131.072 token. Benchmark e confronti sono dichiarazioni del progetto e non equivalgono a una replica indipendente.
Checklist per una prova controllata
- Fissare la revisione 7eb3d2dceccb27bad4f97d76ce92e7431b3f786a e verificare i checksum scaricati.
- Eseguire codice remoto soltanto in un ambiente isolato e dopo revisione.
- Partire dalla finestra da 131.072 token mostrata nella ricetta vLLM.
- Misurare memoria, latenza e throughput prima di aumentare il contesto.
- Testare tool calling e parsing del ragionamento con casi controllati.
- Replicare un piccolo sottoinsieme dei benchmark con harness e prompt registrati.
- Confrontare Stage 1 e checkpoint finale senza sovrascrivere i risultati storici.