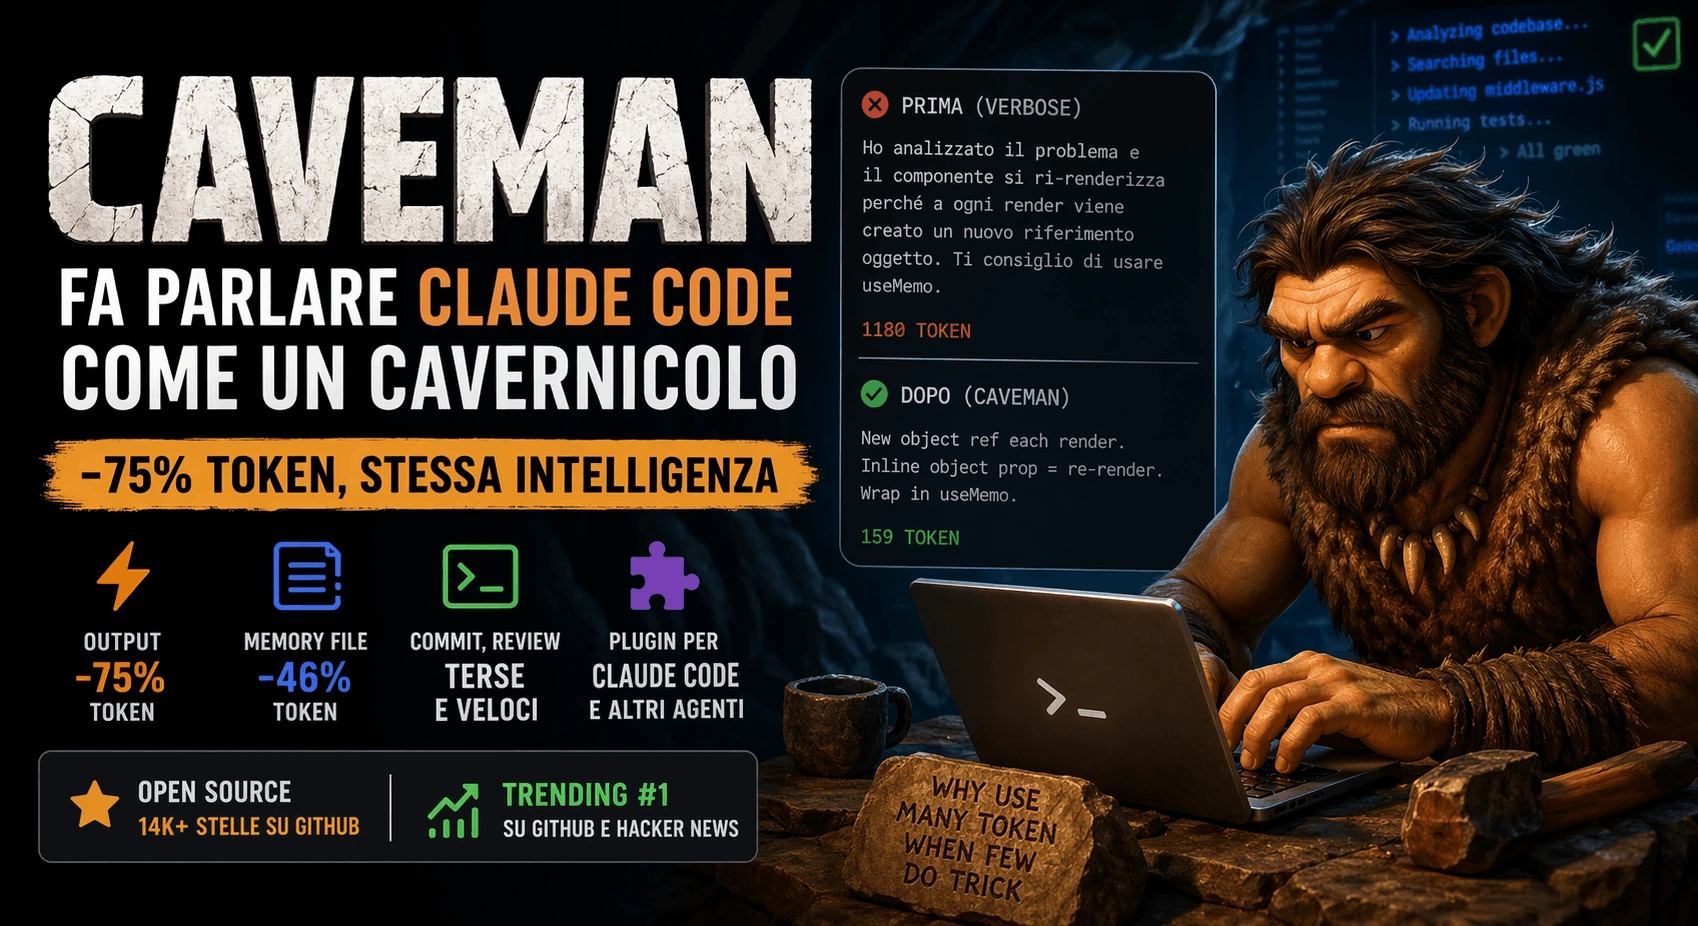
C’è un progetto open source che nelle ultime settimane ha fatto parecchio rumore nel mondo degli agenti AI: Caveman. L’idea è semplice e quasi assurda da raccontare: far parlare Claude Code come un cavernicolo per usare meno token. Il repository ufficiale lo presenta come una skill/plugin per Claude Code e come plugin per Codex, con claim di ~75% in meno sui token di output, modalità multiple di compressione e un tool che riduce di ~46% i token letti nei file di memoria come CLAUDE.md.
Detta così sembra il classico meme tecnico destinato a vivere tre giorni. In realtà sotto c’è qualcosa di più interessante: meno rumore, output più leggibile, risposte più secche e, in alcuni casi, anche un possibile beneficio sulla qualità della risposta. Il punto però è capirlo bene, senza leggere quei numeri nel modo sbagliato.
Cos’è
Caveman è un progetto open source di Julius Brussee. L’obiettivo è togliere tutto ciò che non serve nelle risposte dell’agente: filler, frasi di cortesia, giri larghi, spiegazioni prolisse. Il repo include modalità lite, full, ultra e perfino una modalità 文言文 in cinese classico, oltre a strumenti dedicati come caveman-commit, caveman-review e caveman:compress. Oggi il repository mostra circa 44.1k stelle e 2.3k fork su GitHub.
In pratica, invece di scrivere:
Ho analizzato il problema e il componente si ri-renderizza perché a ogni render viene creato un nuovo riferimento oggetto. Ti consiglio di usare useMemo.
Caveman spinge verso qualcosa del genere:
New object ref each render. Inline object prop = new ref = re-render. Wrap in
useMemo.
Il significato resta quasi identico. La differenza è il rumore.
Come funziona
La cosa importante da capire è questa: Caveman non cambia il cervello del modello. Non tocca il reasoning, non tocca il codice generato, non trasforma Opus in un modello più economico. Lo dice anche il README in modo molto diretto: Caveman tocca gli output tokens, mentre i token di thinking/reasoning restano invariati. Il vantaggio principale, secondo il progetto stesso, è soprattutto in leggibilità e velocità, mentre il risparmio economico è un bonus.
Questa distinzione conta tantissimo. Perché il claim “-75%” è vero sulla parte giusta, ma spesso viene capito male.
Ti sta piacendo?
Ricevi una guida pratica ogni settimana. AI, tool e automazioni.
Il punto chiave
No, non significa che l’intera sessione di Claude Code costi il 75% in meno.
Claude Code lavora leggendo file, usando strumenti, scrivendo codice, accumulando contesto, eseguendo comandi. Anthropic lo descrive proprio come uno strumento che opera sul progetto, modifica file, usa il terminale e si integra con l’ambiente di sviluppo.
Caveman comprime soprattutto la prosa finale, cioè il modo in cui l’agente ti parla. Se in una sessione reale quella prosa è solo una parte del totale, il risparmio complessivo sarà molto più basso del numero da social. Non zero. Ma nemmeno miracoloso. Questa lettura è coerente sia con il posizionamento del progetto come output compression skill, sia con la nota del README secondo cui i token di reasoning non vengono toccati.
Dove aiuta davvero
Secondo me Caveman diventa interessante in tre scenari molto pratici.
1. Debug rapido
Se stai facendo fix lineari, refactor meccanici o review veloci, avere un agente che ti dice:
Expiry check wrong. Uses
<not<=. Fix middleware. Update test.
è spesso più utile di tre paragrafi pieni di educazione artificiale.
2. Meno frizione
Quando usi agenti AI tutto il giorno, il problema non è solo quanto spendi. È anche quanto tempo perdi a leggere. Qui Caveman può aiutare molto: meno scroll, meno contorno, più segnale.
3. Memory file più leggeri
La parte più sottovalutata del progetto, secondo me, è caveman:compress. Il tool riscrive file come CLAUDE.md in forma compressa, salva una copia leggibile in CLAUDE.original.md e lascia intatti codice, URL, path, comandi, heading, date e versioni. Nel README la media dichiarata è 46% di riduzione su questi file.
Esempio semplice.
Versione classica:
Please avoid silent try/catch blocks. Always fail loudly. Use structured logging in production services and do not introduce console.log statements in src unless explicitly requested.
Versione compressa:
No silent try/catch. Fail loud. Use structured logging. No console.log in src unless asked.
L’umano capisce ancora tutto. L’agente legge meno testo. Se quel file viene caricato spesso, il beneficio è reale.
I benchmark
Il repo pubblica benchmark molto forti. Alcuni esempi:
- React re-render bug: 1180 → 159 token, 87% in meno
- Auth middleware token expiry: 704 → 121, 83% in meno
- PostgreSQL race condition: 1200 → 232, 81% in meno
- Media: 1214 → 294, cioè 65% di risparmio nei prompt testati
La parte positiva è che il progetto prova anche a misurare la cosa in modo un po’ più serio del classico “prima verbose, dopo breve”. Nel README si parla di un three-arm eval harness nella cartella evals/, pensato per confrontare Caveman anche contro un controllo più corretto e non solo contro Claude prolisso.
Quindi sì, dietro il meme c’è un tentativo di misurazione reale. Ma quei benchmark restano benchmark: non equivalgono automaticamente al risparmio reale della tua settimana di lavoro.
La parte più interessante: il paper
Qui il discorso diventa più serio.
Caveman cita il paper “Brevity Constraints Reverse Performance Hierarchies in Language Models”, pubblicato su arXiv nel marzo 2026. Il lavoro riporta esperimenti su 31 modelli e 1.485 problemi e conclude che imporre vincoli di brevità può migliorare l’accuratezza dei modelli grandi di circa 26 punti percentuali su alcuni benchmark, riducendo anche i gap di performance. Gli autori parlano di un problema di prolissità spontanea: modelli grandi che si dilungano troppo e, così facendo, peggiorano la risposta.
Attenzione però: questo non prova che Caveman migliori sempre Claude Code nel coding reale. Ma dà una base molto interessante a un’intuizione che tanti sviluppatori hanno già: più parole non significa sempre più qualità.
Quando usarlo
Io lo vedo bene qui:
- debug lineare
- review veloci
- refactor meccanici
- commit message
- handoff sintetici
- workflow multi-agent dove vuoi meno rumore nel passaggio di contesto
Quando no
Non lo terrei sempre acceso su:
- onboarding a framework nuovi
- ragionamento architetturale
- documentazione
- spiegazioni da condividere con colleghi
- task dove il perché conta più della sola risposta
In quei casi, comprimere troppo rischia di togliere proprio il pezzo utile.
Installazione
Su Claude Code:
claude plugin marketplace add JuliusBrussee/caveman
claude plugin install caveman@caveman
Su Cursor:
npx skills add JuliusBrussee/caveman -a cursorSu Gemini CLI:
gemini extensions install https://github.com/JuliusBrussee/cavemanIl README indica supporto anche per Codex, Windsurf, Copilot, Cline e altri agenti. L’auto-attivazione è integrata per Claude Code, Gemini CLI e per la configurazione locale di Codex nel repo; su altri ambienti spesso serve aggiungere regole o instruction file.
Verdetto
Caveman non è una magia. Ma non è neanche solo hype.
Se qualcuno lo presenta come il trucco definitivo per abbattere del 75% qualsiasi flusso in Claude Code, sta forzando troppo il messaggio. Se invece lo guardi per quello che è davvero, il progetto ha senso:
- riduce la verbosità
- alleggerisce la lettura
- può aiutare la qualità in alcuni task
- rende più utili i file di memoria compressi
- impone una disciplina interessante sul modo in cui l’agente comunica
In altre parole: non rende Claude più intelligente, ma in molti casi lo rende più utile.
Fonti
- Repository ufficiale Caveman
- Paper: Brevity Constraints Reverse Performance Hierarchies in Language Models
- Claude Code Docs overview
Aggiungi francescogruner.it come fonte preferita
Se leggi spesso i miei articoli su AI, automazione e tecnologia, ora puoi dire a Google che vuoi vedere più spesso i contenuti di francescogruner.it tra le notizie.