
L’ANALISI
Agenti AI in laboratorio: cosa mostra davvero il test quantistico di OpenAI
Un agente collegato a strumenti fisici ha completato calibrazioni note, ma sui segnali ambigui è tornato necessario l’intervento di un esperto.
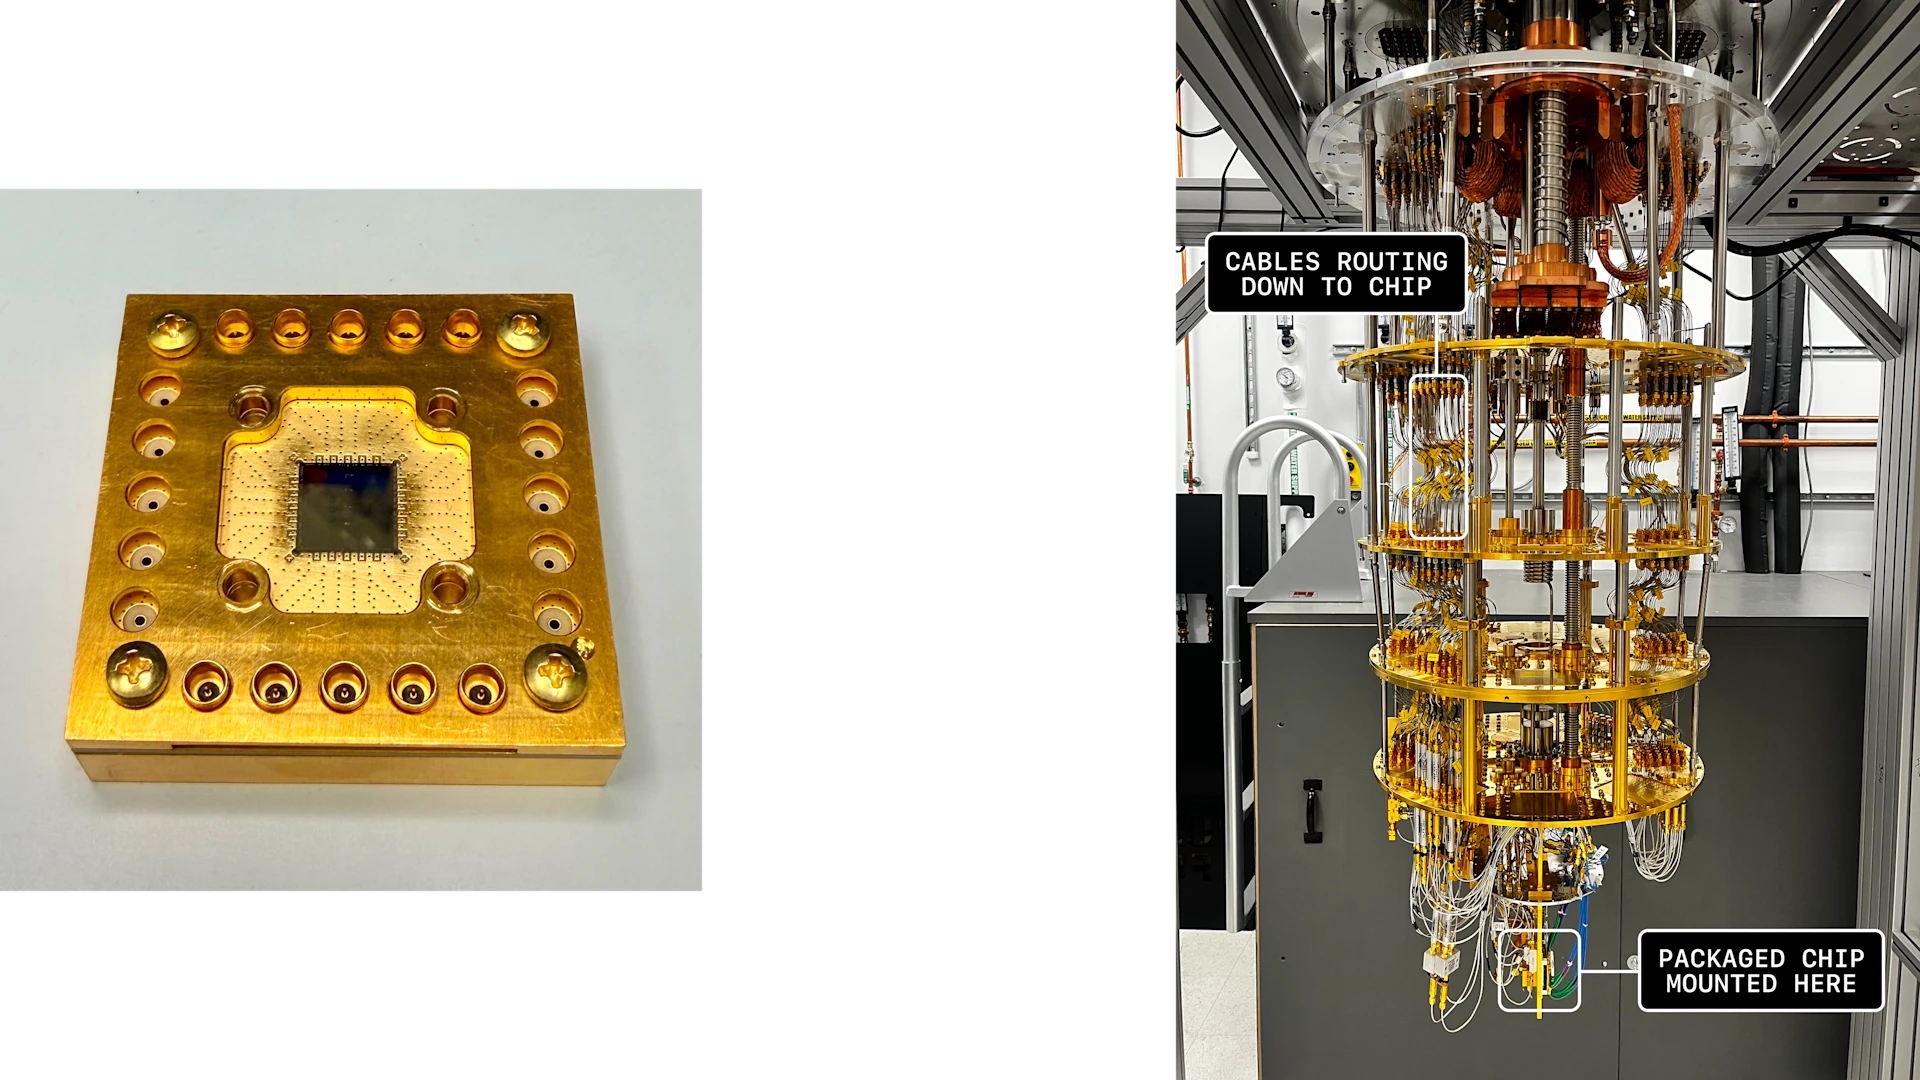
In breve: il caso dimostra che un agente può concatenare misure e decisioni in un workflow noto. Non dimostra ricerca scientifica autonoma: rumore e ambiguità richiedono ancora escalation umana.
Che cosa ha eseguito l’agente
OpenAI ha collegato GPT-5.6 Sol, tramite Codex, al software di controllo del gruppo EQuS del MIT. Sul chip a sei qubit l’agente ha scelto parametri, lanciato misure, letto i risultati e deciso se affinare la calibrazione o passare allo step successivo.
Dove l’autonomia ha funzionato
Con segnali chiari e procedure standard, il sistema ha completato sequenze di calibrazione con poco intervento. Il valore pratico non è una nuova teoria: è la riduzione dei passaggi manuali in un processo già definito e osservabile.
Dove si è fermata
Quando le misure erano deboli o rumorose, il ciclo ha richiesto più tempo e in alcuni casi guida esperta. Questa è la condizione operativa centrale: l’agente deve riconoscere l’incertezza, conservare il contesto e passare la decisione a una persona.
Che cosa non prova il case study
La pubblicazione viene dal fornitore del modello, riguarda un solo laboratorio e non presenta un benchmark indipendente tra agenti o contro un protocollo manuale controllato. Non consente quindi di generalizzare tempi, affidabilità o vantaggi economici ad altri strumenti.
Checklist per un agente collegato a strumenti
- Definire passi consentiti, soglie e condizioni di arresto.
- Registrare parametri, misure, decisioni e versione del modello.
- Separare azioni reversibili da operazioni che richiedono conferma.
- Testare segnali puliti, rumorosi e volutamente ambigui.
- Misurare errori, tempo risparmiato ed escalation, non solo il completamento.