
L’ANALISI
JEV-27B-VL: decisioni multimodali locali, pesi e limiti
AutoTrust pubblica un modello da 27B che combina visione, generazione e decisioni calibrate: cosa è scaricabile, come provarlo e quali risultati restano da verificare.
In breve: JEV-27B-VL rende scaricabile un singolo modello multimodale che può generare testo oppure scegliere tra opzioni restituendo probabilità. Il caso più concreto è il ranking zero-shot di copertine video, ma i risultati sono interni e il requisito indicato di una GPU da almeno 80 GB limita la prova locale.
Il delta verificato
Il 30 settembre AutoTrust ha pubblicato il model repository JEV-27B-VL, gli shard Safetensors, la model card e un repository Apache-2.0 con demo riproducibili. Il delta non è solo un annuncio: pesi, adattatore decisionale e procedure vLLM sono disponibili.
Due modalità nello stesso serving
Il modello conserva la generazione multimodale del Qwen3.8-27B di base come System 2 e aggiunge un percorso System 1. Quest’ultimo limita l’uscita alle opzioni definite e restituisce una distribuzione di probabilità, utile per classificazione, routing e ranking.
Il test sulle immagini
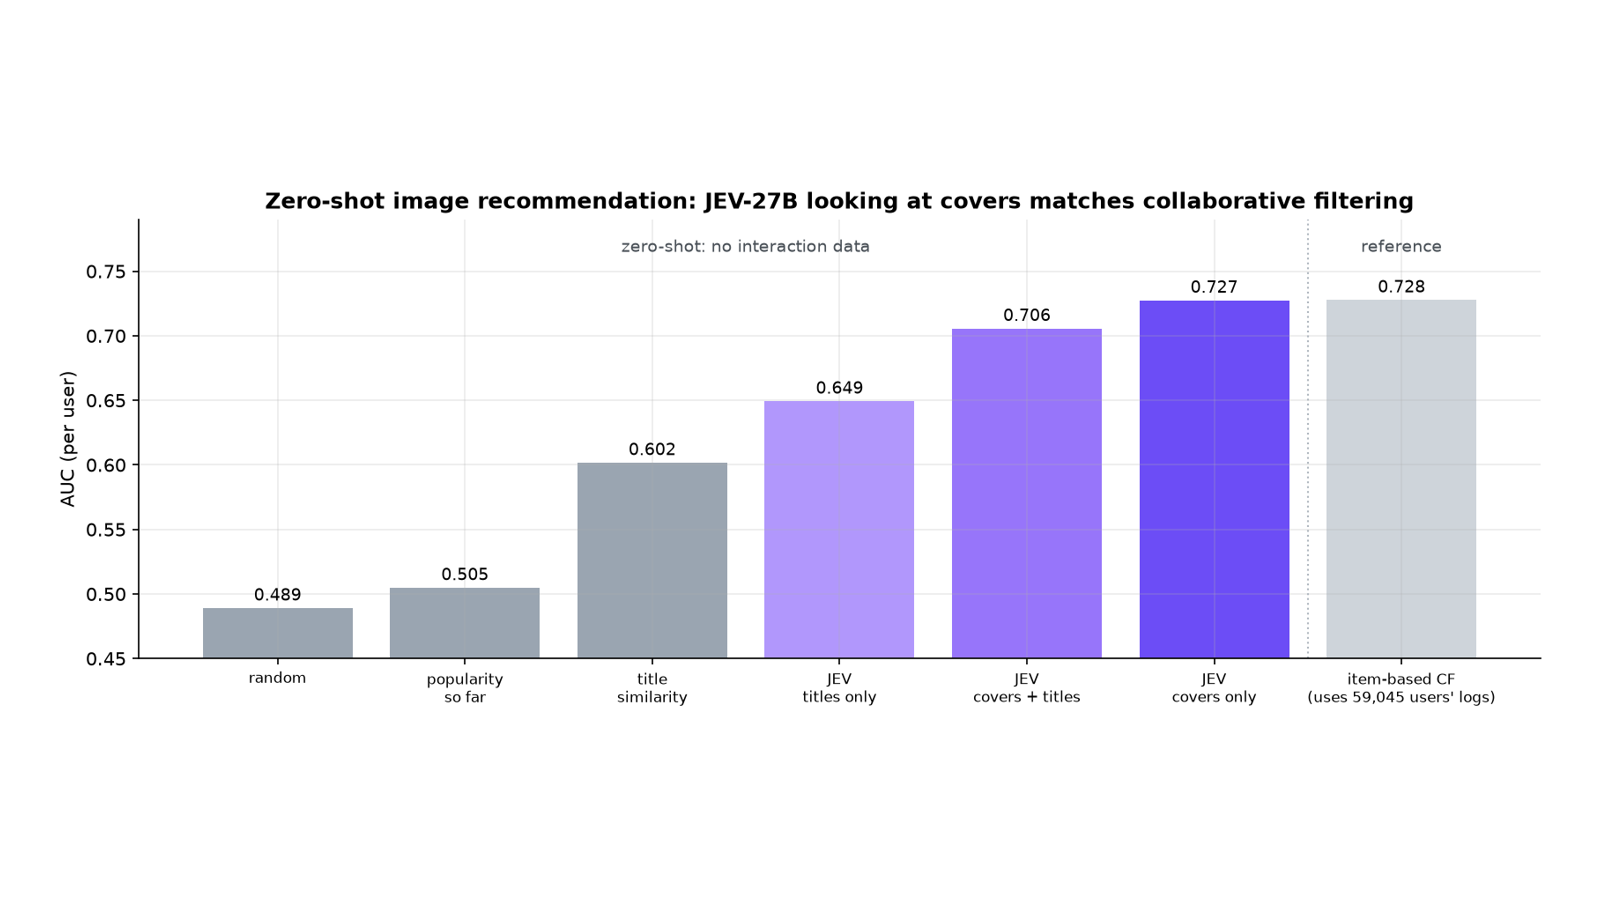
Nel test dichiarato su MicroLens, il modello ordina 20 copertine per 200 utenti senza usare log di interazione. AutoTrust riporta AUC 0,727 e hit rate top-5 del 59%, valori vicini all’AUC 0,728 del collaborative filtering addestrato sui comportamenti di 59.045 utenti.
Come si esegue
La model card documenta download via Hugging Face e serving con vLLM o SGLang. Il repository demo indica circa 54 GB da scaricare e una GPU con almeno 80 GB; le chiamate System 1 richiedono verbalizer, bias e temperatura forniti con il modello.
Licenza e riuso
Model card e repository demo dichiarano Apache-2.0. Prima di un impiego operativo vanno comunque controllate le condizioni del modello base e dei dataset usati nei singoli esperimenti, oltre alla governance dei dati visivi propri.
Condizioni e limiti
I risultati provengono dal produttore e il test visivo usa un solo dataset con 200 utenti. Non abbiamo verificato calibrazione fuori dominio, robustezza in italiano, latenza reale, consumo VRAM o stabilità del formato probabilistico sotto carico.
Checklist per una prova locale
- Scaricare il modello fissando commit e checksum.
- Verificare licenze del modello, del modello base e dei dati di prova.
- Preparare una GPU con memoria sufficiente o un nodo remoto isolato.
- Avviare vLLM con gli script ufficiali e registrare versioni e parametri.
- Provare prima una domanda binaria con immagini controllate.
- Verificare che le probabilità sommino a uno e che il formato resti stabile.
- Confrontare System 1 con una baseline deterministica sul proprio dataset.
- Misurare latenza, VRAM e calibrazione per sottogruppo.
- Ripetere il test in italiano e su immagini fuori dominio.