
L’ANALISI
GPT-6.1 Sol cambia il rapporto tra capacità e costo
GPT-6.1 Sol arriva in API, ChatGPT Work e Codex con cache a 0,10 dollari per milione di token: prezzi, prove dichiarate e criteri per valutarlo.
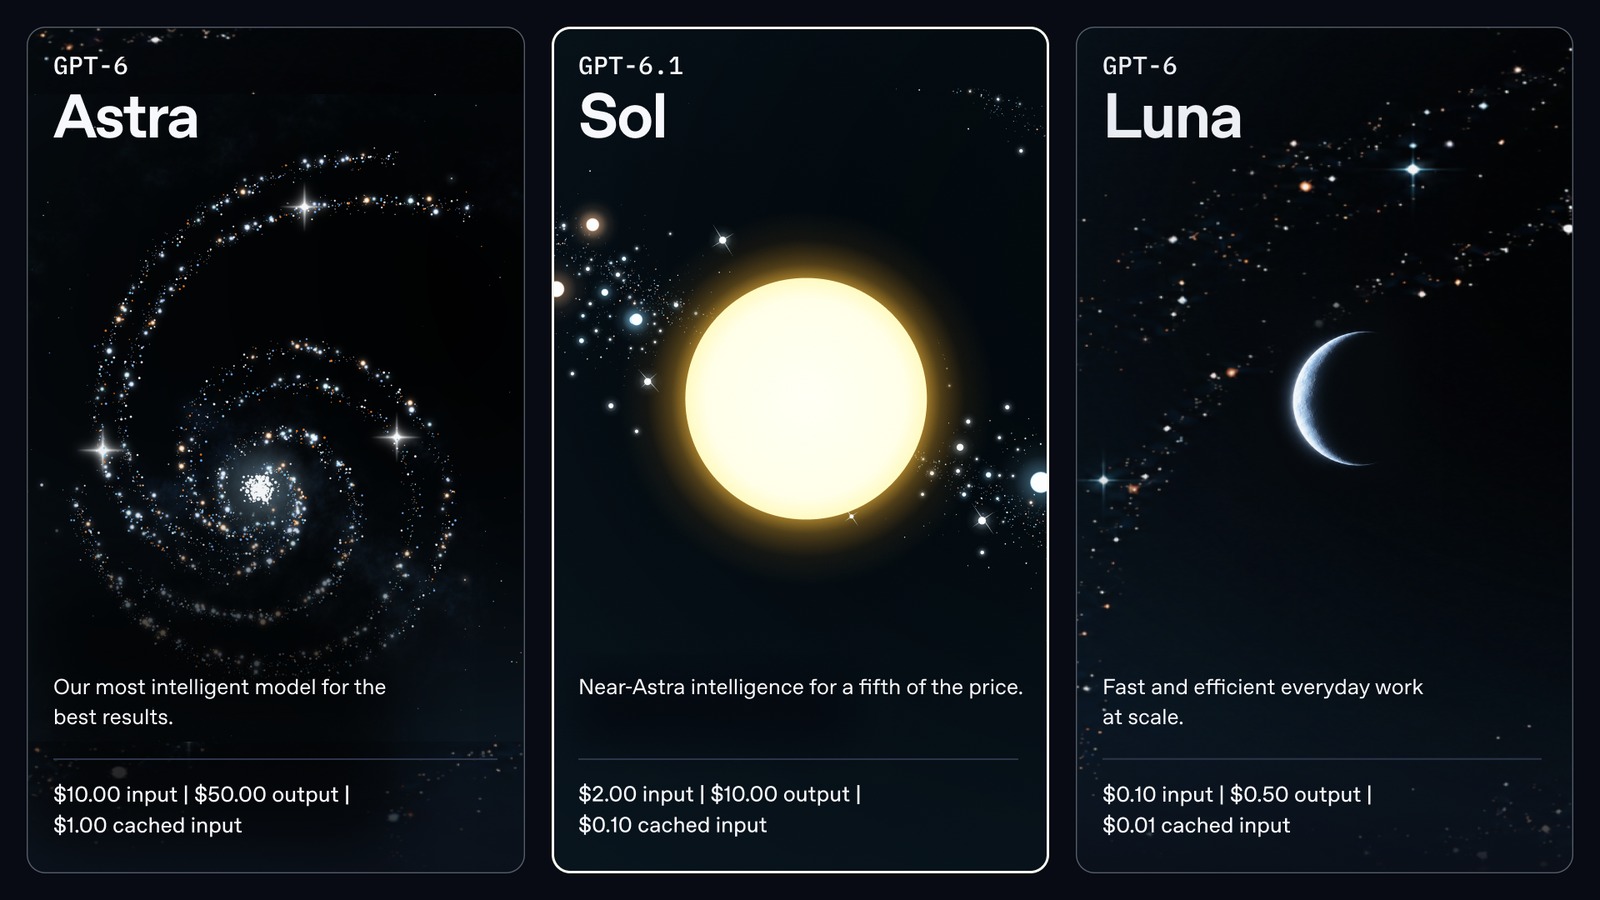
In breve: GPT-6.1 Sol è l’aggiornamento operativo della fascia intermedia OpenAI: mantiene prezzi molto inferiori ad Astra ma, secondo i test del fornitore, riduce il divario su coding agentico, documenti, computer use e workflow. La novità più misurabile è la cache a 0,10 dollari per milione di token, utile per agenti che riutilizzano contesti lunghi.
Prezzi e disponibilità
GPT-6.1 Sol è disponibile nell’API con identificatore gpt-6.1-sol e per utenti Plus, Pro, Business, Enterprise ed Edu in ChatGPT Work e Codex. I prezzi standard sono 2 dollari per milione di token in input, 0,10 per input in cache e 10 per output.
Perché la cache conta per gli agenti
Il costo della cache è metà di quello di GPT-6 Sol e il 95% sotto l’input standard dichiarato. Per agenti che inviano ripetutamente istruzioni, repository o documenti invariati, il vantaggio dipende dalla quota realmente cacheabile e dal numero di chiamate.
Dove OpenAI dichiara i miglioramenti
OpenAI riporta parità con Astra su DeepSWE 1.1 a circa un quinto del costo, progressi su AutomationBench e OSWorld 2.0 e un errore fattuale dal 11,4% al 7,7% a basso effort. Sono misure del fornitore, non una replica indipendente.
Il confine del prodotto
Il modello è gestito nel cloud OpenAI e non sono pubblicati pesi. Non è ancora disponibile nella chat standard. Una modalità Ultrafast, annunciata fino a otto volte più rapida in Codex, è prevista nei giorni successivi e va verificata quando sarà accessibile.
Condizioni e limiti
Costo per task, latenza e qualità cambiano con effort, prompt, strumenti e fallback. I benchmark selezionati non rappresentano tutti i carichi reali e alcune valutazioni competitive derivano da report pubblici. Serve quindi un test sul proprio flusso.
Checklist per valutarlo prima dell’adozione
- Separare input standard, input cacheabile e output nel calcolo dei costi.
- Ripetere un set fisso di task con GPT-6 Sol, GPT-6.1 Sol e Astra.
- Mantenere uguali effort, strumenti, timeout e criteri di successo.
- Misurare qualità, latenza, token, cache hit e costo per task completato.
- Registrare fallback, errori e interventi umani necessari.
- Verificare disponibilità effettiva nel proprio account e nella propria regione.
- Testare limiti, privacy e retention richiesti dal caso d’uso.
- Rivalutare la modalità Ultrafast solo dopo accesso e misure reali.