
L’ANALISI
llama.cpp b11729: supporto corretto per Voyage 4 Nano
Analisi di llama.cpp b11729 per Voyage 4 Nano: attenzione bidirezionale, proiezione dense_2, pooling, compatibilità Qwen3 e checklist di verifica locale.
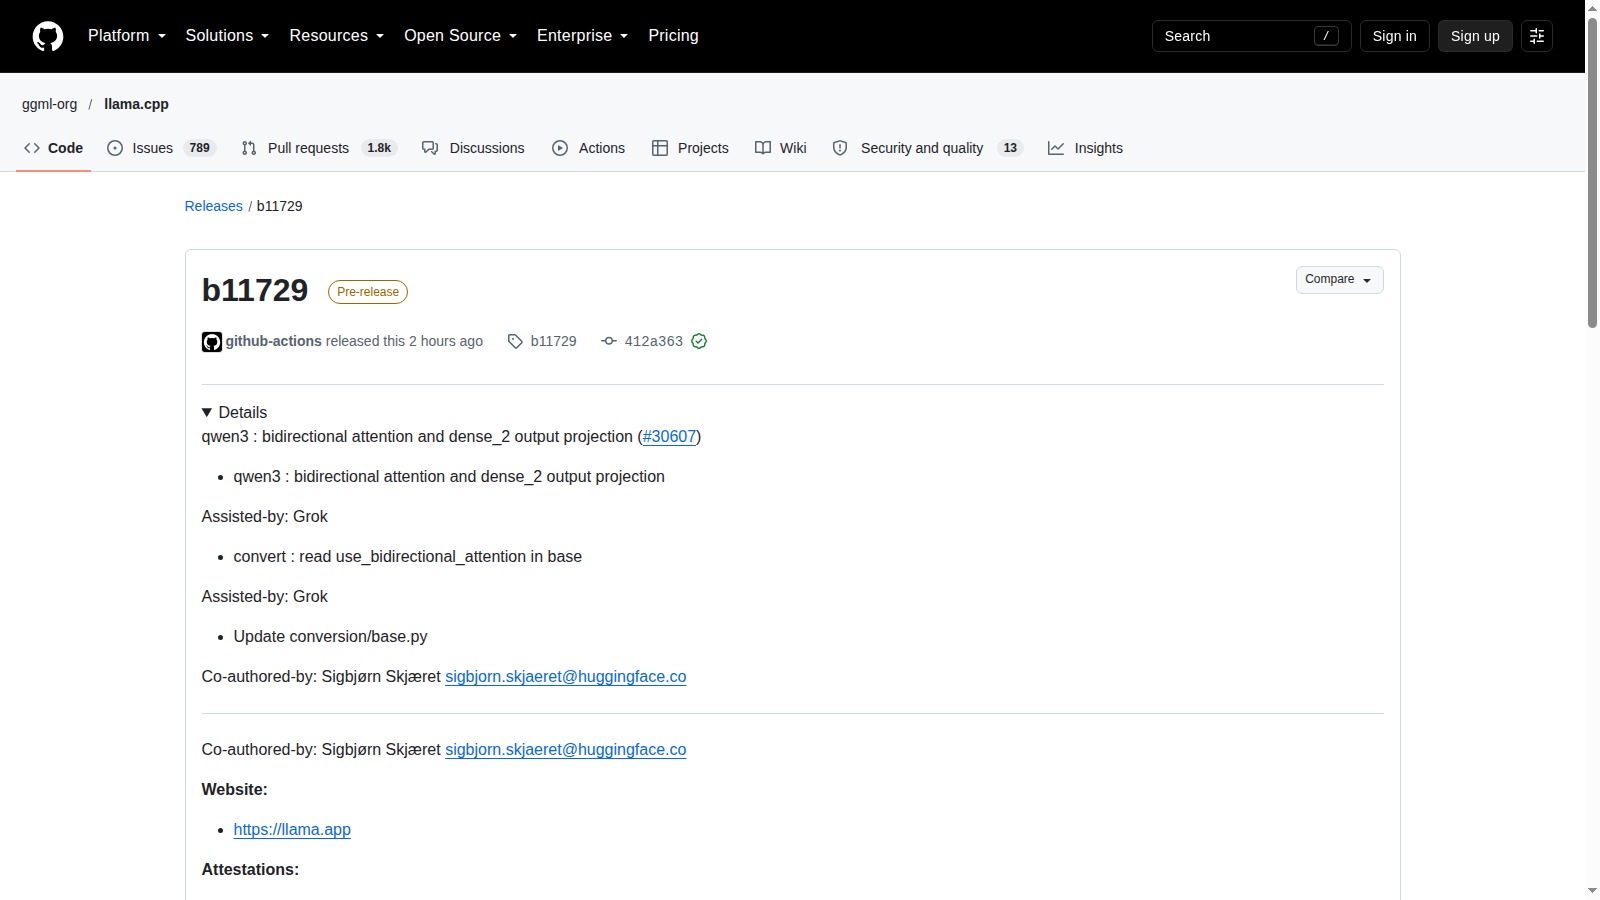
In breve: llama.cpp b11729 rende utilizzabile correttamente Voyage 4 Nano nel percorso Qwen3 perché riconosce il flag use_bidirectional_attention e carica la proiezione dense_2 applicata prima del mean pooling. È un delta pratico per gli embedding locali, ma va ancora verificata la parità degli output sul checkpoint e sulla quantizzazione scelti.
Che cosa cambia nella build b11729
La build pubblicata il 19 ottobre 2026 incorpora la pull request 30607. La correzione riguarda Voyage 4 Nano, un modello embedding con architettura Qwen3 che dichiara l’attenzione bidirezionale tramite use_bidirectional_attention e aggiunge una proiezione lineare finale da 1024 a 2048 dimensioni.
Perché il flag bidirezionale conta
Un modello embedding deve rappresentare l’intera sequenza, non generare il token successivo. Il convertitore guardava soltanto is_causal e poteva quindi perdere il flag specifico del checkpoint. La nuova logica legge anche use_bidirectional_attention, evitando di trattare il modello come un decoder causale ordinario.
La proiezione dense_2 entra nel percorso Qwen3
Il checkpoint include linear.weight senza bias. llama.cpp aveva già una funzione per applicare una proiezione densa dopo il pooling in altre architetture, ma Qwen3 non caricava dense_2. La build b11729 collega il peso al percorso Qwen3 e conserva invariato il caricamento dei checkpoint che non lo contengono.
Che cosa cambia per un test locale
Prima di questa build un file convertito poteva essere accettato senza riprodurre il percorso matematico completo del modello. Ora esiste una base più corretta per confrontare embedding, similarità e ranking in locale. Il test utile non è solo vedere se il modello parte, ma confrontare vettori e ordinamento dei risultati con una baseline di riferimento.
Compatibilità non significa parità automatica
Il merge dichiara compatibilità retroattiva per i checkpoint Qwen3 privi della nuova proiezione. Restano però separati correttezza del convertitore, formato GGUF, quantizzazione, tokenizer, pooling e normalizzazione. Una discrepanza in uno di questi passaggi può cambiare le distanze anche se il processo termina senza errori.
Condizioni e limitazioni
La release corregge conversione e caricamento, ma non dimostra da sola la parità numerica con il runtime di riferimento né la qualità del retrieval dopo una quantizzazione. In questo ciclo sono stati verificati release, pull request e artefatti disponibili, senza eseguire un confronto end-to-end su un corpus locale.
Checklist pratica
- Fissare llama.cpp alla build b11729 e registrare commit, piattaforma e backend usato.
- Scaricare il checkpoint Voyage 4 Nano dalla fonte ufficiale e registrare revisione e hash.
- Convertire il modello senza modificare a mano config, tokenizer o flag di attenzione.
- Verificare nei metadati GGUF la presenza del percorso bidirezionale e del tensore dense_2.
- Preparare un piccolo corpus con query, positivi e negativi noti prima di quantizzare.
- Confrontare dimensione, norma e similarità degli embedding con il runtime di riferimento.
- Ripetere il confronto su almeno una quantizzazione e misurare variazioni nel ranking.
- Conservare comando, log, tempi, memoria e casi in cui l’ordinamento cambia.