|
Ciao,
Qwen3.8 27B è uscito due settimane fa e sta già diventando uno dei modelli locali più interessanti del momento.
Il motivo è semplice: pesa circa 18 GB nella versione Ollama, capisce testo e immagini, può usare strumenti e gira su hardware che una persona normale può davvero comprare. Non serve un rack di GPU.
Poi Alibaba ha fatto una cosa curiosa. Appena dodici giorni dopo ha pubblicato Qwen3.8-Flash-Next: non il successore del 27B, ma un assaggio dell'architettura che userà per Qwen4.
Questa settimana ti spiego la differenza senza sommergerti di sigle: quale puoi usare sul tuo PC, quanto costa via API e perché il modello più grosso non è automaticamente quello giusto per te.
In 30 secondi Qwen3.8 27B: la scelta pratica. 18 GB, Ollama, PC da 24-32 GB.
Flash-Next: l'anteprima di Qwen4. Più forte nei benchmark pubblicati, ma richiede molta più memoria.
Via API: la versione di produzione Qwen3.8-Flash è annunciata a $0,16 in ingresso e $0,47 in uscita per milione di token.
Nel mio Gateway europeo: Qwen3.8 27B, Qwen3.8 Max Open – 2.4T-A95B, Kimi K3, GLM-5V Turbo e Qwen3 Embedding sono già attivi; i modelli chat sono pubblicati nel catalogo e disponibili nei selettori di Studio. Il modello che puoi usare oggi Perché Qwen3.8 27B sta facendo parlare così tanto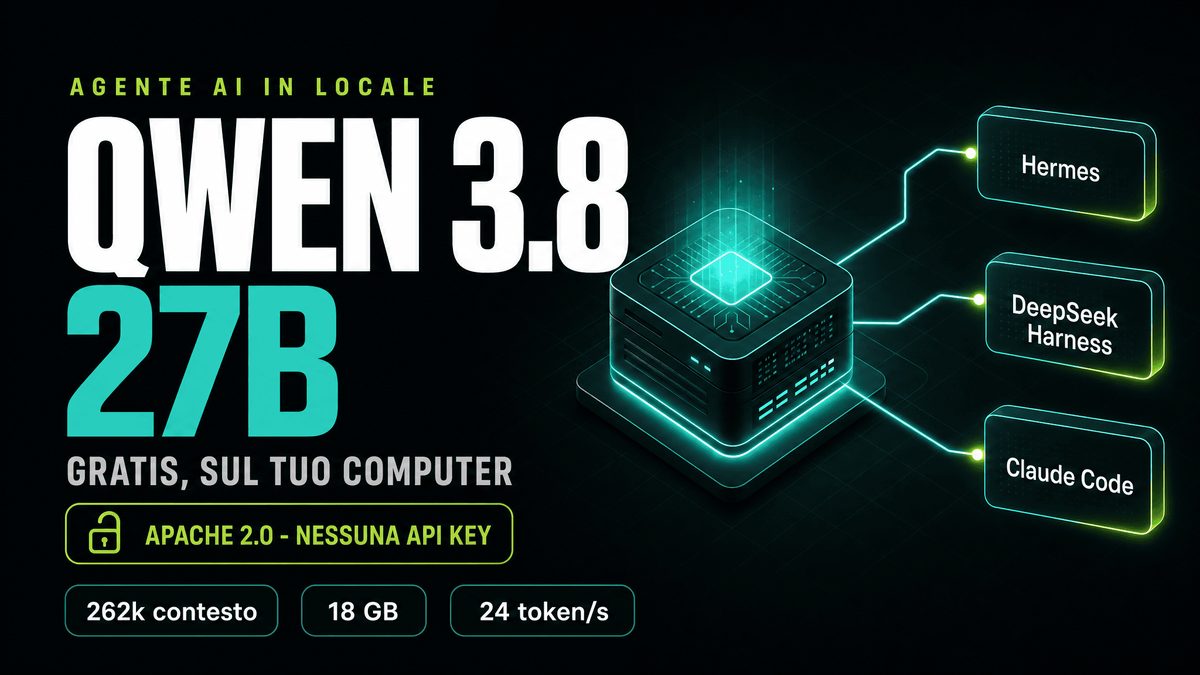 Il 27B è il punto in cui qualità, memoria e facilità d'uso iniziano a stare davvero insieme.
È un modello denso da 27,8 miliardi di parametri: vengono usati tutti a ogni parola generata. La quantizzazione predefinita di Ollama pesa 18 GB e offre 256K di contesto, visione e tool calling.
Non è soltanto una tabella di Alibaba. Artificial Analysis gli assegna 52 punti nel proprio Intelligence Index, contro 38 del precedente Qwen3.6-27B. E sui forum il segnale più interessante non è “batte Opus”: è che un Q4 da circa 17-18 GB viene usato davvero per codice, immagini, reverse engineering e piccoli agenti su una singola GPU consumer.
Il difetto più citato è l'overthinking. Simon Willison ha visto un semplice SVG richiedere 21 minuti e 22.276 token di ragionamento con l'impostazione massima. Altri utenti riportano loop e perdita dell'obiettivo nelle sessioni lunghe. Per questo partirei da low o medium, non da xhigh: il modello resta molto capace e diventa molto più utilizzabile.
ollama run qwen3.8 Questo è davvero tutto per iniziare. Sul mio Beelink con Radeon 8060S e 128 GB di memoria unificata ho misurato circa 24-29 token al secondo nei test di scrittura e riassunto. La velocità è risultata interattiva anche su attività di scrittura, riassunto e uso come agente locale. Il PC giusto per il 27B
16 GB: parte con quantizzazioni aggressive e offload, ma non è la configurazione che consiglierei.
24 GB: è la vera porta d'ingresso: Q4, contesto da 8K-16K e una RTX 3090/4090 o memoria unificata.
32-48 GB: è la fascia migliore: più contesto, quantizzazioni migliori e meno compromessi.
64 GB o più: molto margine, ma non serve comprarli soltanto per questo modello.
Il consiglio emerso dai test della comunità: non inseguire il massimo contesto e il massimo reasoning insieme. Prima verifica che finisca bene il tuo lavoro reale. Installa il 27B e collegalo agli agenti
Dodici giorni dopo Flash-Next non è “il nuovo 27B”. È il laboratorio di Qwen4.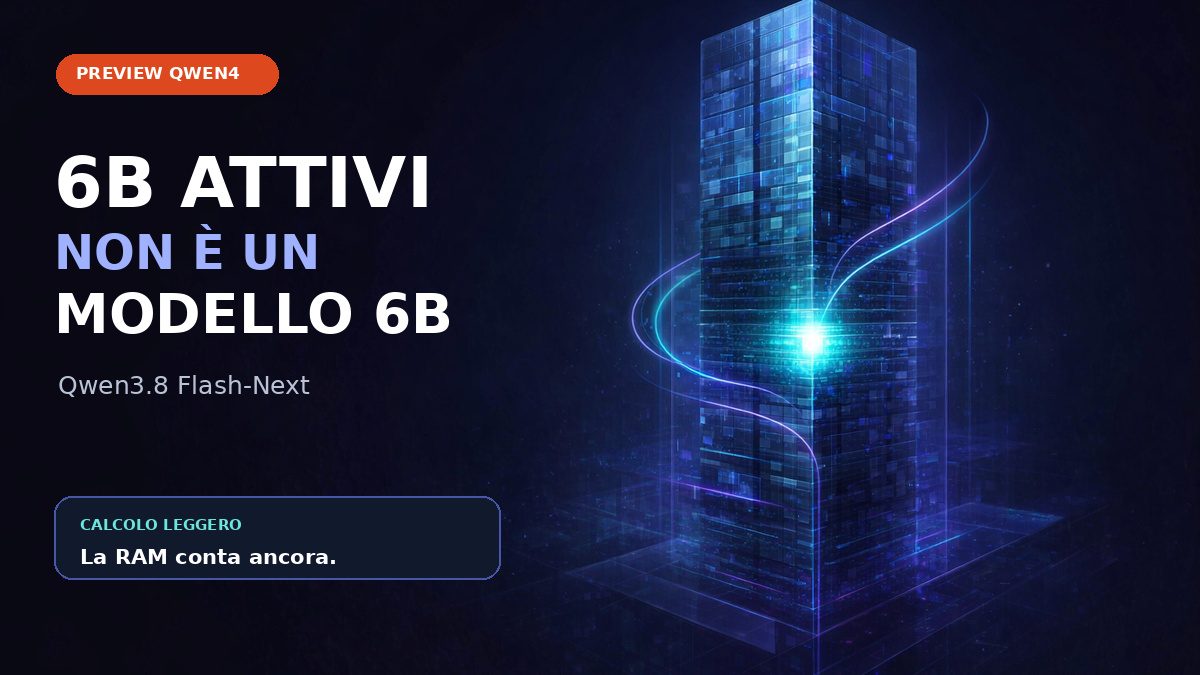
Qwen lo definisce esplicitamente una preview sperimentale dell'architettura che sosterrà Qwen4. È lo stesso ruolo che Qwen3-Next aveva avuto prima di Qwen3.5: mettere fuori i pesi, lasciare che runtime e comunità si preparino, poi usare quelle idee nel prodotto successivo.
Il modello principale ha 125B parametri, ma ne attiva 6B per token. A questi si aggiungono 51B di memoria N-gram e 4B per la previsione di più token. La nuova attenzione alterna tre strati che comprimono la storia a uno che recupera soltanto i blocchi rilevanti. L'obiettivo non è fare il modello più piccolo: è spendere meno calcolo quando il contesto diventa enorme.
Artificial Analysis gli assegna per ora 56 punti, contro 52 del 27B, e misura circa 74 token/s sull'API contro circa 50. È il primo segnale indipendente utile, ma il modello è uscito da appena un giorno e la copertura è ancora preliminare. Nella tabella di Qwen il vantaggio più ampio appare sui lavori agentici: DeepSWE 58,7 contro 42,2 e JobBench 55,7 contro 33,4.
La cosa che quasi tutti i post social spiegano male: “6B attivi” descrive il calcolo fatto per ogni token, non la memoria necessaria. Backbone, esperti e tabella N-gram devono comunque stare in RAM, VRAM o essere letti dallo storage. È un modello che calcola come uno piccolo, ma occupa memoria come uno enorme.
Sul mio Beelink ho usato UD-IQ1_S, llama.cpp, Vulkan e 16K di contesto. Ho misurato 25,84 token/s in generazione, JSON 3/3, tool 3/3 e coding 0/3 per un errore di formato. DeepSeek Harness e Open WebUI hanno superato il test completo. 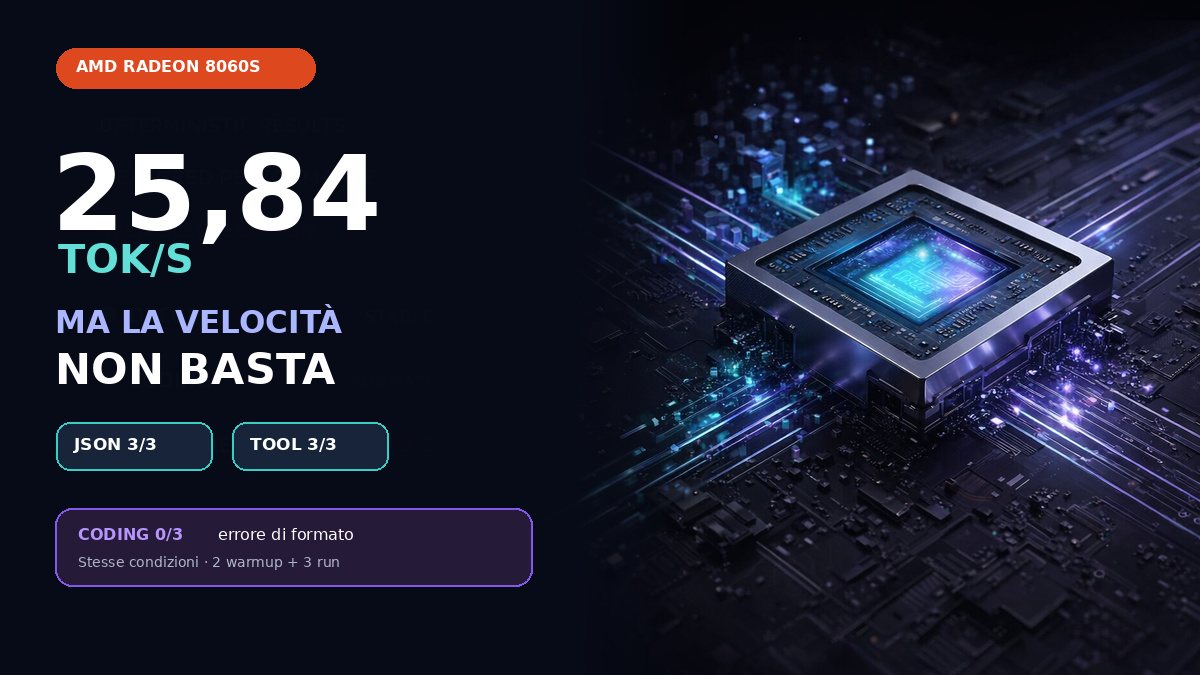 La velocità è già interattiva. IQ1_S, però, serve a rendere possibile il test: non è la configurazione con cui giudicherei il checkpoint originale.
Il PC giusto per Flash-Next
78-80 GB: è il minimo dichiarato per il quant più estremo. Può partire, ma qualità e margine sono il compromesso.
96 GB: minimo consigliato per sperimentare davvero.
110-128 GB: fascia realistica per Q4/NVFP4; l'artifact Ollama MLX pesa 113 GB.
160-192 GB: più qualità, cache e contesto.
360 GB circa: ordine di grandezza dell'artifact BF16.
I primi test su Strix Halo 128 GB riportano circa 20-23 token/s. Il software, però, passa ancora da PR e build sperimentali. Oggi è un laboratorio promettente, non una configurazione semplice per una PMI.
Il comando ufficiale Ollama è ollama run qwen3.8-flash-next:125b-mlx, ma quella variante è MLX per Apple Silicon. Sul mio AMD ho usato llama.cpp/Vulkan.
Locale oppure API
I nuovi modelli sono già attivi nella mia infrastruttura europea
Non tutti vogliono comprare una macchina con 32, 96 o 128 GB di memoria soltanto per provare un modello. Per questo sto ampliando il mio AI Gateway europeo: un solo endpoint compatibile OpenAI, ma modelli differenti per costo, qualità, visione, agenti e ricerca semantica.
Qwen3.8 27B, Qwen3.8 Max Open – 2.4T-A95B, Kimi K3 e GLM-5V Turbo sono già nel catalogo pubblico e nei selettori di MSP Studio. Qwen3 Embedding 8B è attivo sull’endpoint embeddings per RAG e ricerca semantica, quindi non compare correttamente nei picker chat.
Come lo integri nel tuo software
Il Gateway è un’API europea a consumo compatibile con OpenAI. Usi https://ai.mspincloud.com/v1 come base URL e la chiave personale che ti fornisco: SDK OpenAI, agenti, n8n, LangChain e software già compatibili continuano a funzionare senza riscrivere lo stack. Paghi soltanto i token usati, in euro, con budget massimo configurabile. Per i modelli con badge ZDR, prompt e risposte non vengono conservati dal provider; il Gateway registra soltanto i metadati necessari a conteggio e fatturazione.
Perché può servire davvero in azienda
Non basta scrivere “AI Act compliant” su una pagina. Un’impresa deve sapere quali modelli usa, dove vengono elaborati i dati, quali route hanno ZDR, chi può spendere e quali metadati conservare per controllo e fatturazione. Il Gateway riunisce questi elementi dietro un solo endpoint e un catalogo dichiarato. Non rende conforme qualunque progetto da solo, ma semplifica governance, tracciabilità e valutazione del rischio richieste in ambito enterprise.
Qwen3.8 27B EU
€0,43 in · €2,57 out | Qwen3.8 Max Open – 2.4T-A95B EU
€2,68 in · €6,43 out |
Kimi K3 EU
€3,22 in · €16,08 out | GLM-5V Turbo EU
€1,29 in · €4,29 out |
Qwen3 Embedding 8B EU
€0,0215 per milione di token in ingresso · per RAG e ricerca semantica |
Quanto costa rispetto all’upstream?
Il listino MSP è mediamente circa il 25% sopra il costo diretto convertito in euro: non il doppio e non un ricarico nascosto. La differenza finanzia una sola chiave, fattura italiana, budget, catalogo UE/ZDR e supporto. Su alcuni modelli europei sono più caro del provider grezzo; su altri resto sotto servizi comparabili. Il confronto corretto è con la stessa route, regione e politica dati, non soltanto con il nome del modello.
Prezzi per un milione di token. Il 27B è la scelta economica e pratica; Max Open è la base open-weight 2.4T-A95B su cui si fonda il servizio Qwen3.8-Max, ma non include automaticamente visione, strumenti ufficiali e contesto da 1M preconfigurato. Kimi K3 è pensato per lavori agentici lunghi; GLM-5V Turbo per documenti, immagini e video; Qwen3 Embedding alimenta RAG e ricerca. Le deployment selezionate usano infrastruttura UE e Zero Data Retention.
Scopri l’AI Gateway europeo
Cosa arriva dopo
I prossimi modelli che sto seguendo
Flash-Next: arriverà quando sarà disponibile su un endpoint europeo verificato. Granite 4: sto valutando route europea e condizioni di rivendita. Meta Muse Spark 1.1: il modello agentico di Meta già raccontato nell’ articolo dedicato. In osservazione: nuovi Qwen, DeepSeek, Kimi, GLM e MiniMax.
Li aggiungerò solo con route europea, prezzo competitivo e test superati.
Un LLM davvero in tasca
Se non hai mai provato un LLM sullo smartphone Android
Google AI Edge Gallery è probabilmente il modo più semplice per iniziare. Installa l’app, scarica un modello compatibile e prova chat, immagini e Audio Scribe direttamente sul telefono.
La prova che farei subito
1. Scarica completamente il modello.
2. Fai una domanda breve.
3. Attiva la modalità aereo.
4. Ripeti la stessa domanda.
5. Annota tempo al primo token, velocità, calore e batteria.
Serve Android 12 o successivo, ma la versione del sistema non garantisce velocità: contano RAM, SoC e dimensione del modello. L’inferenza può restare locale; download, aggiornamenti e alcune integrazioni continuano invece a richiedere rete.
Prova un LLM offline su Android
Modelli senza filtri: facciamo chiarezza
Uncensored, abliterated e Heretic non sono sinonimi
Un modello “uncensored” può essere soltanto riallineato con un fine-tuning; un modello abliterated interviene invece sui meccanismi di rifiuto. Heretic automatizza un processo di rimozione dell’allineamento, ma non è una scorciatoia da applicare alla cieca. Ho raccolto differenze, misure e rischi in una guida separata.
Capire davvero i modelli uncensored
La scelta praticaVuoi un modello locale oggi? Qwen3.8 27B.
Vuoi studiare l’architettura futura e hai 96-128 GB? Flash-Next.
Vuoi usare i modelli senza comprare hardware? AI Gateway europeo.
Vuoi la prova più semplice possibile? Google AI Edge Gallery su Android.
|