
L’ANALISI
StreamEmbed: memoria visiva locale, risultati e limiti
StreamEmbed indicizza screenshot su M2 Pro in 0,63-0,84 secondi nei test degli autori. I 0,13 GB riguardano l’indice, non tutto l’archivio.
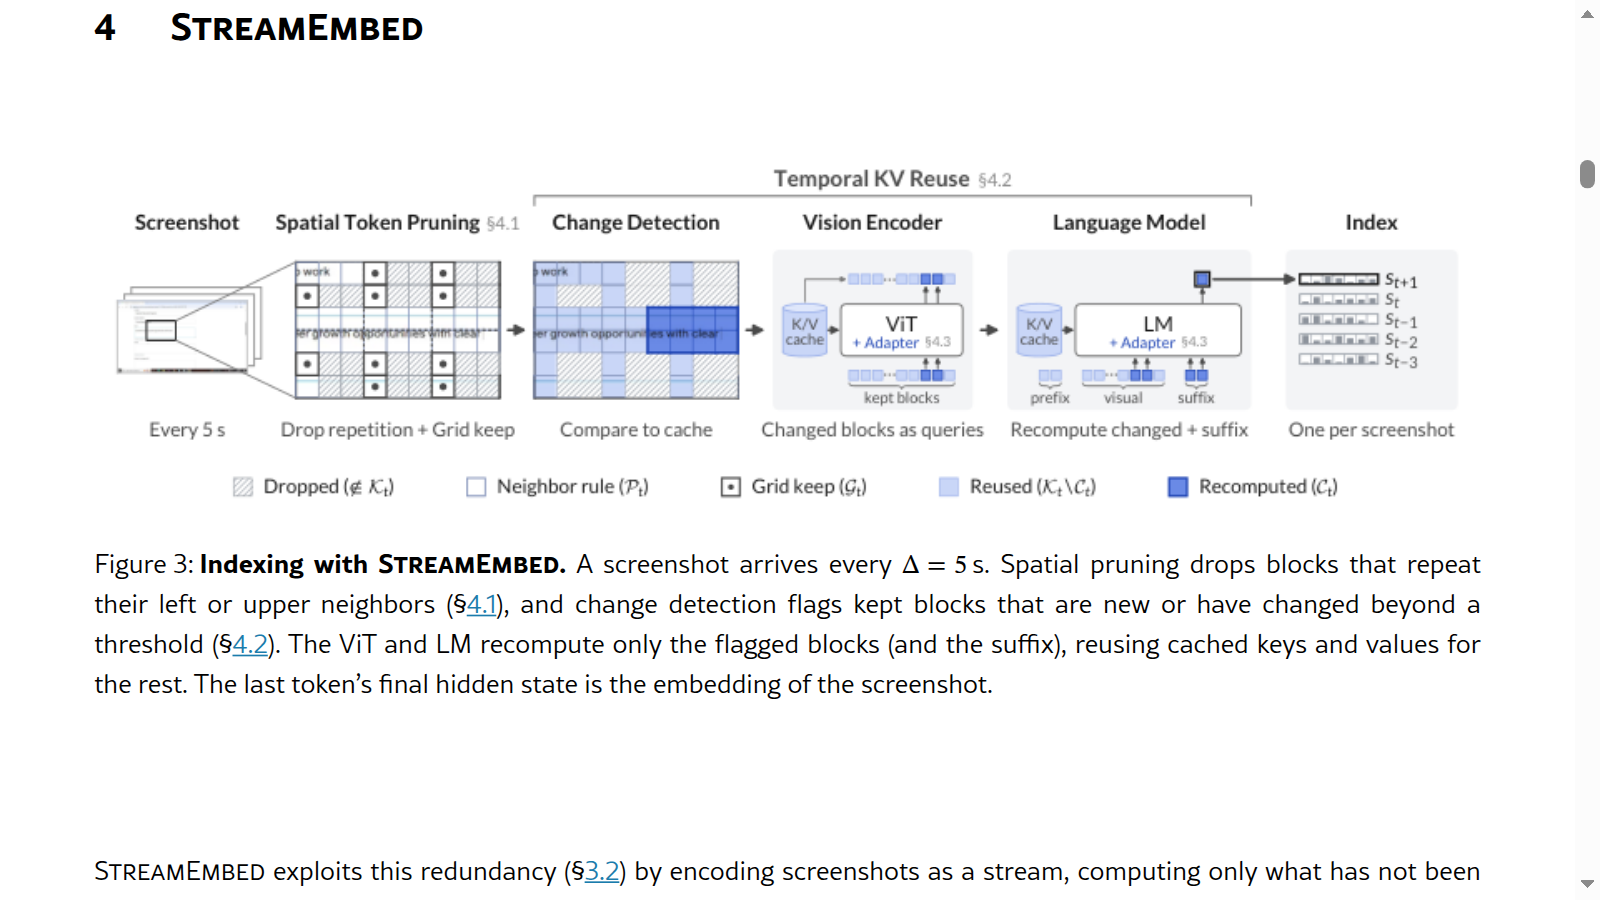
In breve: StreamEmbed cerca screenshot passati con domande in linguaggio naturale e riduce il lavoro ripetuto nell’indicizzazione. Il paper presenta risultati su M2 Pro; non è una nostra prova sul dispositivo. La distinzione decisiva è tra latenza per screenshot, qualità del recupero e spazio complessivo dell’archivio: non sono la stessa misura. StreamEmbed: paper arXiv v1, tabelle 4-6 e appendici.
Metodo: Verifica documentale: letti il paper arXiv v1 del 13 novembre, incluse le appendici sostanziali, il README del repository e l’identità della licenza del codice. Nessuna installazione, acquisizione di schermate personali, inferenza o riproduzione dei benchmark è stata eseguita.
Che cosa si può provare dal repository?
Il README offre una CLI per indicizzare e cercare schermate e un’interfaccia MCP. Il codice è Apache-2.0; pesi e dataset hanno licenze separate. Per un primo esperimento proporrei una cartella sintetica, non il desktop personale: poche schermate costruite per contenere risposte note permettono di capire se il recupero trova davvero ciò che serve. La presenza dei comandi non dimostra che il setup funzioni su ogni computer. StreamEmbed: repository ufficiale, CLI, MCP e licenze separate.
Quanto valgono i tempi riportati su M2 Pro?
La tabella 5 riporta 0,63-0,84 secondi per screenshot con la configurazione 2B, contro 2,33-2,34 del confronto completo. La qualità varia fra le storie osservate. Per decidere se il delta è utile, il tempo medio non basta: proporrei di misurare anche memoria, carico sostenuto e risposte mancanti. L’ablazione separa inoltre il riuso da una diversa implementazione del patch embedding, quindi il guadagno non va attribuito a un solo meccanismo. StreamEmbed: paper arXiv v1, tabelle 4-6 e appendici.
Che cosa significa davvero il dato di 0,13 GB?
La tabella 4 riguarda la RAM dell’indice compresso per un anno simulato. Gli embedding completi restano su SSD per il riordinamento; screenshot, pesi e cache non sono inclusi in quella cifra. Per stimare una postazione reale proporrei tre contatori separati: spazio delle immagini, spazio dei vettori e RAM del processo. Un indice piccolo non rende automaticamente piccola l’intera cronologia, né stabilisce quanto a lungo conservarla. StreamEmbed: paper arXiv v1, tabelle 4-6 e appendici.
Una memoria locale è già una soluzione privata?
Il benchmark usa tre cronologie, due umane e una di un agente; le estensioni pluriennali sono simulate. Questo non sostituisce una verifica di sicurezza. Prima di una prova reale proporrei di stabilire applicazioni escluse, cartelle accessibili, durata della conservazione e modalità di cancellazione. Per l’eventuale collegamento a un agente andrebbe verificato separatamente che cosa può leggere e quali dati invia al proprio modello. Non abbiamo eseguito questi controlli. StreamEmbed: paper arXiv v1, tabelle 4-6 e appendici.
Condizioni e limitazioni
Risultati degli autori su un benchmark limitato, non riprodotti qui. L’indice annuale è simulato; il confronto include scelte implementative. La memoria locale non prova sicurezza, conformità o qualità end-to-end dell’assistente.
Checklist pratica proposta
- Usare soltanto schermate sintetiche, senza credenziali, clienti o conversazioni reali.
- Fissare revisione del codice, modello e licenze prima dell’installazione proposta.
- Preparare domande con risposte note e confrontare i risultati recuperati.
- Misurare separatamente latenza, Recall@10, RAM e spazio su disco.
- Confrontare le stesse schermate, risoluzione e macchina con il percorso completo.
- Verificare isolamento, esclusioni e cancellazione prima di catturare un desktop.
- Controllare i flussi di dati del modello collegato all’interfaccia MCP.