
L’ANALISI
SkillEvaluator 0.9.0: budget e baseline per le skill
SkillEvaluator 0.9.0 aggiunge budget per token, giudizi e tentativi. Confronta versioni delle skill senza confonderle con la baseline senza skill.
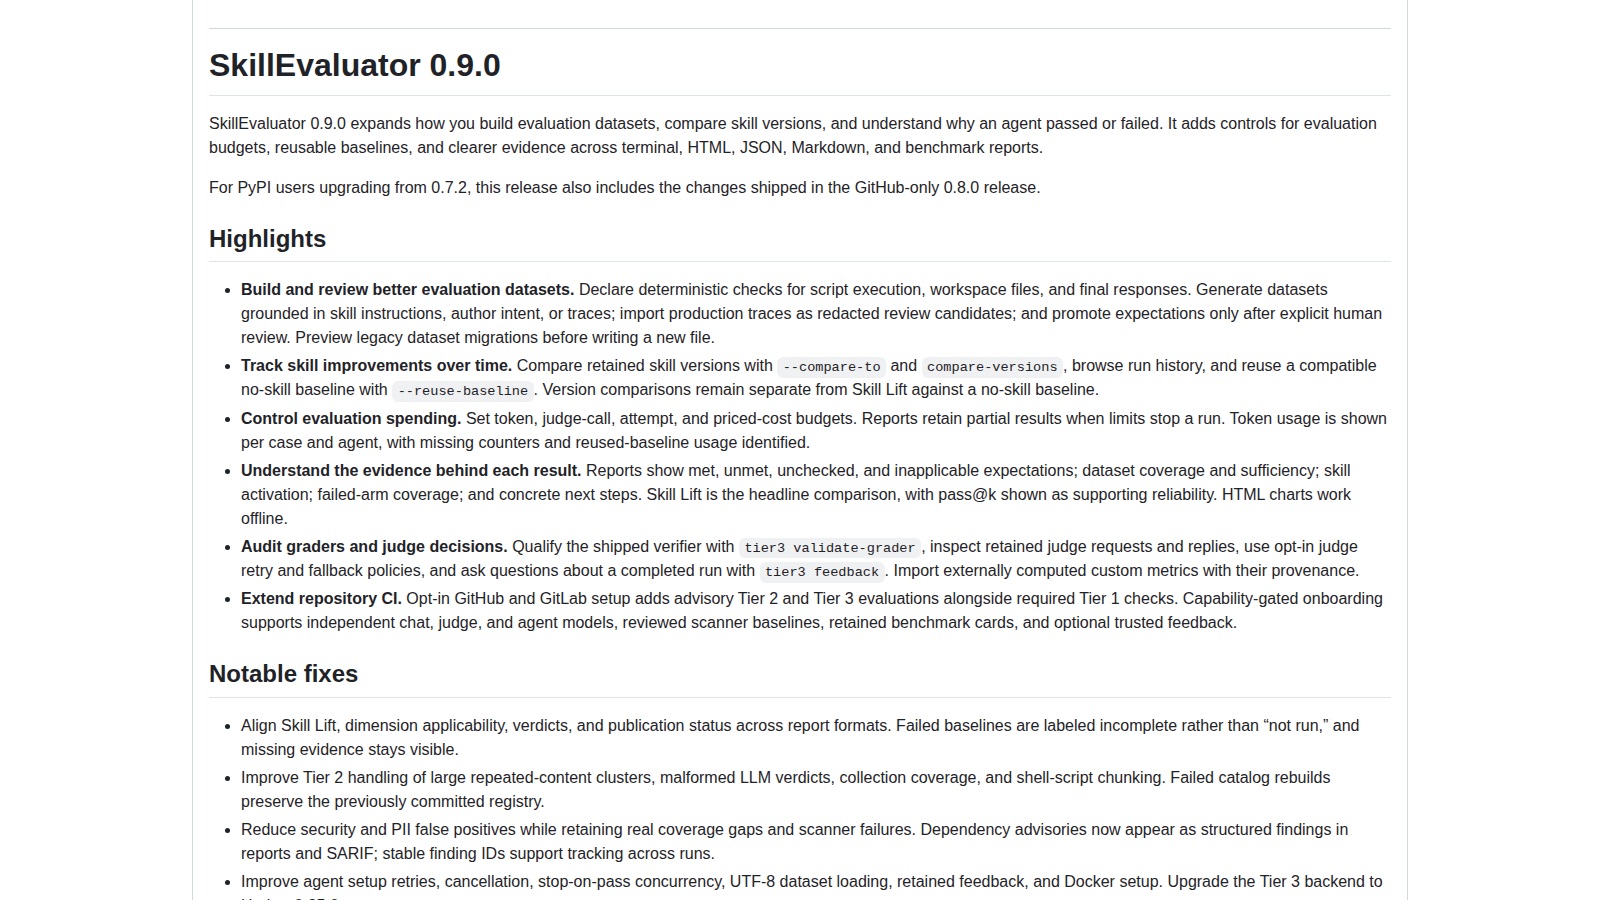
In breve: SkillEvaluator 0.9.0 è un aggiornamento del valutatore di skill NVIDIA che permette di limitare le risorse della valutazione e confrontare versioni conservate. Il confronto tra versioni non equivale allo Skill Lift rispetto all’agente senza skill. La release documenta queste funzioni; nessun benchmark è stato eseguito qui. NVIDIA SkillEvaluator 0.9.0: note della release e limiti di aggiornamento.
Analisi delle note della release v0.9.0, pubblicata il 13 novembre, e del README allo stesso tag. Nessuna installazione, chiamata a modelli, esecuzione Docker o prova di integrazione con Hermes effettuata in questo ciclo.
Quali limiti di valutazione aggiunge la versione 0.9.0?
Le note dichiarano budget per token, chiamate al giudice, tentativi e costi valorizzati. Quando un limite interrompe il lavoro, il report conserva ciò che è stato eseguito e rende visibili contatori mancanti o baseline riusate. Il vantaggio operativo è poter delimitare una valutazione prima di avviarla. Non significa però che ogni contatore sia disponibile per ogni backend, né che il costo osservato coincida automaticamente con la fattura del provider.
NVIDIA SkillEvaluator 0.9.0: note della release e limiti di aggiornamento.
Confrontare due skill è lo stesso che misurare lo Skill Lift?
No. La release distingue il confronto fra versioni conservate, con --compare-to e compare-versions, dal confronto con una baseline senza skill. Quest’ultimo serve a chiedersi se la skill aggiunga qualcosa al risultato dell’agente. Il riuso con --reuse-baseline è previsto per baseline compatibili: prima di interpretare un miglioramento vanno controllati dataset, modello e condizioni. Il confronto va progettato per verificare l’esito del compito, non per premiare la semplice citazione del nome della skill.
NVIDIA SkillEvaluator 0.9.0: note della release e limiti di aggiornamento.
Quali parti sono statiche e quali richiedono modelli?
Il README separa controlli di qualità, deduplicazione e valutazione live. Mostra un primo percorso deterministico senza API key, GPU o Docker; quel controllo statico non misura da solo l’efficacia di un agente. La valutazione live richiede invece accesso al provider, un agente supportato e una sandbox in esecuzione. Il controllo di sicurezza completo richiede anche scanner esterni. La disponibilità del pacchetto non prova quindi che tutti i livelli siano già operativi nella propria installazione.
README versionato: controlli statici, livelli di valutazione e requisiti.
Che cosa controllare prima di aggiornare una pipeline CI?
La 0.9.0 cambia alcuni criteri di grading e raccomanda di rivalutare prima di confrontare i punteggi con release precedenti. Nei workflow CI all-tier, Tier 3 resta advisory: i vecchi parametri tier3-required non lo trasformano più in un gate obbligatorio. Aggiornare il pacchetto Python non aggiorna silenziosamente un workflow già fissato a una versione. Le note qualificano infine il nuovo supporto Hermes come sperimentale: non è una garanzia di compatibilità con qualunque provider o sandbox.
NVIDIA SkillEvaluator 0.9.0: note della release e limiti di aggiornamento.
Checklist pratica proposta
- Fissare il tag v0.9.0 e conservare dataset, configurazione e versione del workflow usati nella prova.
- Scegliere un piccolo compito con un esito osservabile e aspettative valide anche senza skill.
- Separare baseline senza skill e confronto fra versioni, verificando quando un riuso sia compatibile.
- Impostare i budget supportati prima delle chiamate live e annotare i contatori non disponibili.
- Non chiamare completo un report con timeout qualificati, aspettative non verificate o prove interrotte.
- Controllare scanner, credenziali e sandbox separatamente; trattare Hermes come percorso sperimentale.
Condizioni e limitazioni
I risultati dipendono da dataset, modello, giudice e sandbox. I report parziali non sono una valutazione completa; il supporto Hermes della release è sperimentale e non è stato provato qui.