
L’ANALISI
llama.cpp su IBM Z: BF16, Q8_0 e limiti del percorso VXE
llama.cpp b12209 aggiunge BF16 e Q8_0 VXE per IBM Z e LinuxONE. Il percorso Q8_0 richiede m e n pari; i test upstream non migliorano sempre.
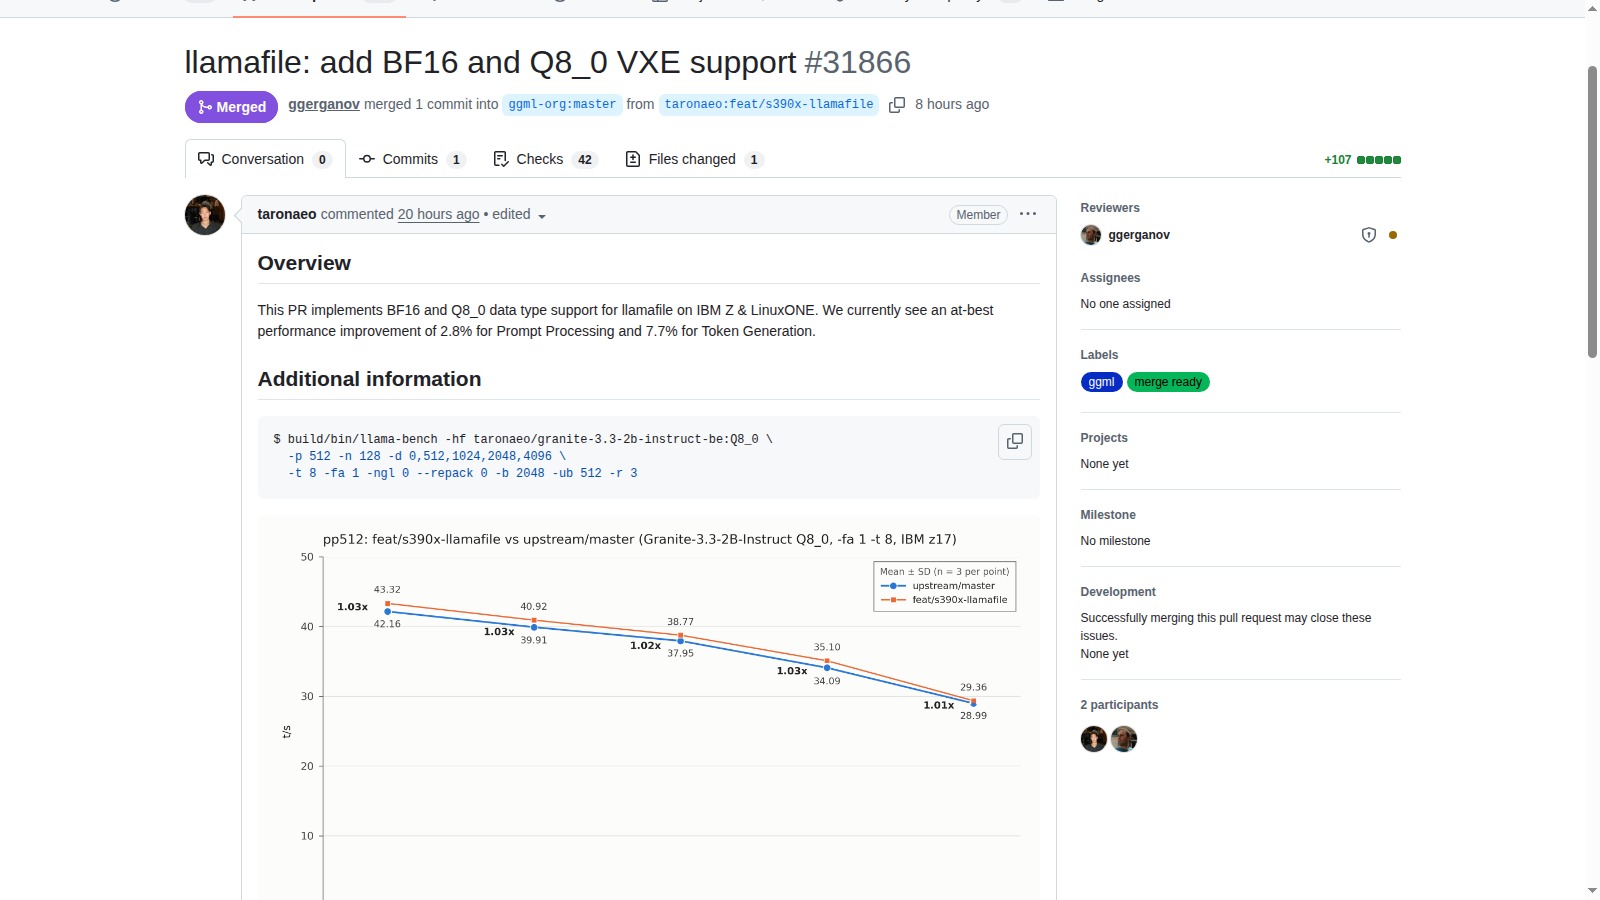
In breve: llama.cpp b12209 aggiunge supporto BF16 e Q8_0 nei percorsi VXE del codice llamafile destinati a IBM Z e LinuxONE. Per il ramo Q8_0 la patch richiede m e n pari. È un’aggiunta specifica del backend: i dati della PR non sostengono un miglioramento costante della generazione. PR 31866: supporto BF16 e Q8_0 VXE per IBM Z e LinuxONE.
Sono stati letti la PR 31866, il diff, il commit integrato e la prerelease. Non è stato usato hardware IBM Z o LinuxONE e non abbiamo eseguito i benchmark; le osservazioni prestazionali si riferiscono esclusivamente alla tabella upstream.
Quale parte di llama.cpp viene modificata?
La modifica riguarda ggml/src/ggml-cpu/llamafile/sgemm.cpp. Aggiunge il caricamento BF16 e un’implementazione Q8_0 vettoriale nelle diramazioni protette da __VXE__ o __VXE2__. La PR indica esplicitamente IBM Z e LinuxONE: non presenta un aggiornamento generale di tutte le CPU e non equivale a una nuova release autonoma dell’intero progetto llamafile.
PR 31866: supporto BF16 e Q8_0 VXE per IBM Z e LinuxONE · Diff ufficiale: BF16, kernel Q8_0 e condizioni del dispatch.
Perché le dimensioni pari contano nel percorso Q8_0?
Il nuovo codice organizza il risultato in blocchi 2×2. Prima del dispatch Q8_0 controlla m e n: se una delle due dimensioni è dispari restituisce false invece di utilizzare questo ramo. Il percorso BF16 ha una condizione distinta sul tipo dell’operando. Questi vincoli vanno verificati quando si attribuisce una misura all’implementazione nuova.
Diff ufficiale: BF16, kernel Q8_0 e condizioni del dispatch.
La tabella della PR mostra sempre un miglioramento?
No. Sul Granite 2B Q8_0 indicato dal contributore, pp512 passa da 42,16 a 43,32 token/s. Per tg128 con profondità 2048 la tabella riporta 7,49 contro 8,07 token/s; a profondità 1024 riporta invece 10,22 contro 10,06, e a 4096 passa da 5,67 a 5,59. I valori migliori citati nell’introduzione non riassumono quindi tutti i casi, né dimostrano un’accelerazione BF16 misurata con quel modello Q8_0.
PR 31866: supporto BF16 e Q8_0 VXE per IBM Z e LinuxONE.
Come confrontarla senza confonderla con b12202?
b12209 è la prerelease pubblicata l’8 novembre 2026 che contiene la PR 31866. Il fatto qui verificato è l’aggiunta di implementazioni VXE per due tipi di dati. La precedente notizia sulle richieste di precisione BF16 riguarda un altro diff. Per una prova controllata, mantenere fisso il modello, separare prompt e generazione e confrontare più profondità di contesto prima di scegliere la revisione da usare.
PR 31866: supporto BF16 e Q8_0 VXE per IBM Z e LinuxONE · llama.cpp b12209, prerelease dell’8 novembre 2026 · Commit integrato a3c7cf08: percorsi VXE nel codice llamafile.
Condizioni e limitazioni
I percorsi aggiunti sono protetti da __VXE__ o __VXE2__. La PR usa Granite 2B Q8_0 e otto thread; alcuni test tg128 sono più lenti della baseline. Nessuna prestazione propria misurata.
Checklist pratica
- Verificare che l’ambiente IBM Z o LinuxONE e la build espongano il percorso VXE previsto.
- Annotare b12209 e il commit a3c7cf08f98fd769f246fcb72be8872d54ff3c35.
- Separare il test Q8_0 dal test BF16 e controllare m e n nel ramo Q8_0.
- Usare lo stesso checkpoint e otto thread se si confronta il caso descritto nella PR.
- Misurare più profondità di contesto, conservare anche le regressioni e mantenere una baseline ripristinabile.