
L’ANALISI
llama.cpp: fast path CUDA per SSM_SCAN a 64 stati
llama.cpp b12207 aggiunge un percorso CUDA per SSM_SCAN con 64 stati. Non dimostra il supporto completo a Zamba2; nessun test locale eseguito.
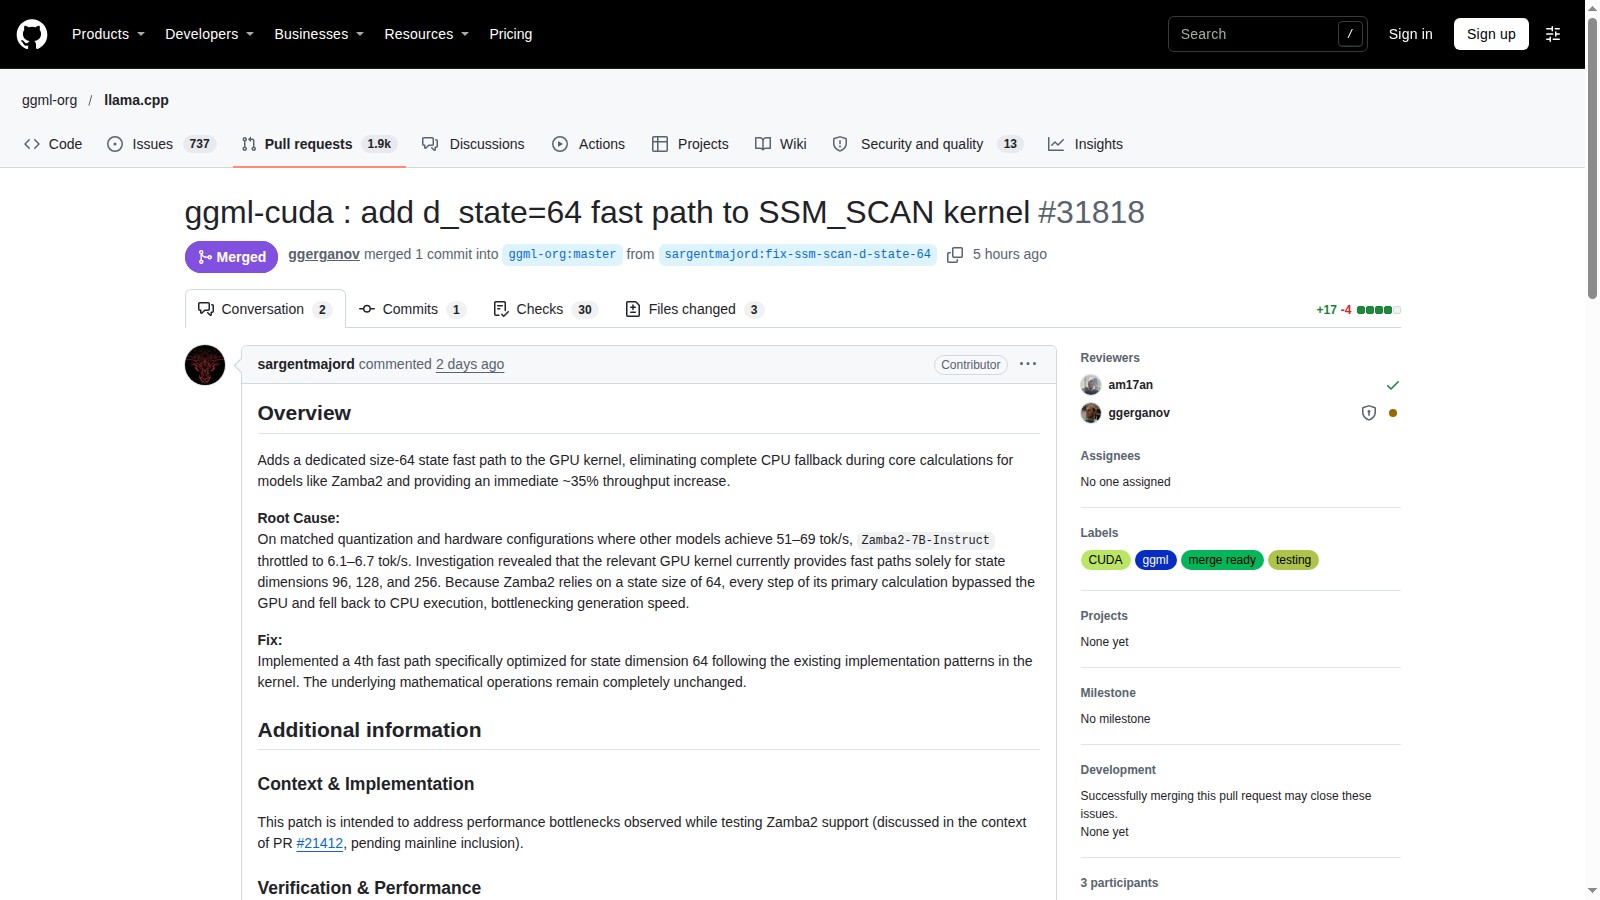
In breve: llama.cpp b12207 ammette d_state=64 nel percorso CUDA SSM_SCAN di tipo Mamba-2 e aggiunge il relativo lancio del kernel. È utile alle forme di calcolo richiamate dalla PR per Zamba2, ma non certifica il supporto completo di quell’architettura o l’assenza di fallback CPU. Non abbiamo compilato il codice né eseguito i test o l’inferenza. PR 31818: percorso CUDA SSM_SCAN con d_state=64 e limiti dichiarati.
Verifica documentale dell’8 novembre 2026 tramite nuove acquisizioni HTTP di release, PR 31818, diff di tre file, commit e riferimento del tag. Il tag b12207 punta a 998200491327347eed85f007e4de7a1a7c871453. Merge alle 14:48:20 e pubblicazione della prerelease alle 15:20:48, ora italiana. I risultati citati sono dichiarazioni upstream, non test eseguiti da noi.
Che cosa significa il percorso rapido per 64 stati?
Il controllo CUDA del ramo SSM_SCAN di tipo Mamba-2 ammetteva dimensioni dello stato 96, 128 e 256. Il diff aggiunge 64 e mantiene il vincolo della dimensione della testa multipla di 16. Nel kernel viene istanziato il caso dedicato dentro il ramo già esistente: il cambiamento verificabile è l’estensione delle forme gestite, non una nuova equazione del modello.
Diff ufficiale: controllo CUDA, kernel e tre casi di test · Kernel SSM_SCAN fissato al merge della PR 31818.
Perché questo non equivale al supporto completo di Zamba2?
La descrizione nasce da prove sul supporto a Zamba2 e richiama un lavoro di integrazione separato. Questa PR modifica il controllo di supporto CUDA, il kernel SSM_SCAN e i test dell’operatore; non contiene da sola l’integrazione dell’intera architettura. Il contributore segnala inoltre un’ulteriore causa di fallback CPU ancora da chiarire. Non deduciamo quindi che un modello Zamba2 si carichi ed esegua interamente sulla GPU nella build distribuita.
PR 31818: percorso CUDA SSM_SCAN con d_state=64 e limiti dichiarati · Diff ufficiale: controllo CUDA, kernel e tre casi di test · Commit integrato del fast path SSM_SCAN a 64 stati.
Quali verifiche sono presenti e quali abbiamo eseguito?
Il diff aggiunge due casi SSM_SCAN con stato 64, inclusa una forma di decodifica a singolo token, e un caso con fusione della cache. La PR dichiara 28 test superati su 28 confrontando con il riferimento CPU. Abbiamo verificato la presenza dei casi nel codice, non l’esito dei test: non abbiamo compilato, eseguito la suite o controllato gli output su hardware.
PR 31818: percorso CUDA SSM_SCAN con d_state=64 e limiti dichiarati · Diff ufficiale: controllo CUDA, kernel e tre casi di test · Commit integrato del fast path SSM_SCAN a 64 stati.
I token al secondo riportati sono trasferibili?
No. Il contributore riporta circa 11 token/s prima e 15,1 dopo nella propria prova su Zamba2-7B-Instruct, ma descrive anche fallback CPU residui per circa il 28% delle operazioni interessate. Sono osservazioni upstream in uno specifico contesto di integrazione, non prestazioni misurate qui o garantite dalla prerelease. Non le confrontiamo con GPU o modelli diversi per ricavarne una classifica.
PR 31818: percorso CUDA SSM_SCAN con d_state=64 e limiti dichiarati · llama.cpp b12207: prerelease ufficiale.
Come preparare una verifica senza confondere kernel e modello?
Separare tre controlli: caricamento dell’architettura nella revisione scelta, correttezza dell’operatore nelle forme richieste e prestazioni dell’intero modello. Registrare build, backend, file e quantizzazione del modello, dimensioni dei tensori e fallback osservati. Solo dopo confrontare due revisioni con lo stesso carico. Questa è una procedura proposta; non descrive prove effettuate per questo articolo.
PR 31818: percorso CUDA SSM_SCAN con d_state=64 e limiti dichiarati · Diff ufficiale: controllo CUDA, kernel e tre casi di test · Riferimento ufficiale del tag b12207.
Condizioni e limitazioni
Un fast path del kernel non dimostra il supporto completo a Zamba2. Il contributore segnala ancora circa il 28% di operazioni interessate in fallback CPU nelle proprie prove. I 28 test superati e il passaggio da circa 11 a 15,1 token/s sono dichiarati nella PR, non replicati da noi; nessuna compilazione o inferenza locale eseguita.
Checklist pratica
- Verificare separatamente che la revisione scelta supporti il caricamento dell’architettura desiderata.
- Controllare se il carico richiede SSM_SCAN con stato 64 e rispetta i vincoli del ramo CUDA interessato.
- Annotare versione della build, GPU, backend, modello e quantizzazione prima di confrontare i tempi.
- Distinguere correttezza dell’operatore, fallback CPU residui e velocità dell’intero modello.
- Non presentare i test o i token/s della PR come misure locali; conservare la revisione precedente per il rollback.