
L’ANALISI
llama.cpp: cache MoE e CPU, cosa cambia in b12206
llama.cpp b12206 riordina il grafo della cache MoE. Il 7-9% dichiarato riguarda Gemma 4 su RTX 5090; nessun benchmark locale eseguito.
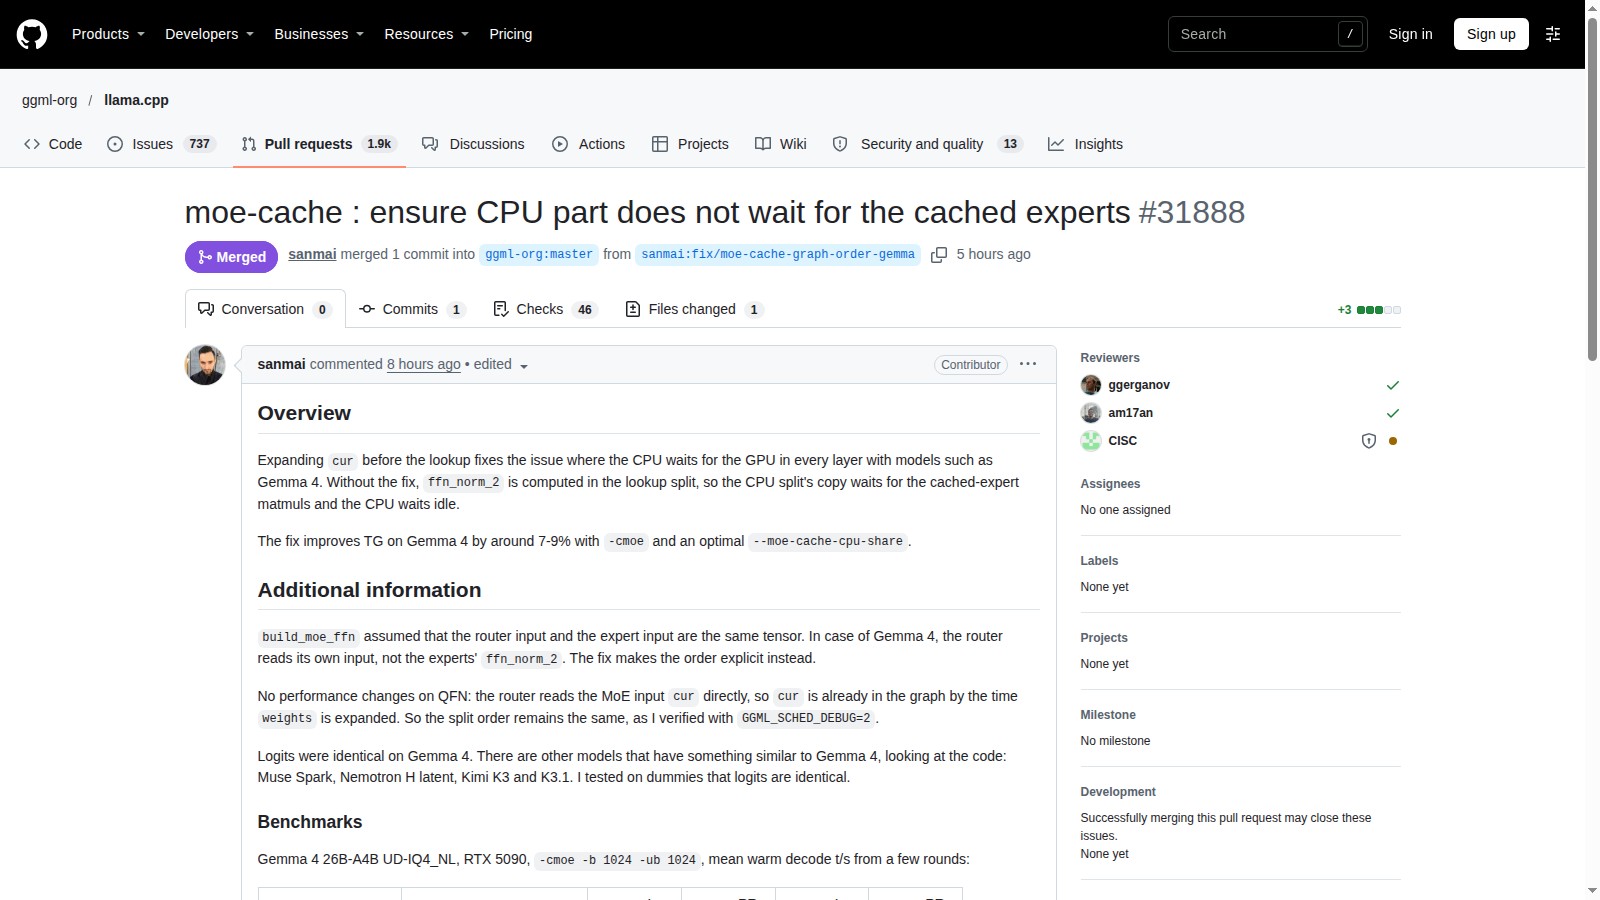
In breve: llama.cpp b12206 aggiunge l’espansione dell’input degli esperti prima del lookup della cache MoE, così lo scheduler può prepararlo per la parte CPU senza aspettare il calcolo degli esperti già in cache sulla GPU. La correzione interessa il percorso in cui router ed esperti possono ricevere input differenti. Non dimostra un aumento generale della velocità e non è stata provata in inferenza da noi. PR 31888: ordine del grafo MoE e attesa della parte CPU.
Verifica documentale dell’8 novembre 2026: nuove acquisizioni HTTP della prerelease, della PR 31888, del diff di un file, del commit e del tag ufficiale. Il tag punta al merge cf34d311332e362198f0a410c466d1e940287d02. Merge alle 14:29:12 e pubblicazione della prerelease alle 15:01:08, ora italiana. Nessuna compilazione, inferenza o prova prestazionale eseguita da noi.
Perché la CPU poteva aspettare gli esperti sulla GPU?
La PR descrive un’assunzione troppo restrittiva: router ed esperti avrebbero usato lo stesso tensore di input. In Gemma 4 il router legge invece un input distinto da ffn_norm_2. Secondo il contributore, il vecchio ordinamento collocava questa normalizzazione nel segmento del lookup, facendo attendere la copia destinata alla CPU anche il calcolo degli esperti già presenti in cache.
PR 31888: ordine del grafo MoE e attesa della parte CPU.
Che cosa cambia nel grafo, senza cambiare i pesi?
In build_moe_ffn viene aggiunta ggml_build_forward_expand(gf, cur), subito dopo l’espansione di weights e prima della logica della cache. Il diff contiene tre righe aggiunte in src/llama-graph.cpp, compreso il commento che ne spiega lo scopo. Il delta verificato riguarda l’ordine delle dipendenze nel runtime, non un nuovo checkpoint o una nuova politica di scelta degli esperti.
Diff ufficiale: input degli esperti prima del lookup · Commit integrato: tre righe in llama-graph.cpp · Codice del grafo fissato al merge della PR 31888.
Quanto valgono davvero i numeri riportati nella PR?
Il contributore parla di circa 7-9% in generazione per Gemma 4 con cache MoE e quota CPU adeguata. La tabella riguarda Gemma 4 26B-A4B UD-IQ4_NL su RTX 5090, con differenti dimensioni di cache, quote CPU e modalità di caricamento. Alcune celle rimangono quasi invariate; il confronto interamente GPU senza cache non mostra un beneficio. Non estendiamo questi risultati a tutti i MoE e non li abbiamo replicati.
PR 31888: ordine del grafo MoE e attesa della parte CPU.
È la stessa correzione della cache del draft?
No. Nel Radar erano già presenti ClassLRU, la calibrazione CPU della cache e la correzione b12201 per il draft denso. Il nuovo diff riguarda invece il momento in cui l’input degli esperti entra nel grafo. La distinzione operativa è fra selezionare gli esperti da conservare, configurare due modelli separati e permettere alla CPU di iniziare il proprio lavoro senza quella dipendenza superflua.
PR 31888: ordine del grafo MoE e attesa della parte CPU · Diff ufficiale: input degli esperti prima del lookup.
Come preparare un confronto utile sul proprio sistema?
Prima verificare di usare davvero cache MoE e calcolo CPU degli esperti mancanti. Poi conservare due revisioni identificabili, mantenendo fissi file del modello, quantizzazione, dimensione della cache, quota CPU e modalità di caricamento. Una futura prova dovrebbe separare riscaldamento, elaborazione del prompt e generazione, controllando anche la correttezza degli output. È una procedura proposta, non un test eseguito per questo articolo.
PR 31888: ordine del grafo MoE e attesa della parte CPU · llama.cpp b12206: prerelease ufficiale · Riferimento ufficiale del tag b12206.
Condizioni e limitazioni
Il 7-9% è una stima del contributore per Gemma 4 con cache MoE e quota CPU opportunamente scelta, non un risultato locale o trasferibile ad altri sistemi. La PR riporta anche casi quasi invariati e nessun cambiamento nel confronto interamente GPU senza cache MoE. Non abbiamo eseguito compilazioni, inferenza o benchmark.
Checklist pratica
- Verificare che il carico usi la cache MoE e la quota CPU, non soltanto esecuzione interamente GPU.
- Annotare revisione, modello, quantizzazione, GPU, dimensione della cache e modalità di caricamento.
- Tenere fissa la quota CPU nel primo confronto; valutarne la calibrazione soltanto in un passaggio separato.
- Misurare separatamente riscaldamento, prompt e generazione, conservando input e output per controlli di correttezza.
- Non trasformare il 7-9% dichiarato su Gemma 4 in una promessa per ogni sistema; mantenere una versione di rollback.