
L’ANALISI
llama.cpp b12202: che cosa cambia tra BF16 e F32
llama.cpp b12202 passa alcune richieste da F32 a BF16. La flash attention CPU mantiene accumuli F32: nessuno speedup locale misurato.
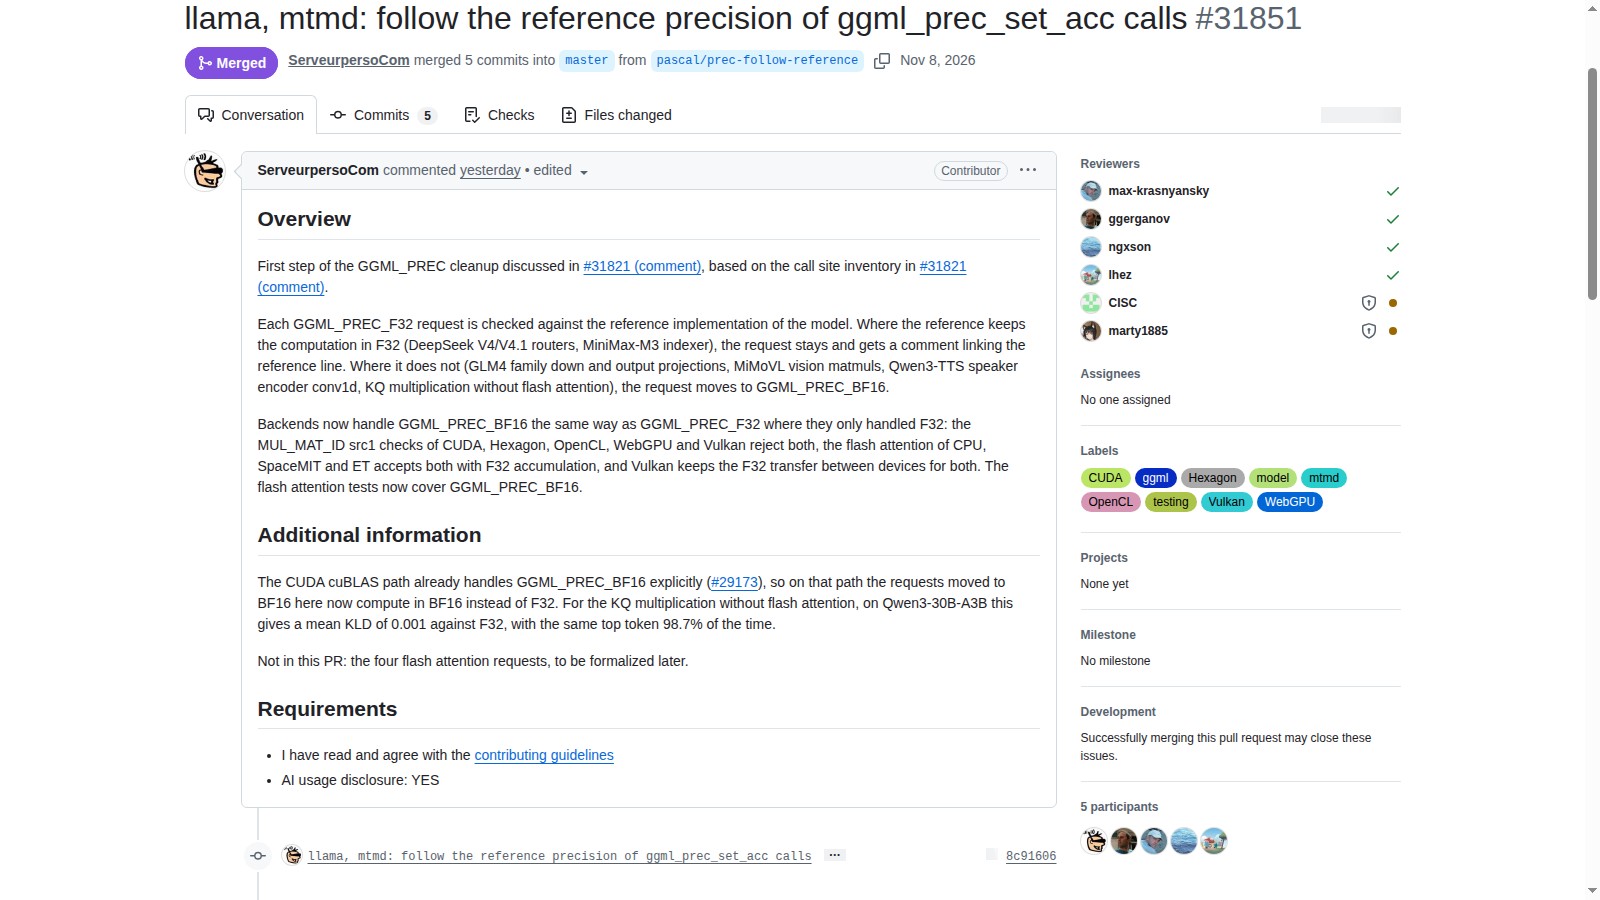
In breve: llama.cpp b12202 cambia alcune richieste di precisione da F32 a BF16 per seguire le implementazioni di riferimento. Non significa che tutto il calcolo passi a BF16: la flash attention CPU mantiene accumulazioni F32, mentre altri percorsi hanno regole differenti. Per valutare il risultato bisogna conoscere backend, operazione e revisione, non soltanto la sigla del formato. Pull request 31851: precisione richiesta e implementazioni di riferimento.
Analisi documentale della prerelease, della pull request e del diff di 17 file acquisiti l'8 novembre. Il merge è delle 08:37 e la pubblicazione API delle 09:11, ora italiana. Le pagine pubbliche e l'API non erano tutte allineate durante l'acquisizione; il successivo accesso ha incontrato errori di rete. Le copie primarie sono conservate con hash. Nessun test runtime o confronto di prestazioni riprodotto.
Quali richieste passano da F32 a BF16?
La pull request verifica le richieste rispetto alle implementazioni di riferimento. Passano a BF16 alcune proiezioni della famiglia GLM4, le moltiplicazioni dell'encoder visivo MiMoVL, una convoluzione dell'encoder speaker Qwen3-TTS e il prodotto KQ nel percorso senza flash attention. I router DeepSeek V4 e V4.1 e l'indexer MiniMax-M3 restano in F32 con rimandi al codice di riferimento. Non è quindi una sostituzione globale di tutte le richieste F32.
Pull request 31851: precisione richiesta e implementazioni di riferimento · Diff ufficiale: modelli, backend e test BF16.
Perché BF16 non descrive da solo il calcolo effettivo?
La richiesta nel grafo deve essere interpretata dal backend. Il diff aggiunge GGML_PREC_BF16 ai casi ammessi dalla flash attention CPU, ma il percorso chiamato usa ancora accumulatori F32. La descrizione upstream distingue inoltre il percorso CUDA cuBLAS, che già gestiva BF16 e non viene riscritto qui: le richieste spostate a BF16 possono quindi avere un effetto diverso su quel percorso. Non si può dedurre il formato di ogni calcolo dal solo valore richiesto dal grafo.
Pull request 31851: precisione richiesta e implementazioni di riferimento · Diff ufficiale: modelli, backend e test BF16.
Che cosa cambia nei controlli e nei test?
Diversi backend che rifiutavano una richiesta F32 per il secondo operando di MUL_MAT_ID estendono il controllo a BF16. Il codice Vulkan conserva anche il trasferimento F32 fra dispositivi per entrambe le richieste. I test di flash attention includono BF16 accanto a F32 e DEFAULT e assegnano un nome distinguibile al caso. La presenza di queste modifiche nella suite non equivale a un test eseguito qui o a una garanzia su tutti i dispositivi supportati.
Diff ufficiale: modelli, backend e test BF16.
Come confrontare due build senza confondere le cause?
Una prova utile deve tenere fissi modello, quantizzazione, prompt, seed, backend, flash attention e opzioni di compilazione, variando soltanto la revisione. Controllare correttezza sul proprio compito oltre alla latenza; uno stesso token iniziale non dimostra equivalenza dell'intera risposta. La prerelease non modifica da sola i pesi che si scaricano. Prima di raccomandare un aggiornamento per velocità o qualità servono misure ripetibili: questo approfondimento fornisce il perimetro del diff, non un benchmark.
llama.cpp b12202: prerelease ufficiale · Pull request 31851: precisione richiesta e implementazioni di riferimento.
Condizioni e limitazioni
Diff di 17 file e descrizione della pull request 31851 al merge d6be065572cdb7bf64014c8c5771e210c9570e44. Nessuna build o inferenza locale, nessuna equivalenza degli output o velocità dimostrata. La prerelease è uno stato dell'API acquisita in mattinata; alcuni readback HTML non erano allineati e il successivo accesso a GitHub ha restituito errori di rete. Il delta b12203 non è incluso in questa analisi.
Checklist pratica
- Registrare commit esatto e opzioni di compilazione di entrambe le build.
- Mantenere identici modello, quantizzazione, prompt, seed e contesto.
- Fissare backend e stato della flash attention, senza confrontare configurazioni diverse.
- Raccogliere log e risultati del proprio compito prima di interpretare la latenza.
- Distinguere precisione richiesta, formato degli operandi e accumulazione effettiva.
- Separare i risultati misurati dalle dichiarazioni upstream e conservare un rollback.