
L’ANALISI
llama.cpp: cache MoE separata dal modello draft
llama.cpp b12201 azzera la cache MoE del draft in llama-speculative. Il target la mantiene: corretto un caso di crash, senza test locali.
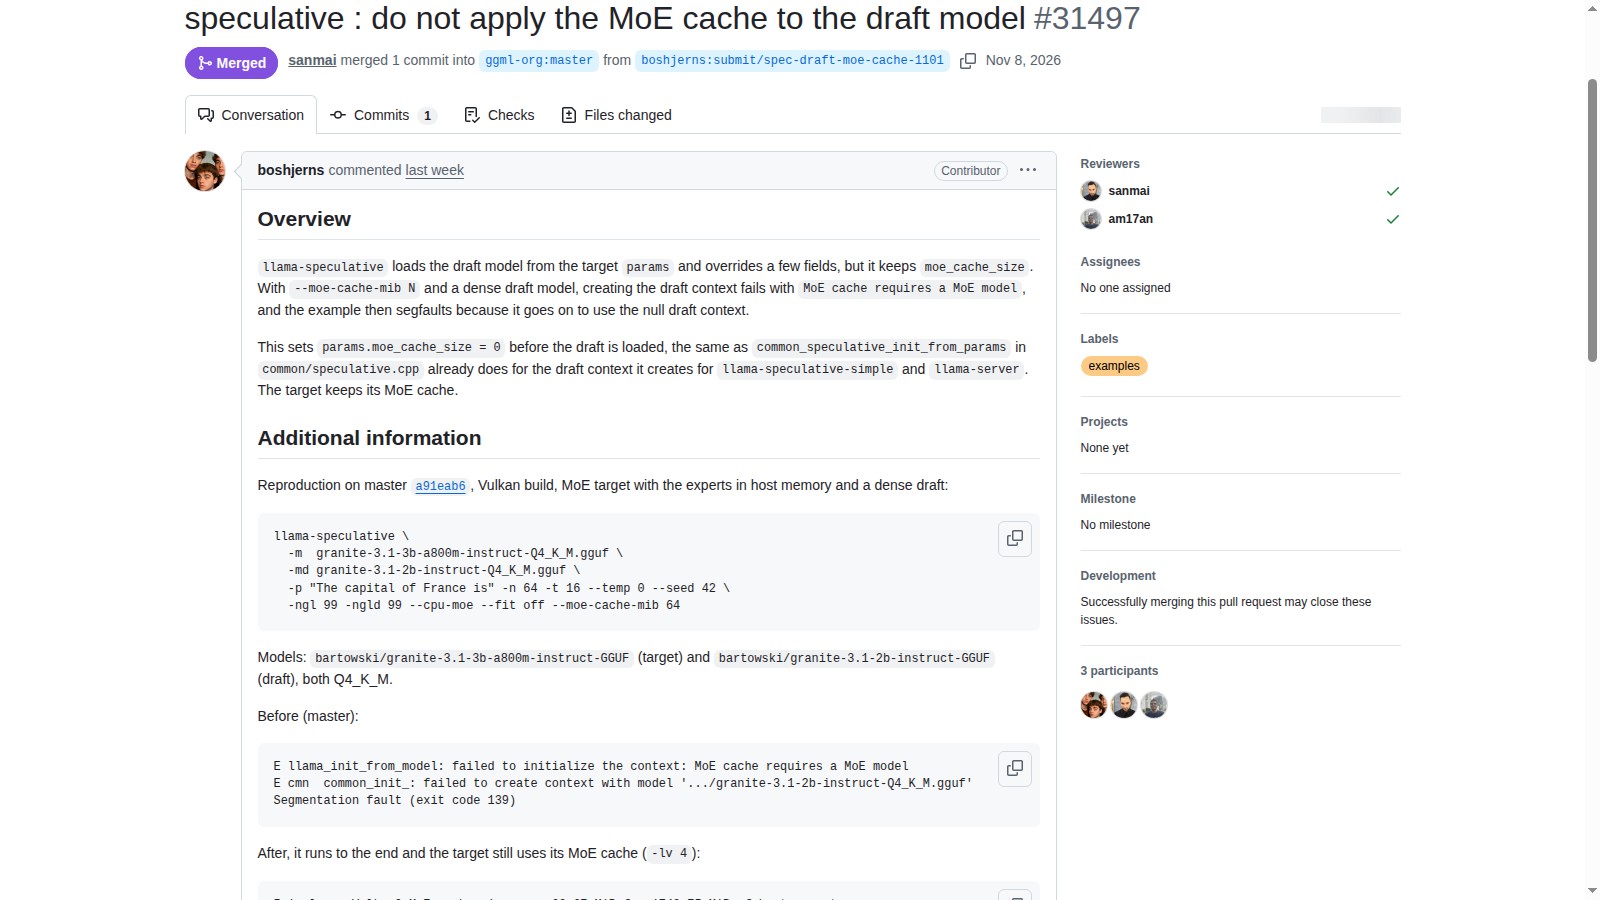
In breve: llama.cpp b12201 impedisce al draft denso di ereditare la cache MoE del target nell'esempio llama-speculative. La modifica azzera params.moe_cache_size prima dell'inizializzazione del draft; il target mantiene la propria cache. Il caso corretto è una configurazione specifica che nella riproduzione upstream terminava con un crash, non tutta la decodifica speculativa. Pull request 31497: cache MoE e contesto del draft.
Lettura delle API GitHub, della pagina ufficiale e del diff acquisiti l'8 novembre. Il merge è delle 07:11 e la prerelease delle 07:58, ora italiana; la proposta originaria era già aperta dal 1 novembre. Nel controllo successivo alcuni endpoint GitHub non erano raggiungibili: l'analisi usa la copia primaria conservata, non un risultato runtime. Nessuna build, inferenza o misura hardware eseguita.
Quale configurazione provocava l'errore?
La segnalazione combina un target MoE, un draft denso e l'opzione --moe-cache-mib. L'esempio deriva i parametri del draft da quelli del target e sovrascrive alcuni campi, ma conservava la dimensione della cache MoE. L'inizializzazione del contesto del draft rifiutava quindi il modello denso. La pull request descrive un successivo uso del contesto nullo e la terminazione con segmentation fault; non quantifica la frequenza del problema nei sistemi reali.
Pull request 31497: cache MoE e contesto del draft.
Che cosa modifica il diff e che cosa resta invariato?
Il diff aggiunge params.moe_cache_size = 0 in examples/speculative/speculative.cpp prima di common_init_from_params. La configurazione del target non viene rimossa. Il contributore spiega che il percorso comune usato da llama-speculative-simple e llama-server già azzerava questo parametro per il draft: estendere la notizia a un nuovo fix generale del server sarebbe scorretto. La modifica riguarda il confine di configurazione fra i due contesti.
Pull request 31497: cache MoE e contesto del draft · Diff ufficiale della pull request 31497.
Che cosa mostrano davvero i log upstream?
Il contributore riporta una terminazione regolare dopo la modifica e la cache del target ancora attiva. Dichiara una build Vulkan su Linux x86 con il dispositivo Mesa llvmpipe, riconosciuto dal backend come GPU. È una riproduzione documentata dal progetto, non un benchmark su scheda video fisica né una verifica indipendente. Anche i test dichiarati dal contributore restano distinti dalle prove eseguite per questo approfondimento, che sono soltanto documentali.
Pull request 31497: cache MoE e contesto del draft.
Quando conviene preparare una prova controllata?
Il controllo è pertinente a chi usa proprio llama-speculative con cache MoE e draft denso. Prima di cambiare un runtime funzionante, fissare commit, modello target, draft, quantizzazione e backend. Confrontare il caso con e senza cache mantenendo invariato il resto e controllare sia l'uscita del processo sia il log del target. La presenza della prerelease non certifica la stabilità dell'intera applicazione. Non occorre cambiare configurazioni che non utilizzano il percorso interessato solo per riprodurre la novità.
llama.cpp b12201: prerelease ufficiale · Diff ufficiale della pull request 31497.
Condizioni e limitazioni
Analisi documentale della prerelease e del diff al merge a2b301831d05b07860de508d229d430207127802. Nessuna compilazione o inferenza riprodotta. I log upstream usano Vulkan con Mesa llvmpipe: non sono una nostra prova su GPU fisica e non dimostrano uno speedup. Il nuovo accesso a GitHub ha restituito errori di rete; sono conservate le fonti primarie acquisite e verificate in mattinata.
Checklist pratica
- Identificare l'eseguibile effettivo: llama-speculative non equivale a llama-server.
- Annotare commit, backend, quantizzazione, modello target e modello draft.
- Conservare la build precedente e una procedura di ritorno.
- Usare un prompt sintetico e isolare la prova da strumenti con effetti reali.
- Confrontare inizializzazione, codice di uscita e attivazione della cache del target.
- Registrare l'hardware reale; non presentare llvmpipe come benchmark della propria GPU.