
IL PUNTO SULL’AI
2 novembre 2026
llama.cpp aggiunge filtri Jinja e corregge WebGPU; GLB-3D-Coder cambia due GGUF. Tre verifiche distinte per template, runtime e pesi locali.
In questa edizione 3 notizie
CCORE ha sostituito i GGUF Q4_K_M e Q8_0 della preview GLB-3D-Coder mantenendo gli stessi nomi. Il modello genera codice Three.js con esportazione GLB; un secondo commit aggiunge il proiettore visivo opzionale. È un fine-tuning indipendente di Qwen3.5-4B, non un rilascio ufficiale Qwen.
Limiti da conoscere
Limite: Training ancora in corso. Safetensors completi e dataset sono annunciati per dopo, non una release finale già disponibile. Miglioramenti di qualità e riuscita al primo tentativo restano dichiarazioni dell’autore; non abbiamo misurato qualità, velocità o requisiti di memoria.
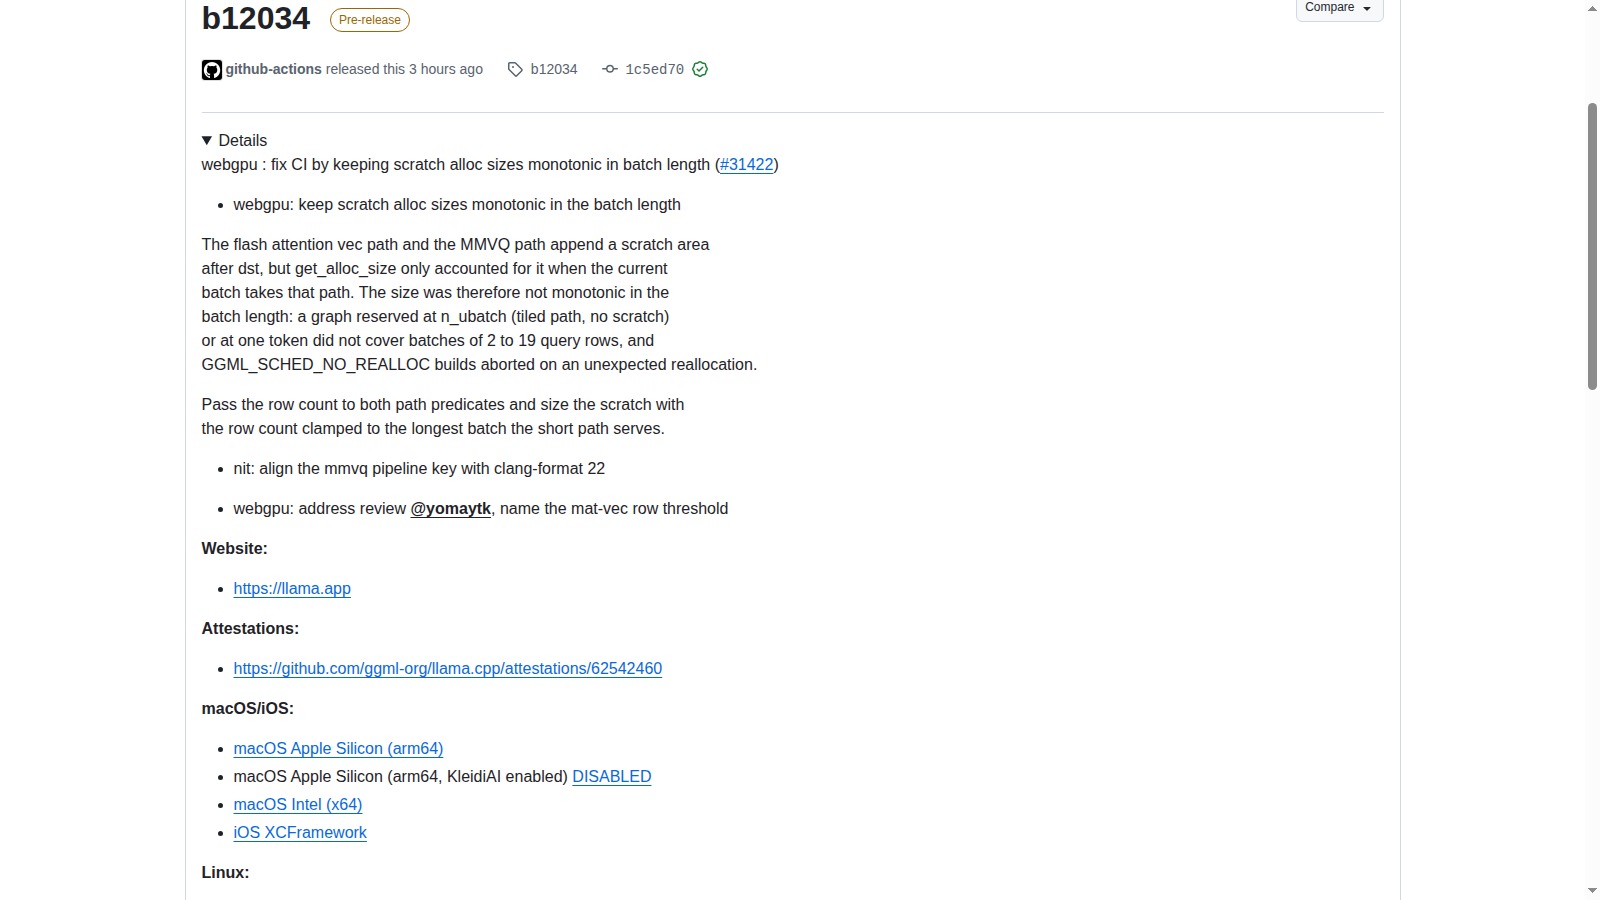
La prerelease b12034 di llama.cpp corregge il calcolo della memoria temporanea nel backend WebGPU. La prenotazione di memoria poteva non coprire batch da 2 a 19 righe di query: nelle build con GGML_SCHED_NO_REALLOC questo causava un arresto per riallocazione inattesa. La release include la correzione della PR 31422, integrata il 2 novembre.
Limiti da conoscere
Limite: È una prerelease con una correzione circoscritta a WebGPU. I test riportati nella PR sono dell’autore del contributo, non nostri: non abbiamo compilato questa revisione né misurato prestazioni. Non dimostra un aumento generale dei token al secondo o minori requisiti di memoria complessivi.
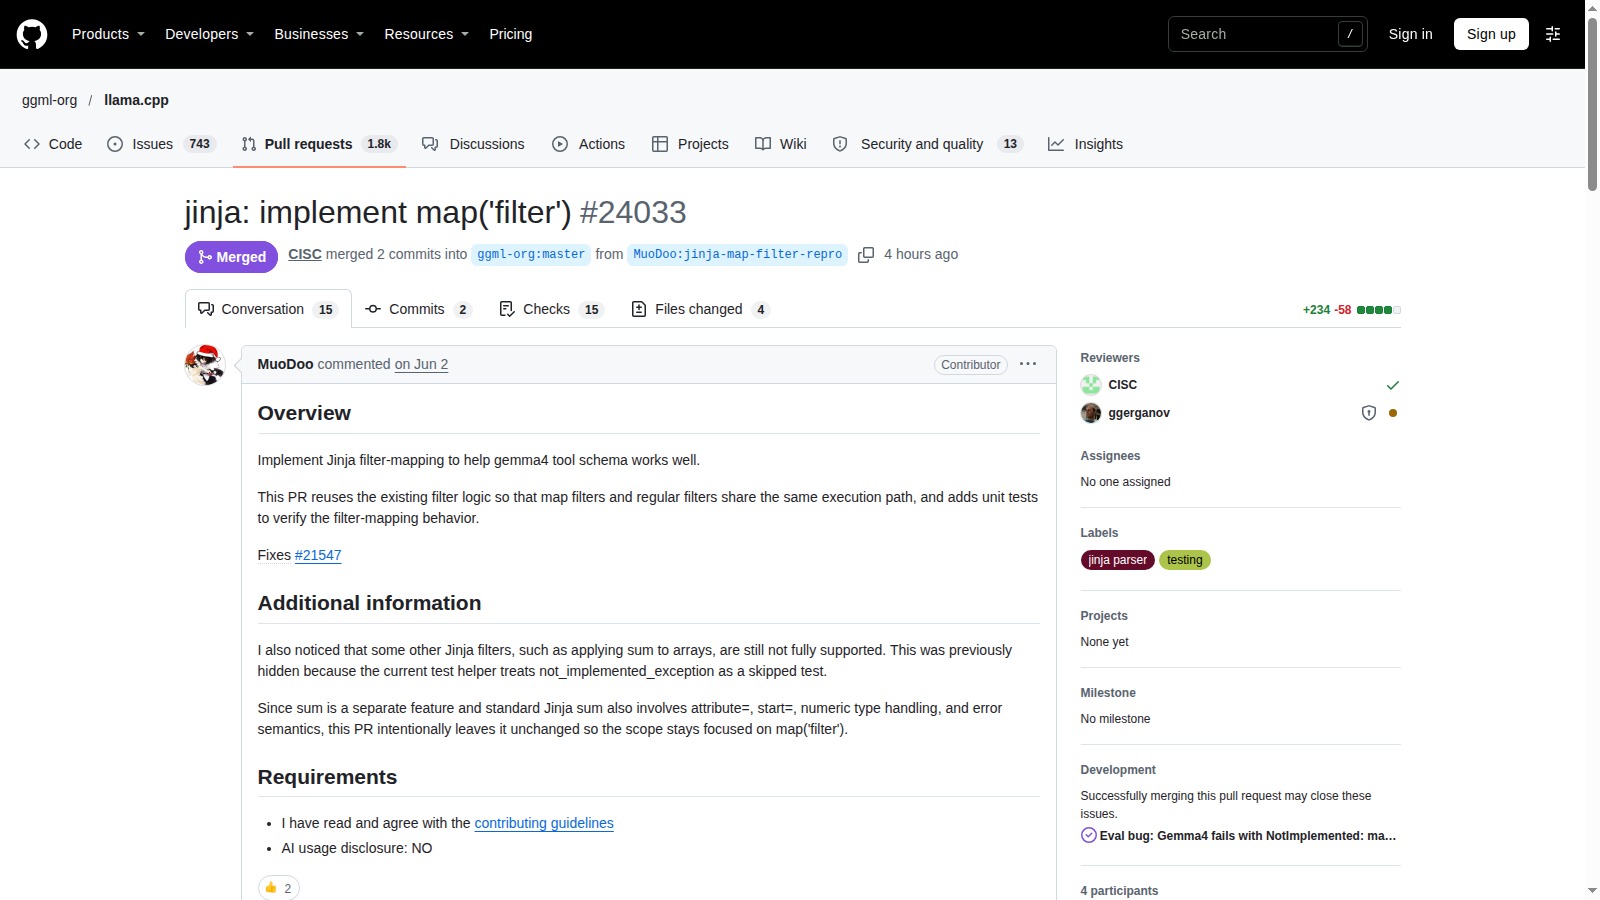
llama.cpp ha integrato map('filter') nel runtime Jinja. Il tag b12039 punta al merge della PR 24033: un delta di compatibilità per i template che applicano un filtro a ogni elemento di una sequenza. La motivazione dichiarata è il supporto degli schemi tool di Gemma4. Non è il fix WebGPU già trattato, né un nuovo modello.
Limiti da conoscere
Limite: Sono verificati tag, merge e diff; non una release binaria. L'API release del tag risponde 404 alla verifica. I test aggiunti e i check CI upstream non sostituiscono un test locale del modello o del tool calling. Il filtro sum sugli array resta fuori dallo scopo della modifica.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.