
L’ANALISI
llama.cpp b12022: parametri extra nella Responses API
llama.cpp b12022 inoltra seed e min_p nella Responses API. Cosa cambia per i client locali, come verificare il fix e perché resta una prerelease.
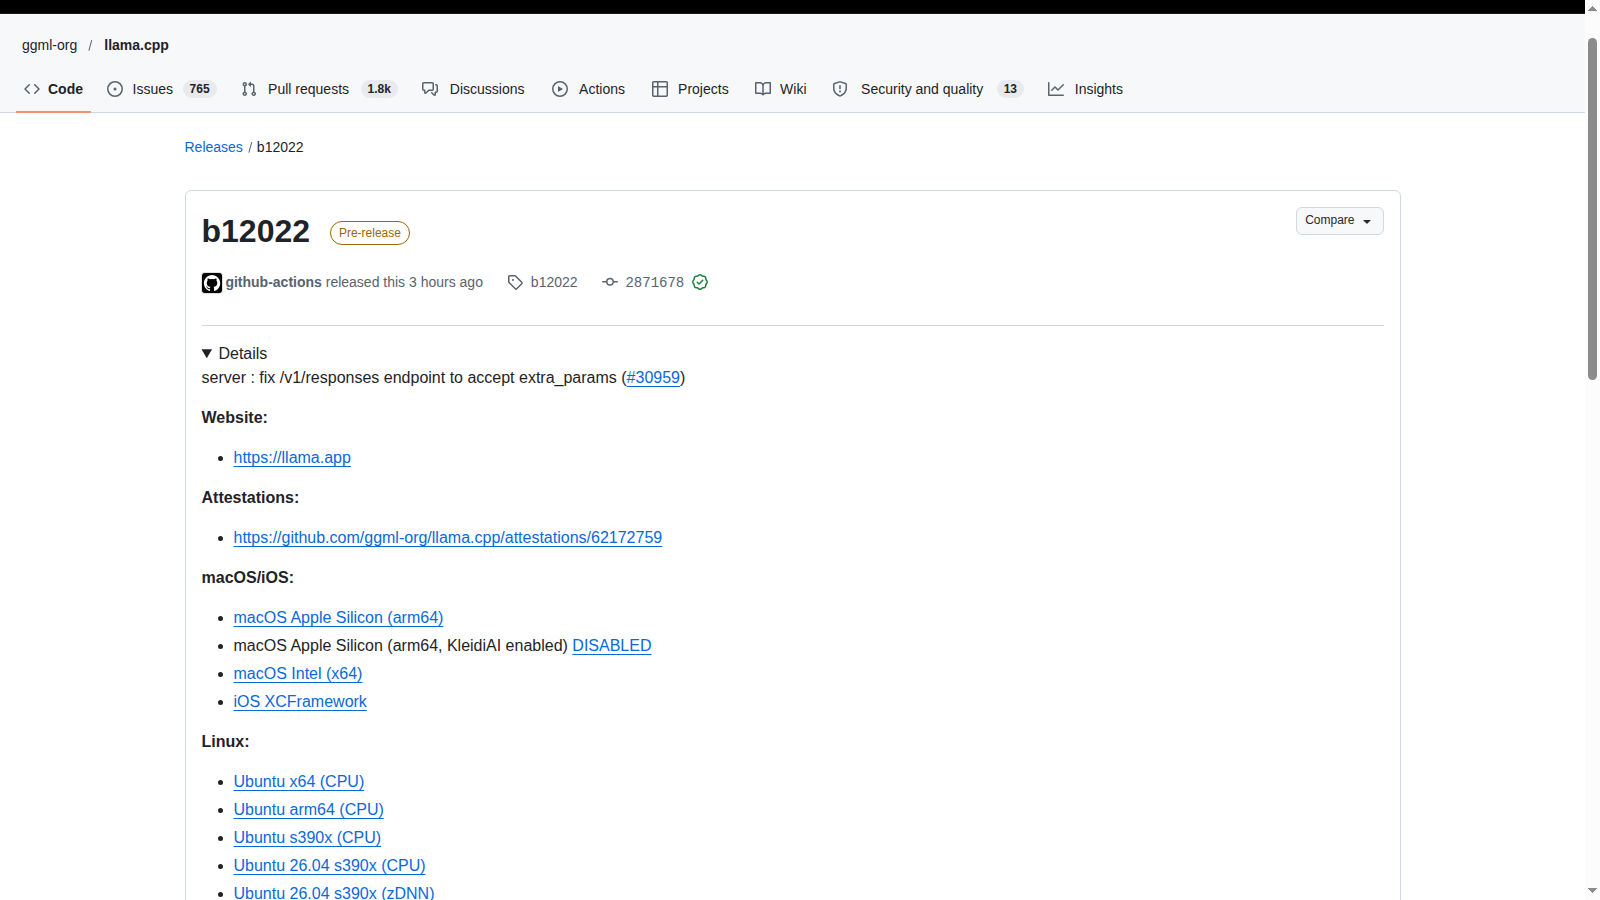
In breve: llama.cpp b12022 permette di inviare i parametri specifici del server dentro extra_params anche usando /v1/responses. Il fix interessa il percorso di conversione della richiesta, non i pesi del modello. Per un client locale è una correzione da verificare su una build fissata, non la prova di una maggiore qualità o velocità. README del server fissato al tag b12022.
Questa analisi si basa sulla release GitHub, sul README del tag b12022 e sui due file modificati nella PR 30959. Non è un test di inferenza: la procedura qui sotto è un protocollo proposto, ancora da eseguire sul proprio modello e backend.
Che cosa cambia nella Responses API?
Il server converte una richiesta /v1/responses nel proprio formato Chat Completions. Il README del tag documenta ora extra_params come oggetto per opzioni che non hanno un campo nella Responses API: gli esempi includono seed, min_p e repeat_penalty. La novità è il passaggio di quei valori al corpo convertito. Non è l'introduzione di una nuova famiglia di modelli. README del server fissato al tag b12022.
Che cosa mostra il codice, oltre al changelog?
Il diff della PR 30959 aggiunge dieci righe a server-chat.cpp: elimina il contenitore extra_params dal corpo intermedio e, se il valore ricevuto è un oggetto, copia le sue coppie chiave-valore nella richiesta convertita. Le altre modifiche sono nel README. Questa lettura rende verificabile il perimetro del fix, ma non sostituisce l'esecuzione del server né una prova del client che lo userà. PR 30959: correzione di extra_params nella Responses API.
Quando serve a un client per modelli locali?
La correzione è pertinente se il client usa /v1/responses e deve controllare un'opzione specifica di llama.cpp. Un'integrazione che invia già richieste a /v1/chat/completions non va descritta come rotta da questo stesso difetto: il cambiamento qui verificato riguarda un percorso diverso. Prima di aggiornare conviene quindi registrare l'endpoint effettivamente usato, non soltanto il nome dell'SDK o del modello. README del server fissato al tag b12022.
Come preparare una prova ripetibile?
Fissare il tag b12022, il file GGUF, il backend e la configurazione del server. Usare un prompt non sensibile e inviare un oggetto extra_params con seed 42 e min_p 0.05, come nell'esempio ufficiale. Conservare il JSON inviato e i log disponibili. Il controllo utile è che i valori arrivino al percorso previsto; un singolo testo uguale o diverso non dimostra da solo che il parametro sia stato applicato. Un confronto con una build precedente va isolato da ogni altra modifica. README del server fissato al tag b12022.
È una release stabile e quali prove mancano?
L'API ufficiale di GitHub indica b12022 come prerelease e ne data la pubblicazione al 31 ottobre 2026, alle 19:59 italiane. Non va confusa con un semplice tag, ma neppure presentata come stabile. L'autore della PR segnala l'assenza di nuovi test nella proposta; il diff consultato contiene soltanto codice e documentazione. Restano da verificare l'esecuzione sul proprio backend, il comportamento del client e le regressioni sul proprio carico. API GitHub: stato prerelease e data di b12022.
Condizioni e limitazioni
Verificati release, documentazione fissata al tag e diff della PR, non eseguita un'inferenza end-to-end. La PR non aggiunge test automatici; il supporto ai parametri non garantisce output identici fra hardware, build o configurazioni diverse. La build è una prerelease, non una release stabile.
Checklist pratica
- Verificare se il client invia realmente richieste a /v1/responses.
- Conservare tag, commit, checksum del GGUF e configurazione del backend.
- Usare un server di prova e un prompt privo di informazioni riservate.
- Inviare extra_params come oggetto JSON, non come stringa.
- Registrare richiesta e log disponibili prima di interpretare gli output.
- Confrontare una sola modifica per volta e mantenere una build di ripristino.
- Non interpretare seed come garanzia di identità fra hardware o build differenti.
Modelli AI locali: come scegliere LLM, hardware e runtime. Per distinguere modello, formato dei pesi, backend e runtime prima della prova.