
L’ANALISI
MiniCPM-OCR 1.0 e Jev: separare lettura, layout e verifica
Una griglia di prova per OCR locale: distinguere modello di lettura, layout, formato Markdown e valutatore Jev, senza trasferire benchmark a documenti italiani non testati.
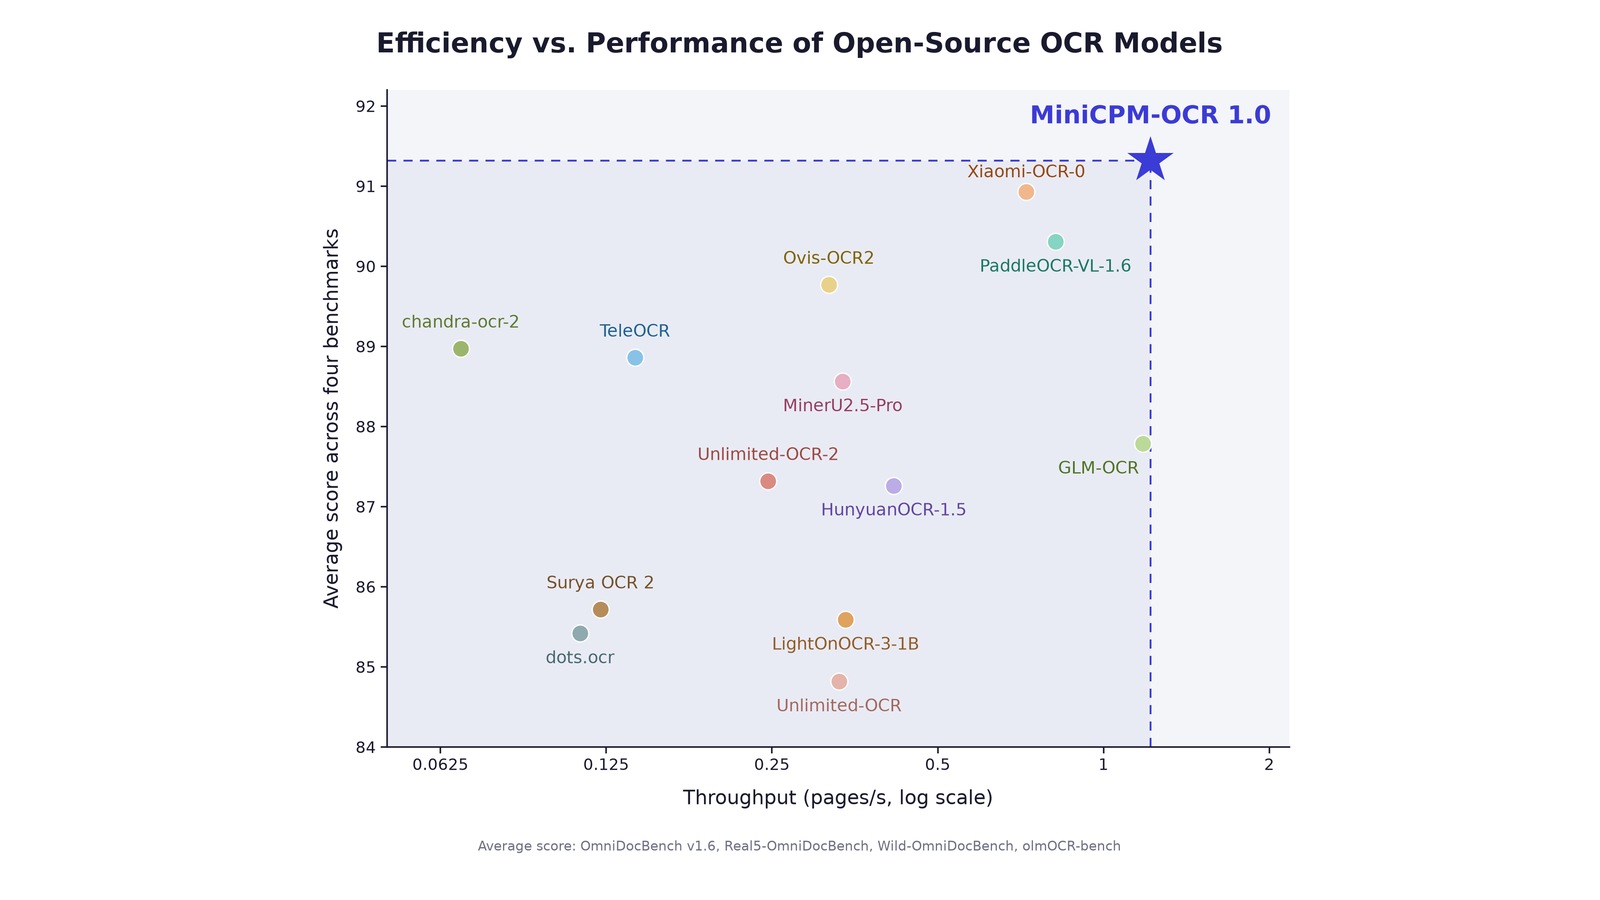
In breve: Non basta caricare un checkpoint per ottenere un parser PDF completo. Il test proposto deve controllare layout, riconoscimento e ordine di lettura separatamente; Jev è un componente di valutazione e non sostituisce il modello che produce il testo.
Tre componenti da non confondere
La documentazione distingue MiniCPM-OCR 1.0, il rilevatore PP-DocLayoutV3 e l’SDK che ricompone il documento in Markdown. Per il sistema proposto, registrare il contributo di ciascun passaggio. Se una tabella è sbagliata, capire prima se l’errore nasce dal ritaglio, dalla lettura o dall’assemblaggio.
Jev è un valutatore, non un generatore
Le note del tag llama.cpp b11928 descrivono un value head che assegna un punteggio al testo OCR e rifiuta la generazione; la release è prerelease. Una prova proposta deve quindi inviare a ogni componente il tipo di richiesta corretto, senza interpretare un rifiuto della generazione come guasto del parser.
Lingue e documenti richiedono un campione proprio
La card indica cinese e inglese come lingue principali. Per valutarne l’uso in italiano, preparare un riferimento manuale con accenti, importi, codici, colonne e note a piè di pagina. Non estrapolare l’accuratezza da una percentuale aggregata pubblicata per un altro insieme di documenti.
La quantizzazione è una variante da misurare
Protocollo proposto: fissare pagine, risoluzione e backend e cambiare una sola precisione alla volta. Confrontare omissioni, ordine di lettura e struttura delle tabelle prima di confrontare tempi e memoria. Conservare gli originali fuori dai log dell’esperimento quando contengono dati personali o riservati.
Condizioni e limitazioni
MiniCPM-OCR-Jev valuta il testo rispetto all’immagine, non genera la trascrizione. Il tag b11928 è marcato prerelease. Le lingue principali documentate per OCR 1.0 sono cinese e inglese: non è stata verificata la qualità su documenti italiani né eseguito il deployment.
Checklist pratica
- Fissare revisioni di OCR, layout, SDK e runtime.
- Distinguere checkpoint generativo da valutatore Jev.
- Non chiamare stabile il tag b11928: la primaria lo marca prerelease.
- Preparare documenti sintetici o autorizzati e un riferimento manuale.
- Misurare separatamente testo, tabelle, formule e ordine di lettura.
- Verificare l’italiano con un campione proprio prima dell’adozione.