
L’ANALISI
MiniCPM-o 4.5: pesi aperti per audio, video e dialogo full-duplex
Analisi pratica dei pesi MiniCPM-o 4.5: architettura 9B, audio-video full-duplex, requisiti Transformers, limiti, sicurezza e checklist per una prova locale.
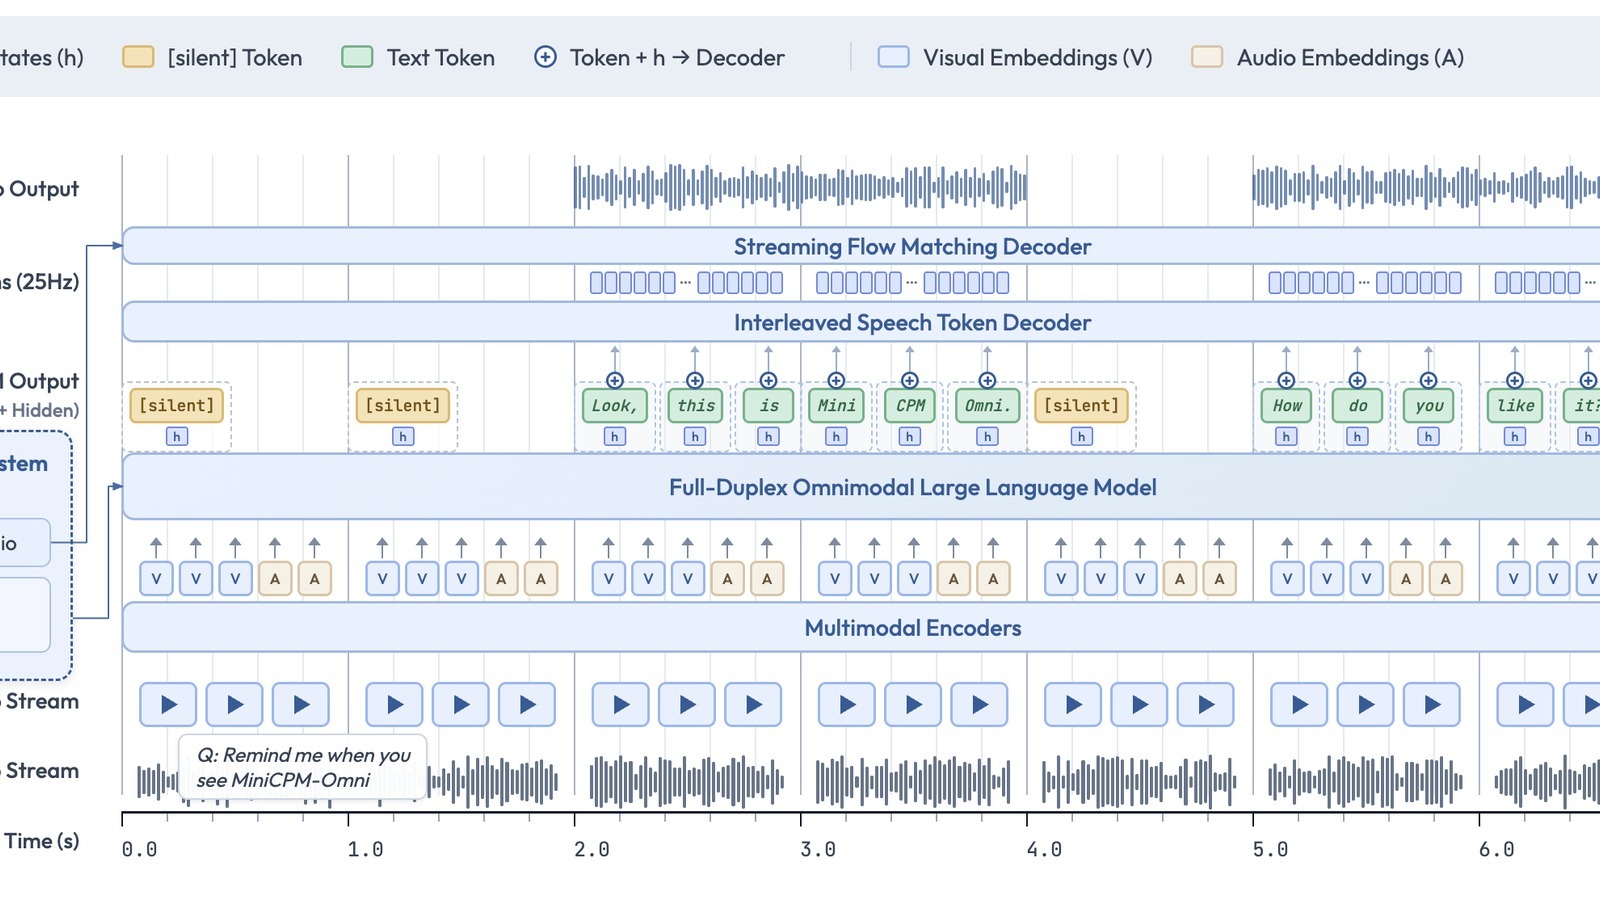
In breve: Il delta concreto è che MiniCPM-o 4.5 non è più soltanto una demo o una promessa: il repository contiene i quattro shard Safetensors, tokenizer, codice di modellazione e componenti audio necessari per provarlo. Può elaborare immagini, video e voce e generare testo e parlato in streaming, ma il percorso consigliato resta una GPU NVIDIA con dipendenze rigidamente versionate e codice remoto da revisionare prima dell’esecuzione.
Che cosa è diventato scaricabile
Il repository Hugging Face espone quattro shard Safetensors insieme a indice, configurazione, tokenizer, codice Python del modello e componenti ONNX e PyTorch per la catena vocale. Questa pubblicazione rende il checkpoint effettivamente acquisibile e ispezionabile, separando la disponibilità dei pesi dalla precedente disponibilità di demo e API.
Come funziona il percorso omnimodale
MiniCPM-o 4.5 collega SigLip2 per la visione, Whisper-medium per l’audio, Qwen3-8B come backbone linguistico e CosyVoice2 per la voce. Nella modalità full-duplex sincronizza input video e audio con output testuale e vocale, così il modello può continuare ad ascoltare e vedere mentre produce una risposta.
Requisiti e confine locale
Il quickstart ufficiale blocca transformers alla versione 4.51.0 e PyTorch tra 2.3 e 2.8, richiede trust_remote_code=True e usa bfloat16 su CUDA. FFmpeg serve per estrarre fotogrammi e segmenti audio e per ricomporre il video. Locale significa che pesi e inferenza possono stare sulla macchina, non che ogni integrazione, demo o dipendenza esterna sia automaticamente privata.
Che cosa misurare davvero
I benchmark pubblicati dagli autori coprono visione, document parsing, audio, generazione vocale e duplex, ma non sostituiscono un test sul proprio flusso. Le misure utili sono VRAM di picco, latenza al primo token o al primo campione audio, stabilità oltre un minuto, perdita di sincronizzazione e qualità su accenti, rumore e video reali.
Condizioni, sicurezza e limiti
L’esecuzione di codice remoto va prima confinata e revisionata. I campioni vocali non vanno trattati come semplici prompt: servono consenso, conservazione limitata e prevenzione dell’impersonificazione. Anche l’interazione proattiva deve avere un indicatore visibile di ascolto, un comando di arresto e una policy che impedisca azioni esterne non autorizzate.
Condizioni e limitazioni
Il modello richiede codice remoto personalizzato e, per il percorso Transformers documentato, transformers 4.51.0, PyTorch 2.3-2.8, FFmpeg e una GPU NVIDIA. Velocità, memoria e benchmark sono dichiarati dal progetto e non sono stati riprodotti in questo run. Voice cloning e interazione proattiva richiedono inoltre controlli espliciti su consenso, identità e uso dei campioni vocali.
Checklist pratica
- Bloccare revisione del checkpoint e commit del repository prima del download.
- Creare un ambiente isolato con le versioni Transformers e PyTorch indicate.
- Revisionare il codice caricato con trust_remote_code prima di consentirne l’esecuzione.
- Installare FFmpeg e verificare separatamente immagine, audio e video con file non sensibili.
- Misurare VRAM, latenza iniziale, throughput e stabilità di una sessione lunga.
- Provare il full-duplex con rete disabilitata e registrare eventuali dipendenze esterne.
- Usare solo voci autorizzate, mostrare lo stato di ascolto e mantenere un arresto immediato.