
L’ANALISI
MiniCPM-V 4.7: i GGUF ufficiali rendono più diretto il test con llama.cpp
Analisi dei GGUF ufficiali di MiniCPM-V 4.7: varianti 1B e 35B-A3B, file per llama.cpp, proiettori multimodali, limiti e checklist di prova locale.
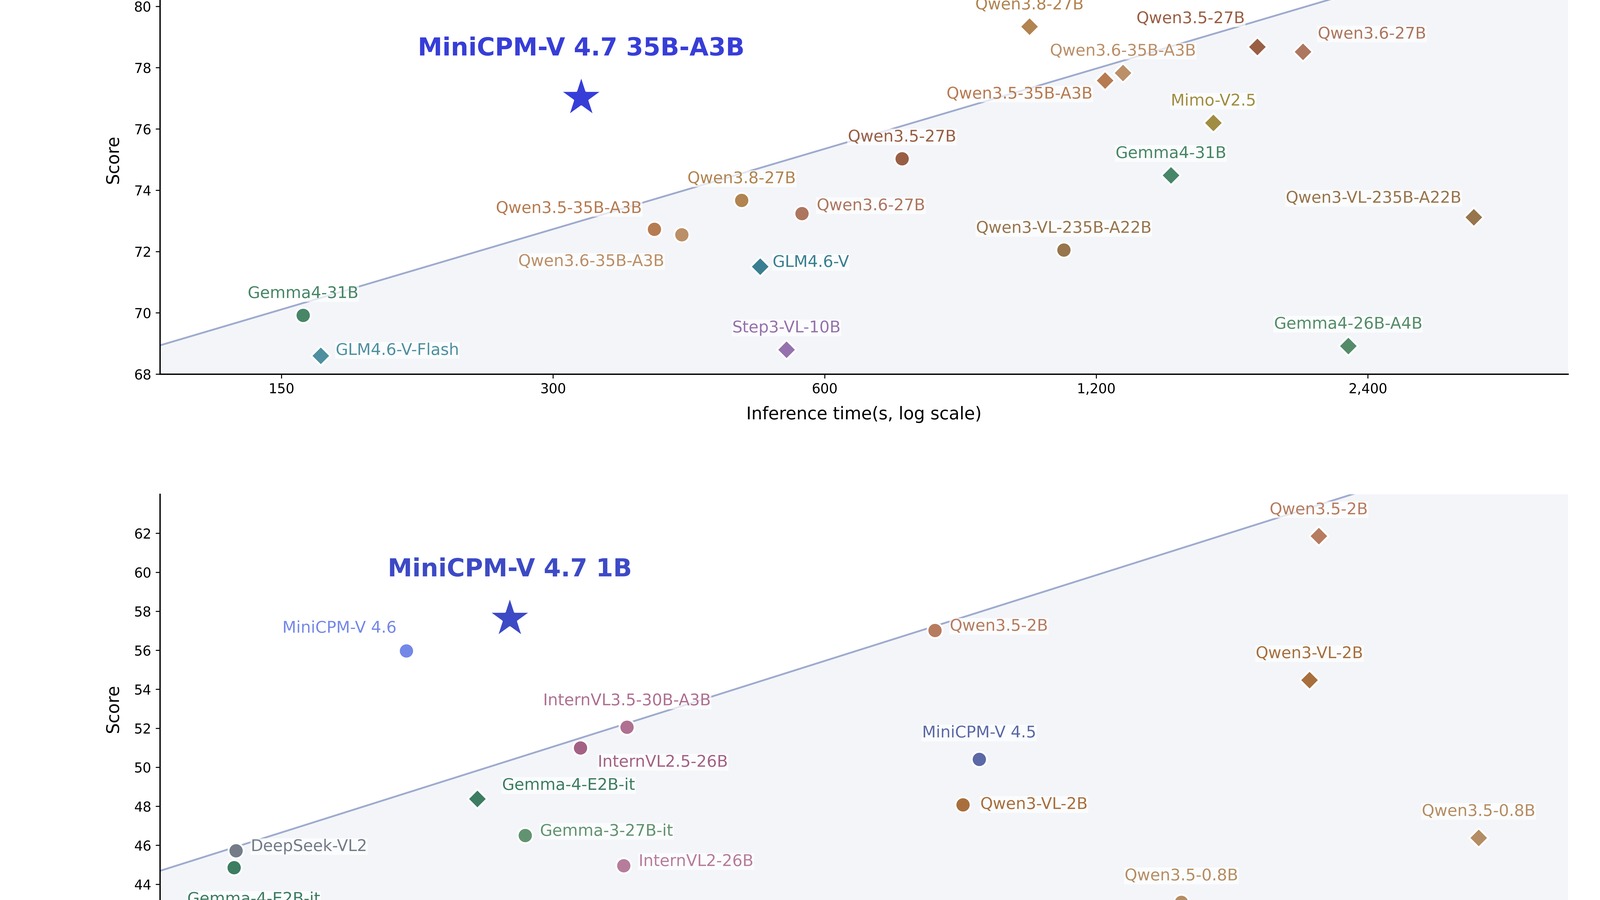
In breve: Il cambiamento pratico è la disponibilità di file GGUF ufficiali scaricabili per entrambe le taglie. Chi usa llama.cpp può scegliere tra F16, Q4, Q5, Q6 e Q8 e abbinare il proiettore multimodale, ma deve ancora verificare build compatibile, memoria effettiva e qualità sul proprio carico.
Che cosa è cambiato rispetto al rilascio iniziale
Il 12 ottobre erano già disponibili i modelli MiniCPM-V 4.7 e diverse famiglie di quantizzazione. Il 13 ottobre OpenBMB ha popolato due repository GGUF ufficiali con gli artefatti completi per 1B e 35B-A3B, separando quindi l’annuncio della famiglia dalla disponibilità concreta dei file per llama.cpp.
Quali file si possono scaricare
Il repository 1B espone F16 e varianti Q4, Q5, Q6 e Q8. Il 35B-A3B offre la stessa gamma, una quantizzazione mista aggiuntiva e due proiettori multimodali. I file mmproj sono necessari per collegare l’encoder visivo al modello linguistico nel percorso llama.cpp.
Perché il formato GGUF conta
GGUF concentra pesi e metadati in un formato usato da llama.cpp e dai runtime che lo integrano. Le quantizzazioni riducono memoria e banda rispetto a F16, ma non hanno un costo uniforme: una Q4 può essere più accessibile, mentre Q6 o Q8 conservano più precisione richiedendo più risorse.
1B e 35B-A3B non sono lo stesso test
La variante 1B è il punto di ingresso realistico per CPU e dispositivi con memoria limitata. Il 35B-A3B attiva circa 3 miliardi di parametri per token, ma deve comunque archiviare e gestire molti più pesi; il vantaggio MoE non elimina i vincoli di storage e trasferimento degli esperti.
Compatibilità e limiti da verificare
La scheda collega esplicitamente i GGUF a llama.cpp, ma una prova riproducibile deve fissare revisione del modello, file, hash, commit del runtime e parametri del proiettore. I benchmark degli autori descrivono il modello, non dimostrano la qualità di ogni quantizzazione su hardware diverso.
Condizioni e limitazioni
La disponibilità dei file non equivale a compatibilità verificata su ogni build di llama.cpp. Le prestazioni e il dato di 13+ token al secondo su iPhone 17 Pro Max restano dichiarazioni di OpenBMB; dimensione, memoria e qualità delle singole quantizzazioni vanno misurate sul dispositivo reale.
Checklist pratica
- Scegliere prima la taglia 1B o 35B-A3B in base a RAM, storage e obiettivo.
- Scaricare modello GGUF e proiettore mmproj dalla stessa revisione ufficiale.
- Registrare hash dei file e commit esatto di llama.cpp.
- Provare una Q4 e una Q6 sullo stesso set di immagini, documenti e prompt.
- Misurare memoria, tempo al primo token, token al secondo e accuratezza.
- Tenere separati risultati del modello, effetto della quantizzazione e limiti del runtime.