
L’ANALISI
MiniCPM-V 4.7: pesi multimodali e varianti quantizzate per l’uso locale
Analisi pratica di MiniCPM-V 4.7: pesi 1B e 35B-A3B, quantizzazioni, inferenza multimodale locale, limiti dichiarati e protocollo di prova.
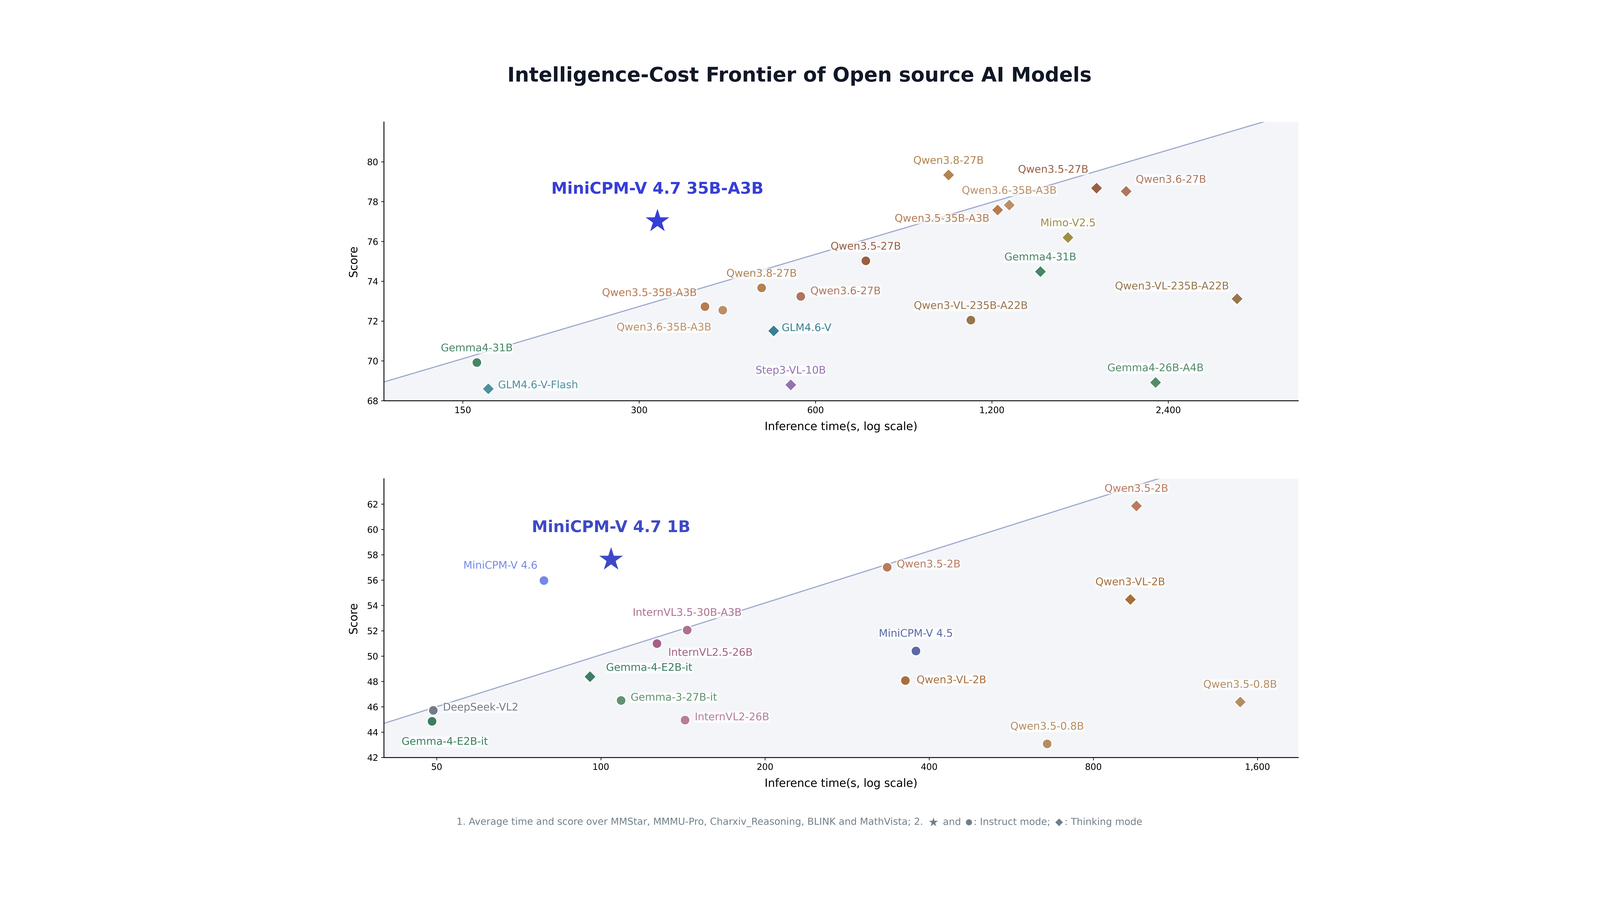
In breve: La novità concreta è un pacchetto scaricabile, non soltanto un annuncio: due modelli multimodali, quantizzazioni ufficiali e istruzioni per immagini, video, serving e uso locale. La variante 1B è il punto di partenza più realistico per prove su hardware limitato; il 35B-A3B va valutato separando parametri attivi, memoria totale e dipendenze del runtime.
Che cosa è disponibile
OpenBMB pubblica i pesi BF16 per 1B e 35B-A3B e varianti INT4, AWQ, GPTQ e GGUF; per il 35B sono presenti anche FP8 e un draft model DSpark. Le schede riportano licenza Apache 2.0 e istruzioni eseguibili con Transformers.
Il compromesso tra 1B e 35B-A3B
Il modello 1B privilegia ingombro ed efficienza. Il 35B-A3B è un Mixture of Experts: attiva circa 3 miliardi di parametri per token, ma deve comunque gestire l’insieme degli esperti e quindi memoria, storage e banda non corrispondono a un normale modello da 3B.
Immagini, video e compressione visuale
Entrambe le taglie accettano immagini e video. Il parametro downsample_mode sceglie tra compressione visuale 16x, più economica, e 4x, con più dettaglio; va passato sia alla preparazione del prompt sia alla generazione per evitare input incoerenti.
Runtime e portabilità
Le schede indicano Transformers, SGLang, vLLM, llama.cpp, Ollama e piattaforme mobili. Questa ampiezza non rende i runtime equivalenti: formati, memoria, accelerazione e supporto video devono essere verificati sul percorso scelto, bloccando revisioni e dipendenze.
Come leggere i benchmark
Il confronto prestazioni-efficienza e i test mobile sono prodotti dal progetto. Sono utili per scegliere cosa provare, non per stimare automaticamente qualità e velocità sul proprio corpus: servono prompt, media, risoluzioni, output e hardware identici.
Condizioni e limitazioni
Prestazioni, confronti e 13+ token al secondo su iPhone 17 Pro Max sono misure dichiarate da OpenBMB, non test indipendenti. Il percorso mobile del 35B richiede tecniche e runtime dedicati; il quickstart Transformers richiede almeno la versione 5.18 e l’integrazione OpenVINO indicata nella scheda contiene ancora un collegamento da completare.
Checklist pratica
- Partire dalla variante 1B e fissare la revisione esatta dei pesi.
- Scegliere un solo runtime e annotare versioni, quantizzazione e memoria disponibile.
- Preparare immagini, documenti e video rappresentativi del caso reale.
- Confrontare 4x e 16x su qualità, latenza e consumo di memoria.
- Misurare tempo al primo token, token al secondo e accuratezza separatamente.
- Provare il 35B-A3B solo dopo aver verificato storage, banda e gestione degli esperti.