
L’ANALISI
Trident-Qwen3VL-2B: retrieval unico per testo, immagini e documenti misti
Analisi pratica di Trident-Qwen3VL-2B: pesi scaricabili per retrieval misto testo-immagine, setup, limiti e protocollo di prova per RAG multimodale.
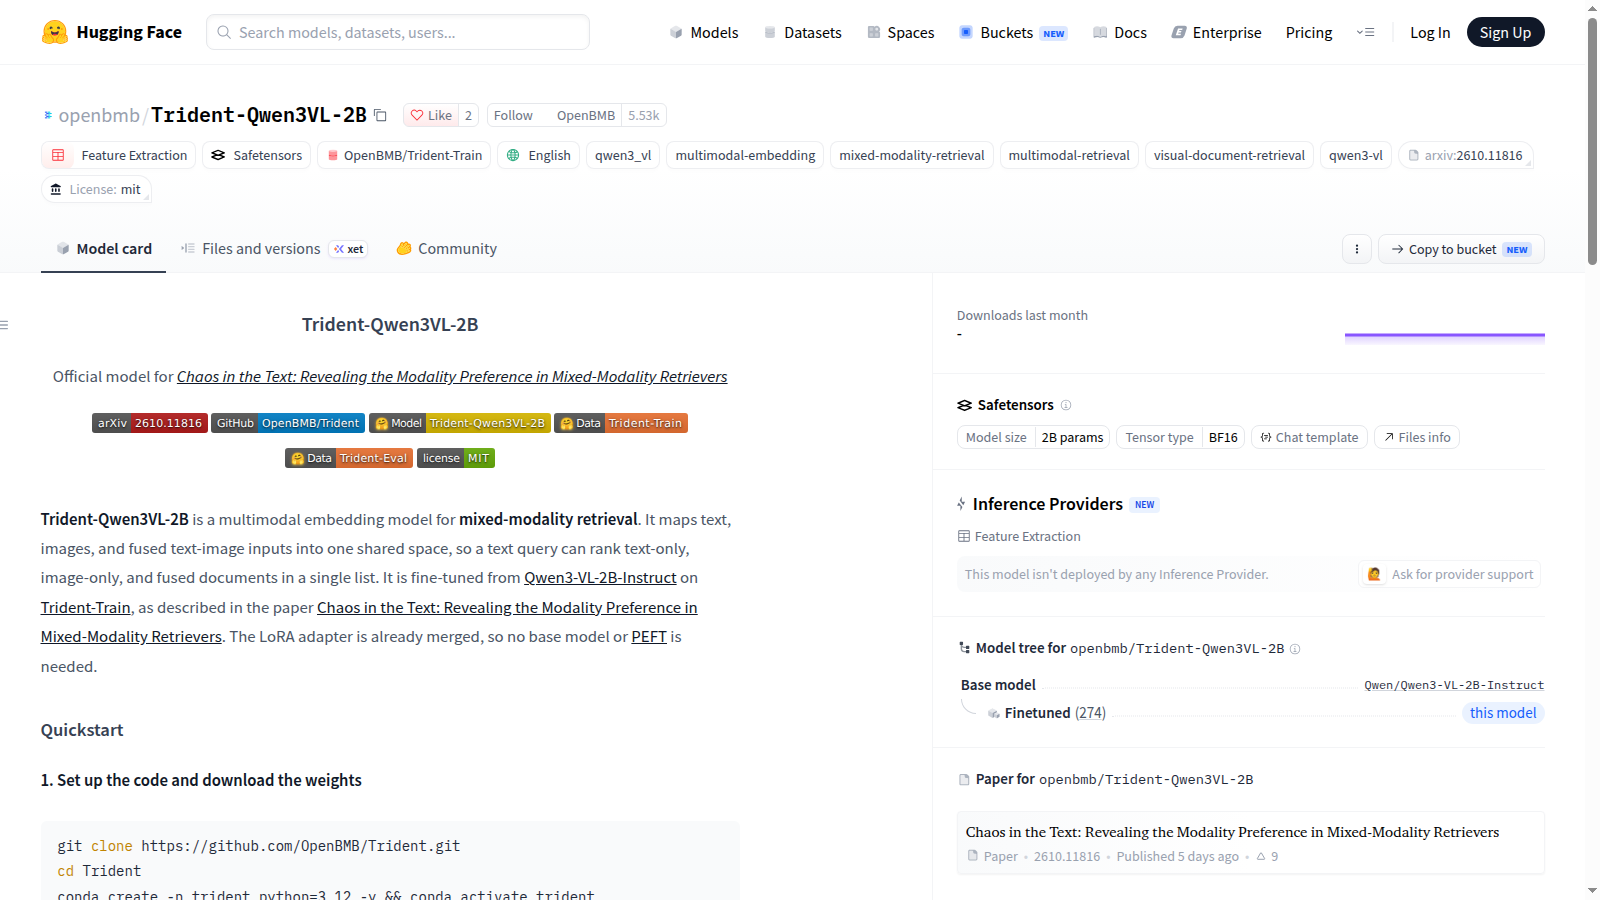
In breve: Trident rende concreta una pipeline di ricerca in cui una query testuale può confrontare, nello stesso ranking, testo, immagini e documenti che combinano entrambi. È un componente di retrieval, non un generatore: il valore va verificato su documenti reali misurando se riduce la preferenza artificiale per una modalità.
Che cosa si può scaricare oggi
La release include i pesi BF16 da 2,13 miliardi di parametri, il repository MIT e i dataset di training e valutazione. L’adapter LoRA è già fuso, quindi non serve caricare separatamente il modello base o PEFT.
Un solo spazio per tre tipi di documento
Query e documenti vengono codificati con istruzioni diverse, poi confrontati tramite similarità coseno. Lo stesso indice può contenere record solo testuali, solo visuali oppure testo e immagine insieme.
Dove può cambiare un RAG multimodale
In cataloghi, manuali e archivi tecnici evita di costruire ranking separati per OCR, didascalie e immagini. Non elimina però parsing, metadati, segmentazione e controllo degli accessi: produce vettori, non una pipeline documentale completa.
Come leggere la prova pubblicata
Il progetto nasce dal paper sulla preferenza di modalità nei retriever misti. Model card, codice e dataset rendono l’esperimento ispezionabile, ma non sostituiscono una valutazione indipendente sul dominio e sulle lingue effettivamente usate.
Condizioni e limitazioni
Il modello è appena pubblicato, non è servito da provider di inferenza e richiede una GPU CUDA nel quickstart ufficiale. I risultati del paper e dei dataset associati restano evidenza degli autori: prima di usarlo in un RAG reale vanno misurati recall, latenza e bias di modalità sul proprio corpus.
Checklist pratica
- Bloccare commit del repository e revisione dei pesi usati nel test.
- Preparare un set con documenti testuali, visuali e misti e giudizi di rilevanza verificati.
- Misurare recall e ranking per modalità, non soltanto la media complessiva.
- Confrontare Trident con la pipeline attuale a parità di chunk, query e candidati.
- Registrare VRAM, latenza, dimensione dell’indice e casi in cui una modalità domina le altre.