
L’ANALISI
AutoSynthData: quando i fallimenti degli agenti diventano dati di training
Come funziona AutoSynthData di ServiceNow CoreAI, quali risultati dichiara su EnterpriseOps Gym e quali condizioni servono prima di usare dati sintetici per il post-training.
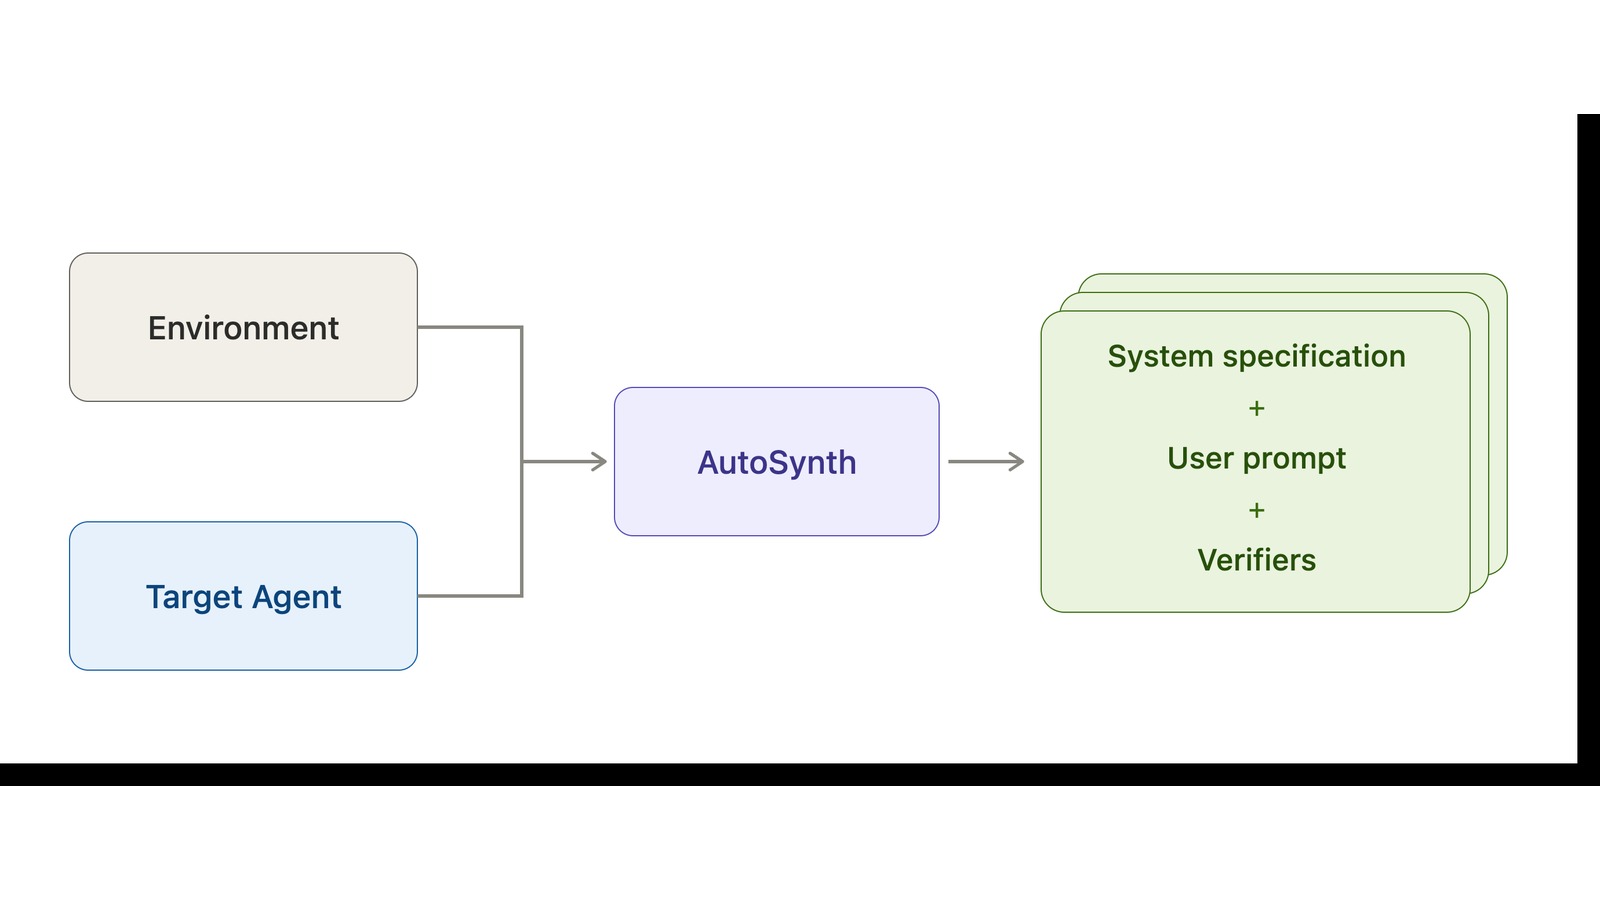
In breve: AutoSynthData trasforma gap osservati in un ambiente agentico in task sintetici composti da specifica di sistema, prompt e verificatore. La pipeline seleziona capacità in cui un teacher riesce e il modello target fallisce, genera variazioni fattibili e le valida prima del training. È un metodo interessante per un curriculum adattivo, ma l’articolo non rilascia una pipeline pronta da installare e i guadagni pubblicati restano risultati del produttore su ambienti controllati.
Il delta verificato
ServiceNow CoreAI ha pubblicato il metodo AutoSynthData e due esperimenti su EnterpriseOps Gym. Il punto pratico è usare errori osservati, successi di un teacher e verificatori dell’ambiente per costruire un curriculum mirato, invece di generare esempi sintetici senza una misura operativa del gap.
Come nasce un task sintetico
Ogni task combina specifica di sistema, richiesta dell’utente e verificatore. La pipeline cerca capacità per cui il teacher supera il target, propone nuovi task, controlla che siano fattibili e realistici e filtra gli esempi che non possono essere verificati nell’ambiente.
I numeri dichiarati
Nel setup Hybrid ServiceNow riporta 2.000 campioni prodotti in circa 18 ore, un mean Pass@1 salito di 7,2 punti percentuali, un miglioramento relativo del 35% e verifier success dal 63,01% al 68,55%. Nel setup ITSM dichiara 1.994 campioni in 66 ore. Sono misure del produttore, non una replica indipendente.
Perché non basta generare più dati
Un task plausibile può essere impossibile nello stato corrente, dipendere da strumenti assenti o avere un verificatore fragile. AutoSynthData prova a ridurre questi errori legando la generazione allo stato dell’ambiente; la qualità finale resta però limitata dal teacher, dalla copertura dei verificatori e dalla selezione dei gap.
Quando può avere senso
Il metodo è più adatto a flussi con ambiente riproducibile, azioni osservabili e successo misurabile. È meno convincente per attività aperte, giudizi soggettivi o processi in cui lo stato reale non può essere ricreato senza dati sensibili o rischi operativi.
Condizioni e limiti
L’articolo illustra un approccio e risultati, non un pacchetto pronto al download. Prima di un post-training servono separazione tra train e test, controllo dei falsi positivi del verificatore, analisi della distribuzione dei task e confronto con interventi più semplici come prompt, strumenti, policy o recupero documentale.
Checklist per una prova controllata
- Definire un ambiente riproducibile e privo di credenziali o dati di produzione.
- Misurare una baseline del modello target su task reali e versionati.
- Usare verificatori con test positivi, negativi e casi limite.
- Confermare che il teacher risolva davvero i gap scelti.
- Filtrare task impossibili, duplicati o estranei alla distribuzione reale.
- Tenere un set held-out mai usato dalla generazione o dal training.
- Confrontare il post-training con prompt, RAG, strumenti e regole deterministiche.
- Registrare costi, ore, campioni accettati e motivi di scarto.
- Bloccare il rollout se migliorano i task sintetici ma peggiorano quelli reali.