
L’ANALISI
llama.cpp b10997 su RDNA 3.5: cosa cambia per i modelli MoE
Una modifica di una condizione abilita sulla Radeon 8060S l’euristica dei tile MoE già usata su RDNA 3, con guadagni dichiarati da verificare localmente.
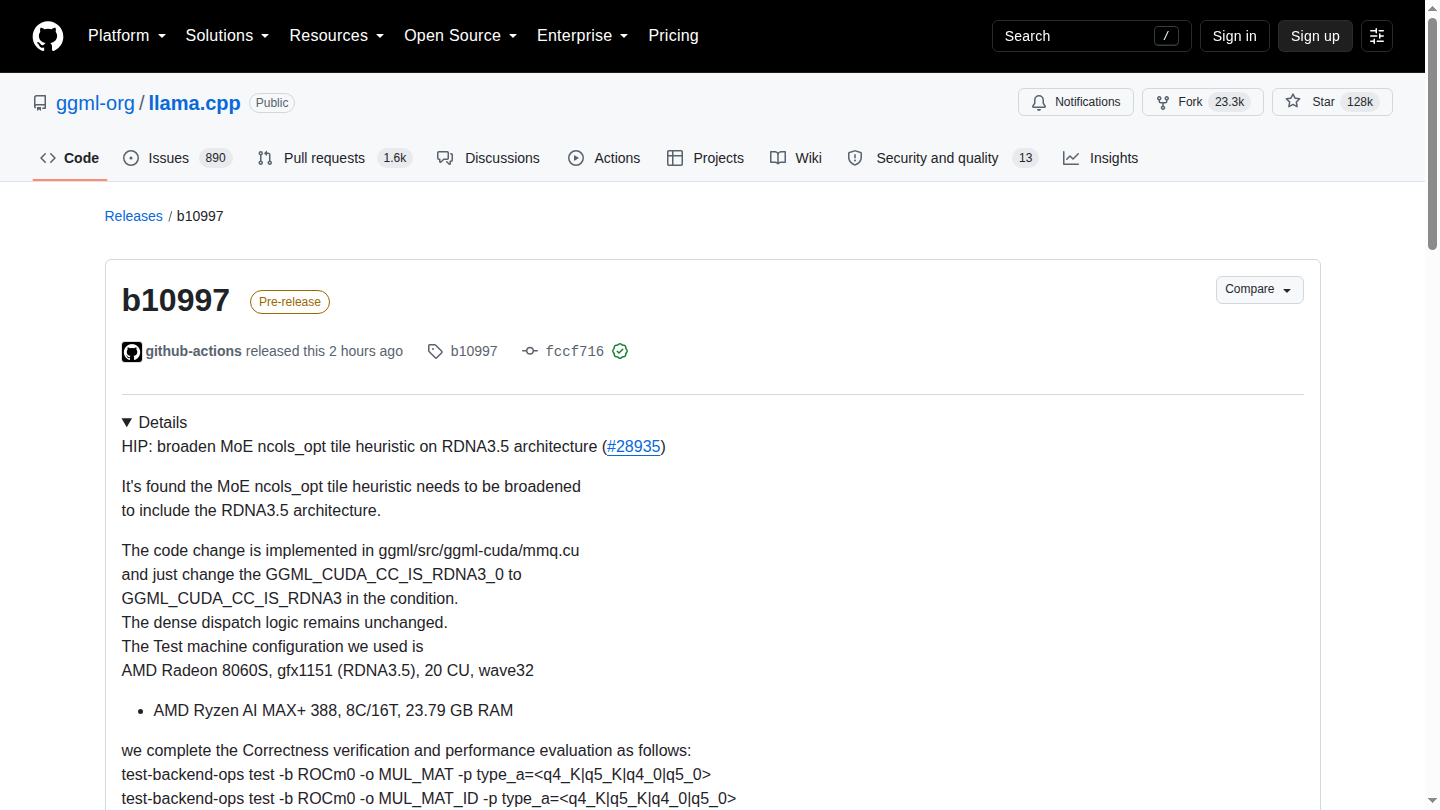
In breve: b10997 include RDNA 3.5 nell’euristica ncols_opt del backend HIP per le moltiplicazioni quantizzate dei modelli MoE. Il codice è già scaricabile; il miglioramento medio dichiarato è dell’11,1% su 16 coppie di test, ma serve una replica sulla propria macchina.
La modifica nel codice
La patch sostituisce il controllo limitato a RDNA 3.0 con quello che comprende l’intera famiglia RDNA 3. In questo modo gfx1151 usa anche per i modelli MoE il tile ncols_opt previsto dall’implementazione MMQ. La logica dense resta invariata.
Hardware e condizioni dichiarate
Il test primario usa una AMD Radeon 8060S, architettura gfx1151 RDNA 3.5, 20 compute unit e wave32. La build abilita HIP, Flash Attention e il target gfx1151, disabilitando alcuni percorsi CPU per isolare meglio il backend GPU.
I numeri da leggere con cautela
Nelle 16 coppie MoE riepilogate dal contributore, la media dichiarata è +11,081%. LFM2.5-8B-A1B Q4_K_M arriva a +16,198% e Qwen1.5-MoE-A2.7B Q2_K a +6,189%; alcuni test token-generation risultano invariati o molto meno sensibili.
Perché interessa il test Beelink
La Radeon 8060S è la GPU integrata della piattaforma già prevista nel protocollo locale AMD. Questo delta permette un confronto prima e dopo con gli stessi GGUF MoE, senza confondere l’effetto della patch con modello, quantizzazione o prompt diversi.
Condizioni e limitazioni
b10997 è una pre-release. Le misure sono del contributore, su una sola macchina e con cinque ripetizioni nel benchmark allegato. Non dimostrano benefici sui modelli dense, su altre GPU RDNA 3.5 o nel tempo totale di una sessione reale.
Checklist pratica
- Conservare la build precedente e annotare i due commit confrontati.
- Usare gli stessi GGUF MoE, prompt, context, batch e offload GPU.
- Registrare ROCm, driver, target gfx1151 e opzioni CMake.
- Eseguire almeno cinque coppie alternate per ridurre l’effetto termico.
- Misurare prompt processing, token generation, tempo totale e correttezza.
- Provare almeno due quantizzazioni e un modello dense come controllo negativo.