
L’ANALISI
Colibri 1.11 e DeepSeek V4.1 Flash: cosa significa eseguirlo da SSD
La release aggiunge un motore CPU che legge nativamente il checkpoint DeepSeek V4.1 Flash da SSD, ma capacità e compatibilità non equivalgono a inferenza veloce su hardware comune.
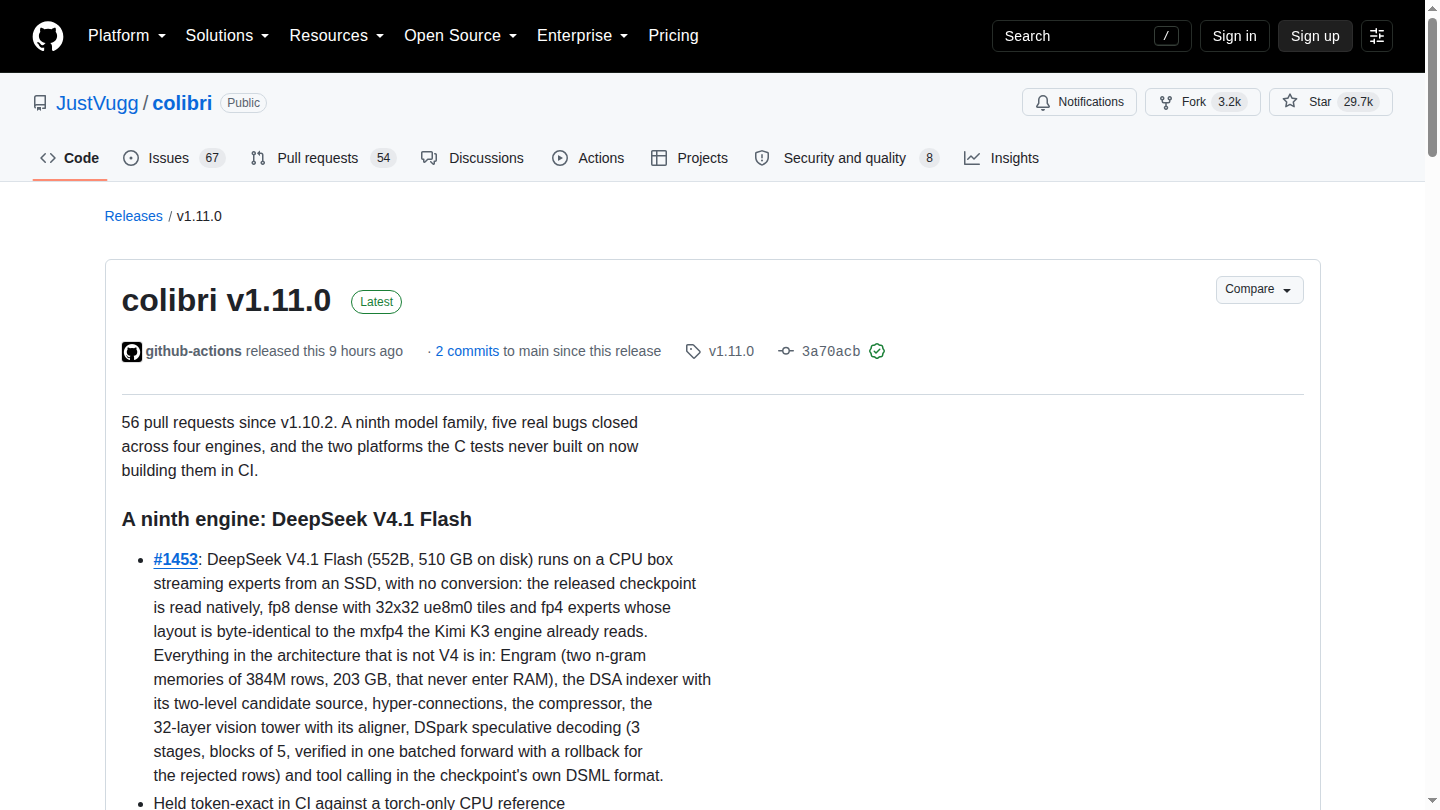
In breve: Colibri dimostra che il checkpoint DeepSeek V4.1 Flash può essere letto senza conversione e servito da una macchina CPU con gli esperti su SSD. È un percorso tecnico accessibile, non una promessa di prestazioni interattive su qualunque PC.
Che cosa è stato pubblicato
Colibri v1.11.0 introduce il nono motore del progetto per DeepSeek V4.1 Flash: legge nativamente tensori FP8 e FP4, conserva su disco gli esperti e le memorie Engram e serve chat, web e API senza una conversione preventiva.
Perché lo streaming da SSD conta
Il modello pesa circa 510 GB. Il motore evita di caricare tutto in RAM: instrada i token, legge gli esperti necessari con profondità configurabile e riusa la cache. Questo riduce il requisito di memoria, ma sposta il collo di bottiglia su storage e latenza.
Che cosa è stato verificato
Il progetto confronta l’engine con un riferimento CPU token-exact su più capacità di cache, prompt brevi e lunghi e tre modalità speculative. La torre visiva è dichiarata allineata entro 5e-06; restano verifiche del maintainer, non una replica indipendente.
Prestazioni e condizioni
Sul checkpoint rilasciato, a cache fredda e con stesso prompt e seed, il tempo del turno è sceso da 78,7 a 25,1 secondi durante lo sviluppo, pari a 0,305-0,957 token/s. In una chat di cinque turni il progetto riporta 1,14-1,58 token/s.
Limiti operativi
Servono il checkpoint completo, spazio disco adeguato e storage veloce. coli run non è collegato per questa famiglia; funzionano chat, serve e web. Le cifre pubblicate non permettono confronti diretti con GPU, quantizzazioni diverse o altri runtime.
Come valutarlo correttamente
La domanda pratica non è se il modello si avvia, ma se latenza, throughput, consumo e affidabilità reggono il proprio caso d’uso. Occorre separare il test token-exact del motore dalle prestazioni della macchina reale.
Checklist pratica
- Verificare almeno 510 GB liberi più margine per cache e file temporanei.
- Usare la release v1.11.0 e controllare gli SHA256 degli asset.
- Registrare CPU, RAM, tipo di SSD e profondità di lettura.
- Eseguire prima il test di riferimento token-exact.
- Misurare primo token, token/s e latenza su più turni.
- Provare chat o server sul proprio workload prima di adottarlo.