
L’ANALISI
MiniCPM5-2B: cosa cambia per eseguire un modello compatto in locale
Un modello da 2,5 miliardi di parametri con GGUF, MLX e GPTQ amplia le opzioni locali, ma contesto e qualità dichiarati richiedono prove sul dispositivo reale.
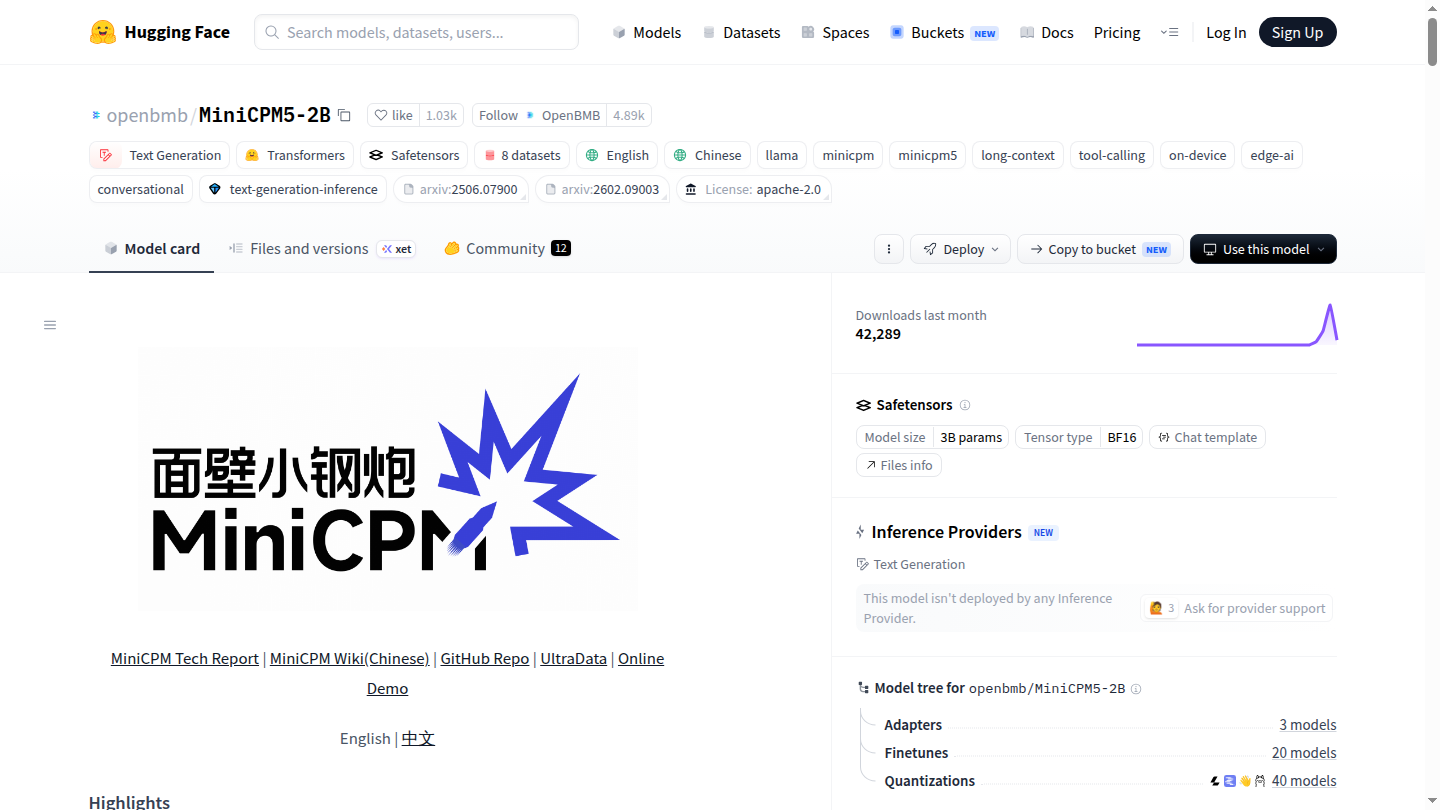
In breve: MiniCPM5-2B è un rilascio operativo per l’AI locale: oltre ai pesi BF16 offre GGUF, MLX e GPTQ, così il medesimo modello può essere provato su llama.cpp, Ollama, LM Studio e Apple Silicon. Le prestazioni dichiarate restano però da verificare.
Che cosa è stato pubblicato
La famiglia comprende il checkpoint finale BF16 e varianti SFT, base e mid-training. Per l’esecuzione locale OpenBMB pubblica inoltre GGUF in F16, Q8_0 e Q4_K_M, MLX a 4 bit per Apple Silicon e GPTQ a 4 bit.
Dimensioni e contesto
La model card dichiara 2.516.756.480 parametri, 42 livelli e un contesto nativo di 131.072 token. La dimensione compatta rende plausibile il test su hardware personale, ma la memoria effettiva cresce con contesto, cache KV e runtime scelto.
Quale formato scegliere
GGUF è destinato a llama.cpp, Ollama e LM Studio; MLX punta ad Apple Silicon; GPTQ offre un percorso quantizzato alternativo. I formati non sono intercambiabili automaticamente: backend, template chat e supporto alle funzioni vanno verificati insieme.
Condizioni e limiti
OpenBMB presenta risultati di benchmark favorevoli su codice, matematica, contesto lungo, tool use e task agentici, ma sono confronti del produttore. Mancano ancora prove indipendenti uniformi su qualità italiana, velocità, memoria e affidabilità delle chiamate agli strumenti.
Checklist prima di provarlo
- Scegliere il formato compatibile con il runtime: GGUF, MLX, GPTQ o BF16.
- Verificare commit e hash dei file prima del download.
- Stimare memoria includendo modello, cache KV e contesto desiderato.
- Controllare il template chat e il supporto alle chiamate degli strumenti.
- Provare qualità italiana, codice e tool use su dati non sensibili.
- Misurare latenza, throughput e memoria sul proprio dispositivo.