
L’ANALISI
NVIDIA PAIR distribuisce l’inferenza locale tra PC, senza sommare la VRAM
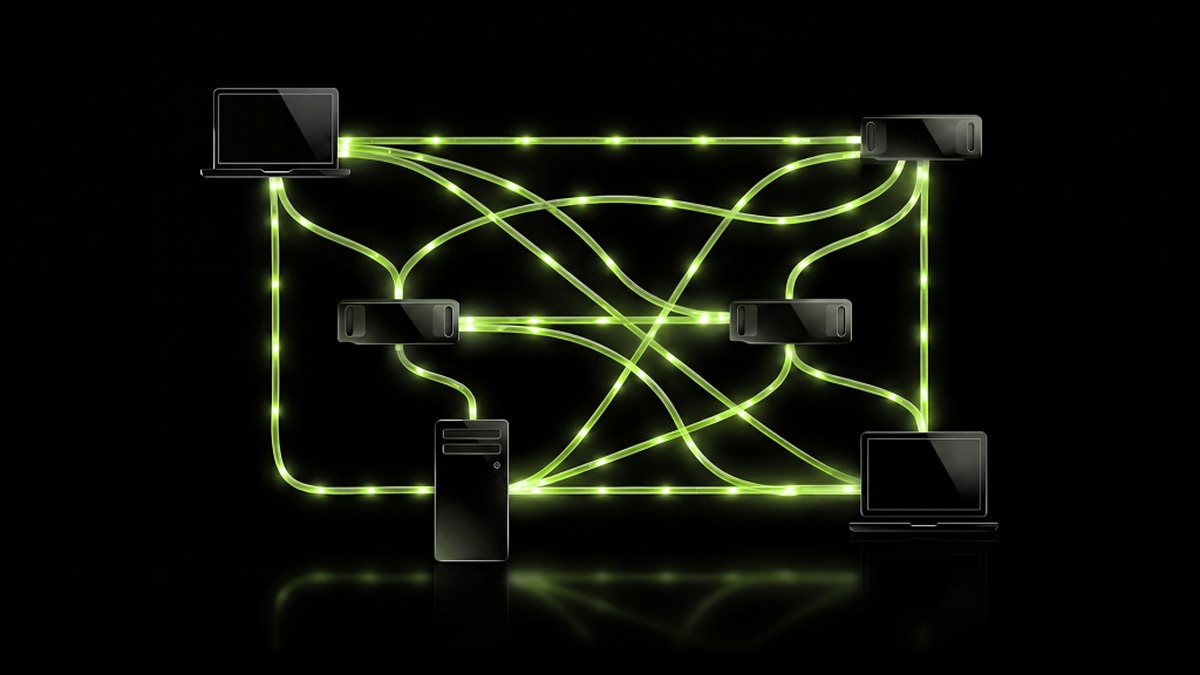
NVIDIA ha rilasciato in beta PAIR, un router open source che espone un solo endpoint locale e distribuisce richieste indipendenti tra sistemi compatibili con Ollama o LM Studio.
Risposta diretta: PAIR allarga la capacità per carichi paralleli scegliendo un nodo idoneo per ogni richiesta. Non fonde GPU o VRAM e non divide una singola inferenza tra macchine.
Che cosa instrada
PAIR è un proxy compatibile con le interfacce di Ollama e LM Studio. Scopre i nodi, controlla motore e modello disponibili e assegna ogni nuova richiesta a una sola macchina idonea.
Dove può servire
Il vantaggio emerge con agenti e applicazioni che generano più richieste indipendenti. Il nodo principale continua a vedere un endpoint unico mentre il router gestisce il posizionamento.
Come protegge la rete
La scoperta usa mDNS e il collegamento richiede approvazione. NVIDIA dichiara comunicazioni tra nodi protette con mTLS e certificati generati dopo il pairing.
Che cosa dimostra la prova NVIDIA
In una demo con Hermes, Ollama e cinque subtask, tre dispositivi hanno completato il carico in 8 minuti e 48 secondi contro 18 minuti su un solo laptop RTX Spark. NVIDIA la definisce una prova non ufficiale e specifica della configurazione.
Condizioni e limiti
Ogni nodo deve avere il motore attivo e il modello richiesto. PAIR non unisce la memoria delle GPU, non shardizza il modello e non accelera automaticamente attività dominate da una sola chiamata lunga.
Quando provarlo
Ha senso se esistono già più sistemi compatibili e un carico locale concorrente misurabile. Prima di adottarlo va verificato che telemetria e tempi end-to-end mostrino lavoro su più nodi.
Checklist pratica
- Installa la beta solo su una rete controllata.
- Abbina i nodi e verifica i certificati e l’elenco dei dispositivi autorizzati.
- Usa lo stesso tag di modello sui nodi che devono servire lo stesso carico.
- Esegui un test identico su un nodo e sul cluster.
- Controlla nella vista Jobs che le richieste siano davvero distribuite.
- Misura tempo totale, qualità, consumo e comportamento quando un nodo sparisce.