
L’ANALISI
ttok 1.0: contare e troncare token con il tokenizer corretto
Analisi pratica di ttok 1.0: nuovo default o200k_base, prefissi dei modelli, installazione con uv e controlli per evitare stime token incoerenti.
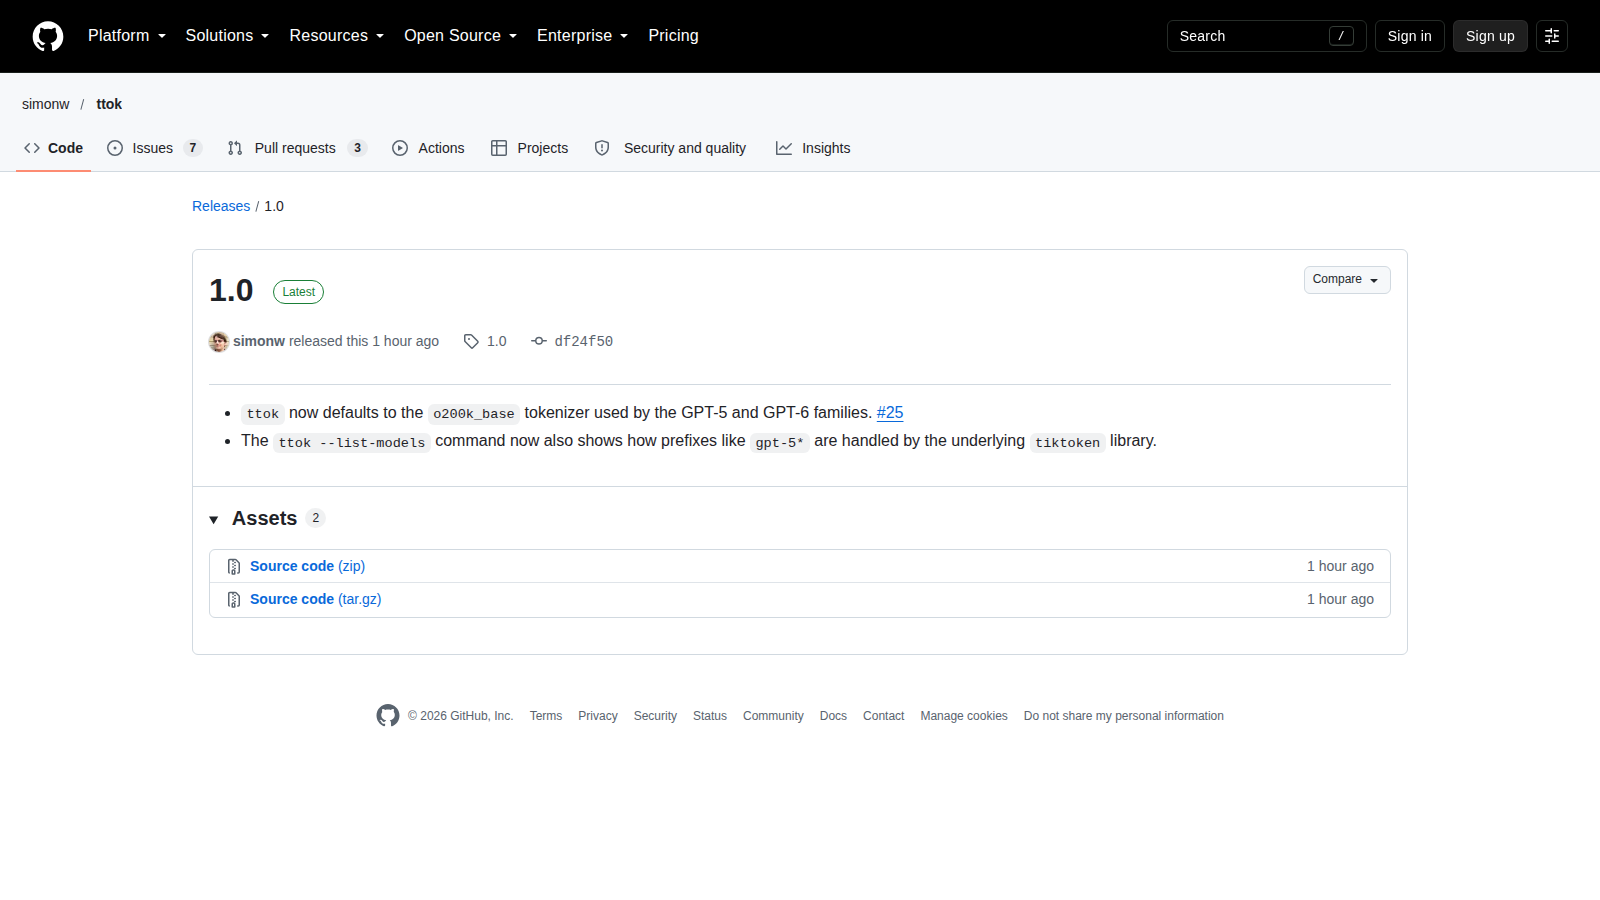
In breve: ttok 1.0 rende più coerente il controllo locale dei token per i modelli recenti: senza opzioni usa o200k_base e rende visibili nomi e prefissi riconosciuti da tiktoken. Nei workflow di costo o truncation conviene comunque passare esplicitamente il modello e bloccare le versioni delle dipendenze.
Che cosa cambia nella versione 1.0
La release cambia il modello predefinito da quello usato dalle generazioni GPT-3.5 e GPT-4 a gpt-5, che tiktoken associa a o200k_base. Lo stesso encoding viene indicato per le famiglie GPT-5 e GPT-6 nella nota di rilascio.
Perché il tokenizer conta
Tokenizzatori diversi possono produrre conteggi, identificativi e punti di taglio differenti sullo stesso testo. Un limite calcolato con cl100k_base e applicato poi a un flusso o200k_base può quindi lasciare margine inutile o troncare in un punto diverso da quello previsto.
Il nuovo elenco di modelli e prefissi
ttok --list-models mostra i nomi esatti e anche prefissi come gpt-5*. La risoluzione usa le regole della libreria tiktoken installata: è utile per diagnosticare l’encoding scelto, ma non è un catalogo di disponibilità commerciale dei modelli.
Dove inserirlo in un workflow
Il comando può leggere argomenti, file o standard input, contare, mostrare i token e troncare a una soglia. È adatto come controllo locale prima di una chiamata API, in una pipeline documentale o in test riproducibili, purché modello e dipendenze siano espliciti.
Condizioni e limitazioni
Il conteggio resta legato alla versione installata di tiktoken e alla corrispondenza nome-modello/tokenizer. I prefissi indicano quale encoding viene scelto, non verificano che un modello esista né stimano token aggiunti dal protocollo API.
Checklist pratica
- Eseguire uvx ttok --version e registrare la versione ottenuta.
- Controllare ttok --list-models e identificare l’encoding del modello realmente usato.
- Passare --model con il nome completo invece di affidarsi al default nei workflow persistenti.
- Provare conteggio e truncation su un campione multilingue rappresentativo.
- Confrontare il risultato con l’uso API reale, includendo l’eventuale overhead dei messaggi e degli strumenti.