
L’ANALISI
ExLlamaV3 1.4.8 accelera l’offload CPU, ma i benchmark restano community
La release 1.4.8 consolida l’inferenza ExLlamaV3 con offload CPU; test community su Qwen 3.8 riportano vantaggi su llama.cpp, da replicare sul proprio hardware.
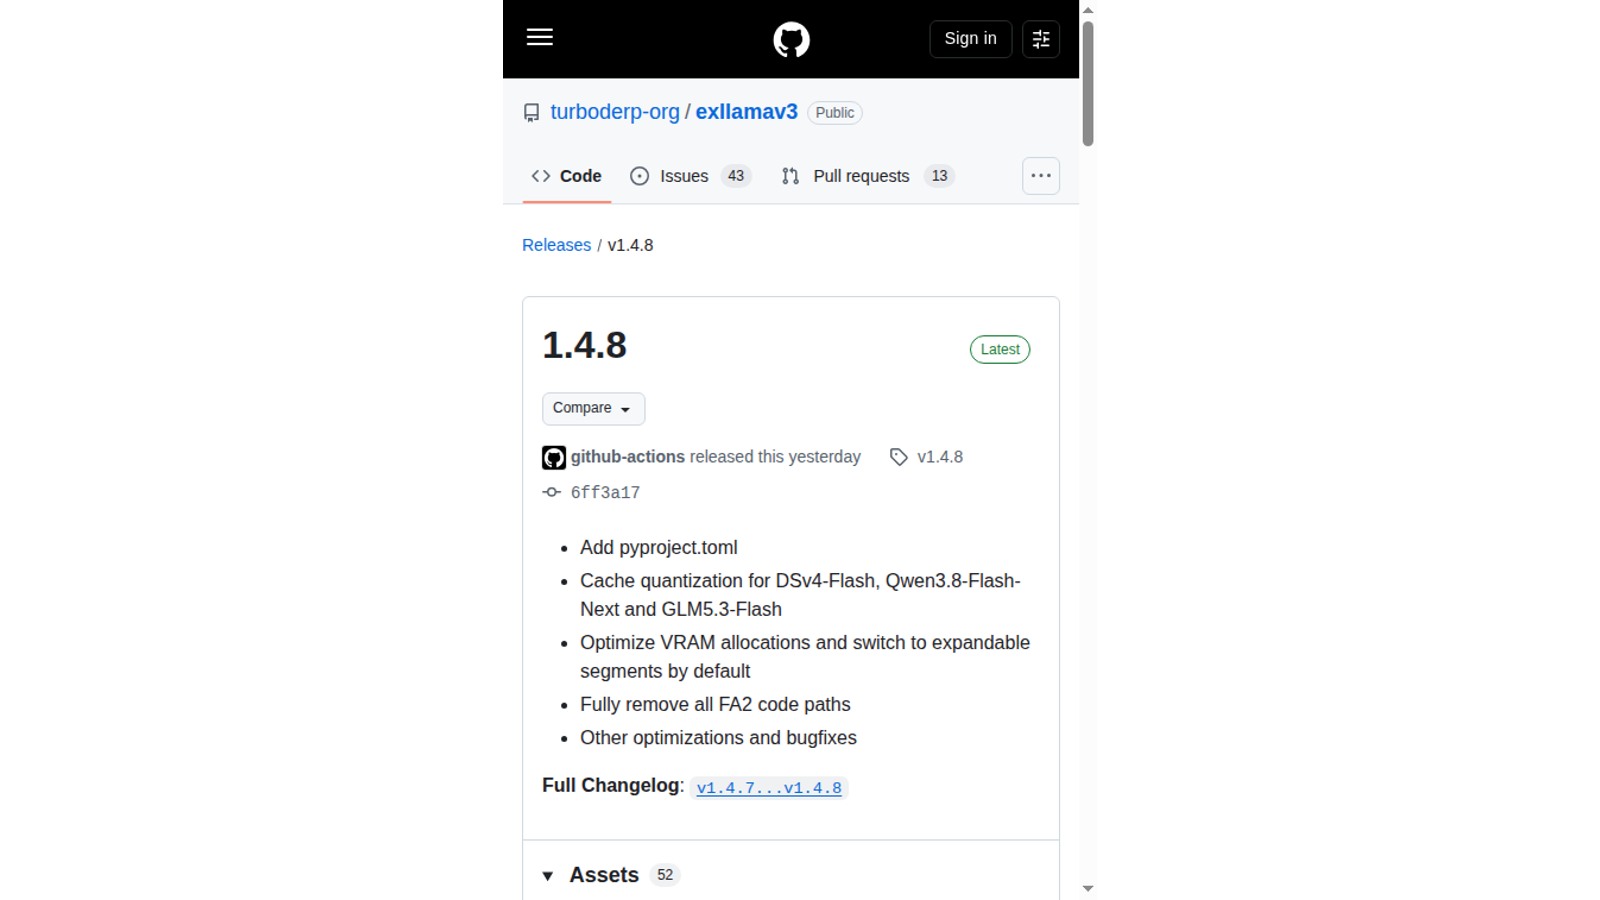
In breve: La release 1.4.8 consolida l’inferenza ExLlamaV3 con offload CPU; test community su Qwen 3.8 riportano vantaggi su llama.cpp, da replicare sul proprio hardware.
Che cosa cambia
La release 1.4.8 del 6 settembre è il delta primario verificato.
Due test indipendenti della community riportano circa 3,2 volte nel prefill e 2 volte nel decode su Qwen 3.8 Flash Next.
Il vantaggio dichiarato riguarda configurazioni NVIDIA con parte del modello in RAM.
Perché conta adesso
Il delta modifica ciò che un team può scaricare, eseguire, misurare o mettere in sicurezza oggi, distinto dall’annuncio originario del progetto.
Impatto operativo
La decisione utile è verificare compatibilità, costi e confini di sicurezza sul proprio ambiente prima di estendere il rollout.
Condizioni e limiti
I rapporti di velocità non sono benchmark del progetto e dipendono da GPU, modello, quantizzazione, contesto e quota offloaded.
Checklist pratica
- Annota GPU, VRAM, RAM e versione driver.
- Usa lo stesso quant, prompt e contesto su entrambi i runtime.
- Separa prefill, decode e qualità dell’output.