
L’ANALISI
Flint per il coding locale: pesi, memoria e limiti del supporto Ollama
Flint per il coding locale: pesi Apache 2.0, release Ollama del 21 ottobre, memoria BF16, contesto documentato e limiti dei benchmark del produttore.
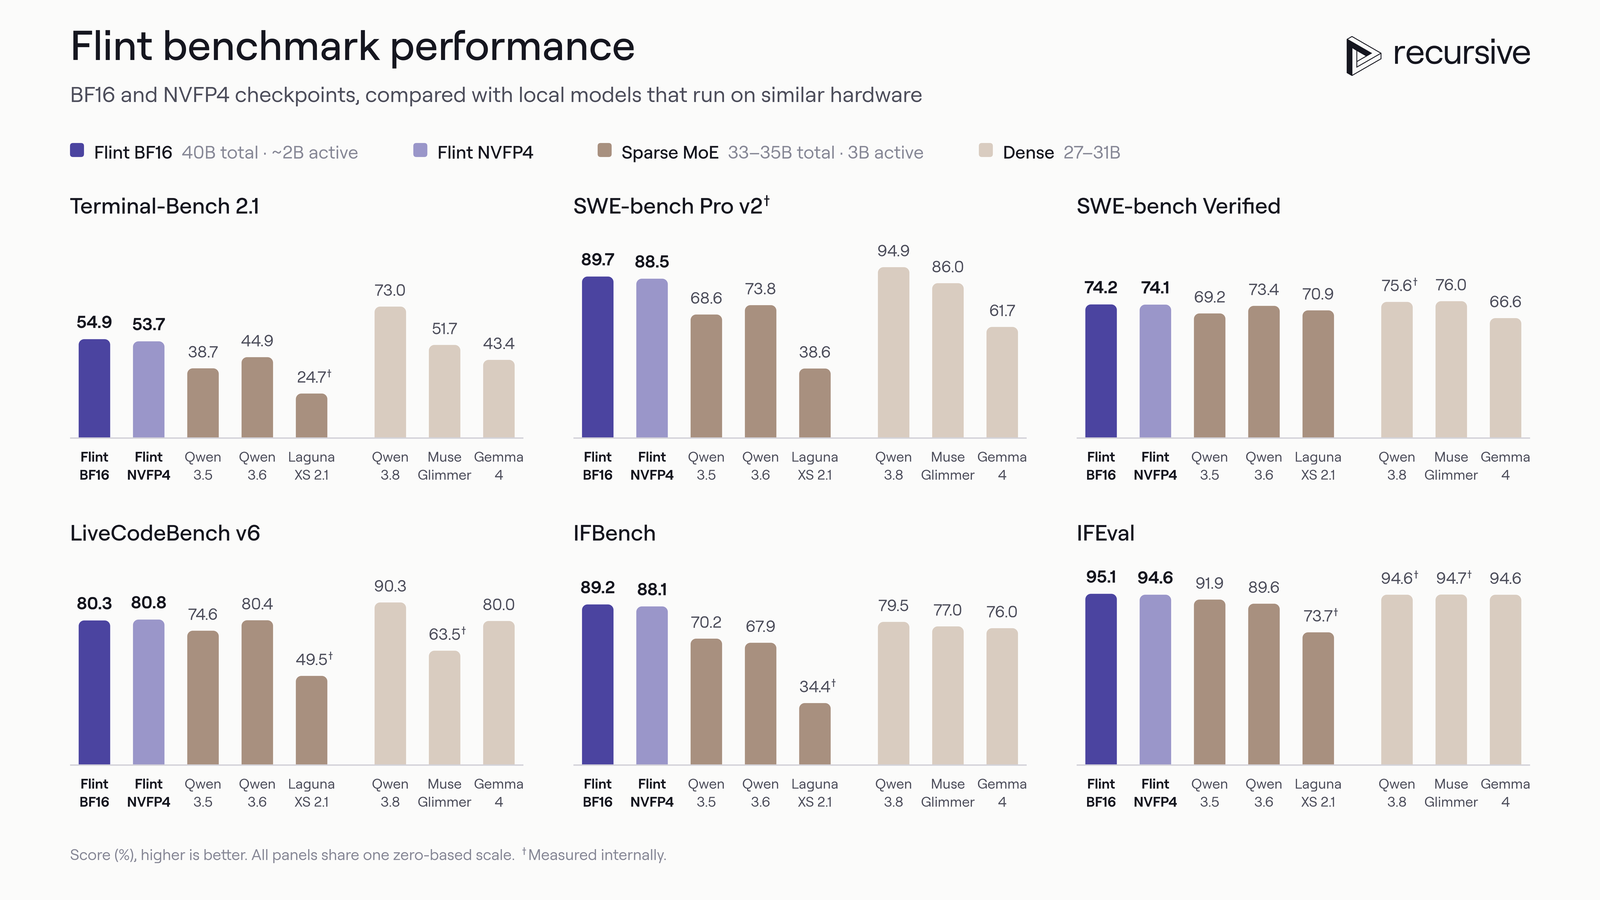
In breve: Flint è un nuovo modello scaricabile per il coding, non un agente completo che si installa insieme ai pesi. Prima di provarlo bisogna scegliere il formato compatibile con il proprio runtime e separare memoria dei pesi, cache del contesto e strumenti dell’agente. Per il 21 ottobre è verificato anche un percorso Ollama su macOS, senza estenderlo retroattivamente a Linux e Windows.
La novità del 21 ottobre è verificabile nei registri di rilascio
Il repository ufficiale Hugging Face contiene una prima revisione del 21 ottobre con checkpoint, configurazione e template di chat. La release Ollama 0.40.8 risulta pubblicata lo stesso giorno alle 16:20 UTC, come release stabile e non preliminare. Il feed riporta invece le 14:45, che nell’API corrispondono a created_at. Per il recupero storico conta la pubblicazione effettiva, non la creazione del tag o l’ora della raccolta.
I parametri attivi non sono la memoria da prenotare
Flint è un mixture-of-experts: la model card distingue 39,8 miliardi di parametri totali da circa 2,5 miliardi attivi per token. Questo riduce il lavoro su ogni token, ma non trasforma il modello in un checkpoint da 2,5 miliardi. Il repository BF16 contiene 15 shard indicizzati e indica un download di circa 80 GB. Per valutare un laptop occorre partire da una variante quantizzata appropriata e misurare anche la cache, non stimare la RAM dai soli parametri attivi.
Ollama su macOS e il kit BF16 sono due percorsi diversi
Le note di Ollama 0.40.8 indicano il comando ollama run flint, ma precisano che il supporto riguarda macOS e rimandano le altre GPU a una release successiva. La model card BF16 propone invece un kit SGLang su H200 o B300 e dichiara che il codice di modellazione Transformers non è ancora incluso. Non basta quindi leggere library_name: transformers nei metadati per promettere un caricamento diretto con qualsiasi installazione Python. Qui sono verificati documenti e artefatti elencati, non l’avvio dei due ambienti.
Il contesto da usare è quello del checkpoint verificato
La pagina di lancio parla di un massimo di 512 mila token, consigliando di restare entro 256 mila. La model card e config.json della revisione fissata documentano invece 262.144 token complessivi tra prompt e output. Questa divergenza va mantenuta visibile: per una prova riproducibile fa fede la configurazione del checkpoint e del runtime scelti, non il valore più alto nell’annuncio. Il limite di capacità non dimostra accuratezza uniforme su repository lunghi.
Benchmark e velocità non sono risultati misurati da Radar
Recursive riporta 54,9% su Terminal-Bench 2.1 e 74,2% su SWE-bench Verified. La model card specifica Terminus 2 per il primo e mini-swe-agent per il secondo, con pass@1 medio su almeno cinque tentativi. Precisa inoltre che configurazioni e criteri dei confronti possono differire. Anche le velocità sul laptop nel lancio dipendono dal motore ottimizzato e dal contesto. Questi dati orientano una prova, ma non dimostrano un vantaggio sulla propria macchina o con il proprio harness.
Una prova utile comincia da un repository controllato
Protocollo proposto, non eseguito: fissare revisione dei pesi, quantizzazione, versione del runtime e hardware. In una copia di un piccolo repository chiedere prima una spiegazione, poi un test mirato e infine una correzione verificabile. Registrare diff, test superati, picco di memoria e tempo fino al risultato utile. Ripetere con lo stesso budget sul modello già in uso. Tenere disabilitati invii, deploy e accessi a segreti; l’inferenza locale non certifica che l’intero harness non contatti servizi esterni.
Condizioni e limitazioni
Nessun test di inferenza Radar: prestazioni e punteggi restano dichiarazioni del produttore. Il checkpoint BF16 occupa circa 80 GB e la sua ricetta SGLang usa H200 o B300; non è il pacchetto da confondere con una variante per laptop. Il supporto Ollama della release verificata riguarda macOS, non tutte le GPU.
Checklist pratica
- Usare il 21 ottobre come data del rilascio verificato; distinguere published_at da created_at di Ollama.
- Fissare la revisione Hugging Face 2a247be0c0aec895ccb0ac7ca92229ec6df37288 e il formato dei pesi.
- Non confondere 2,5 miliardi di parametri attivi con il requisito di memoria del modello.
- Per Ollama 0.40.8 mantenere il perimetro macOS dichiarato nelle note della release.
- Dimensionare prompt e output sul limite documentato di 262.144 token del checkpoint verificato.
- Provare su una copia del repository senza segreti, controllando diff e risultati dei test prima di applicare modifiche.