
L’ANALISI
VoxCPM2 in llama.cpp: cosa serve per la voce locale
VoxCPM2 entra in llama.cpp b12531: servono modello GGUF e mmproj. Italiano tra le 30 lingue dichiarate, audio locale non ancora provato.
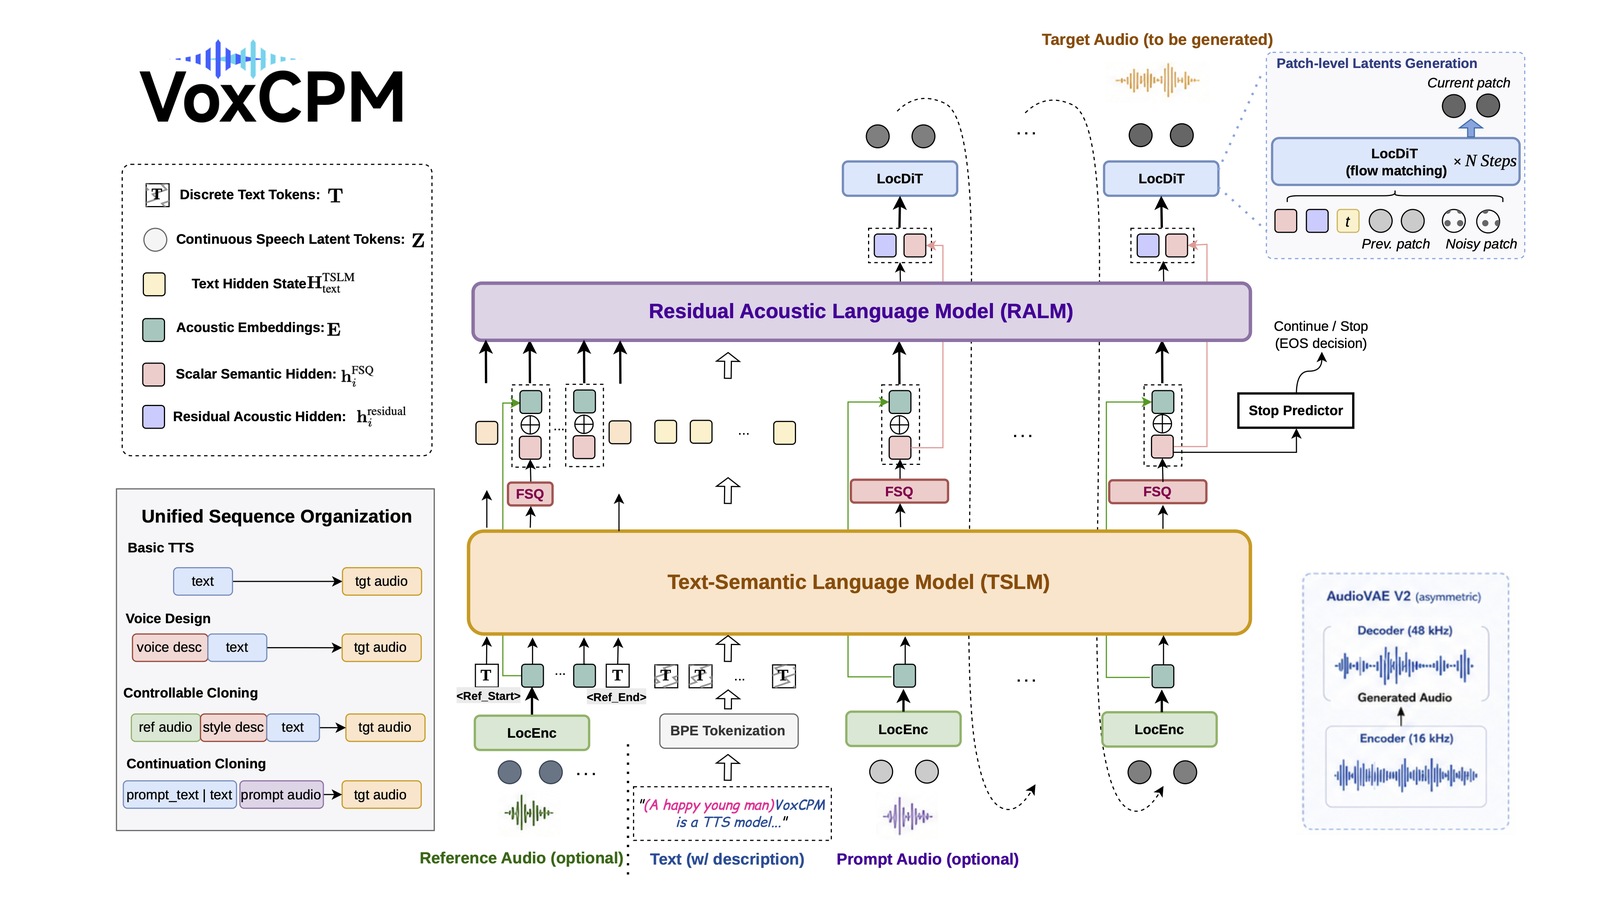
In breve: VoxCPM2 può ora essere preparato per llama.cpp grazie al supporto integrato nella prerelease b12531 del 19 novembre 2026. Il percorso documentato usa llama-tts con un GGUF principale e il relativo mmproj. È una nuova integrazione nel runtime, non il lancio odierno del modello né una prova che la voce italiana funzioni bene su qualsiasi computer. llama.cpp b12531: note della prerelease · Guida TTS al commit e4b620a: requisiti e limiti VoxCPM2.
Verifica documentale del 19 novembre 2026: release, pull request, guida fissata al commit e scheda del produttore. Non sono stati installati il runtime o i pesi, né generati o ascoltati file audio. Le procedure qui sotto sono proposte di verifica, non risultati personali.
Che cosa cambia il 19 novembre in llama.cpp?
La pull request 32443 è stata integrata il 19 novembre alle 02:39:06, ora italiana; la prerelease b12531 è stata pubblicata alle 03:20:33 e punta allo stesso commit e4b620af19f02960dea7a3a81de7c5805aa3a333. Il delta è quindi identificabile e riproducibile: supporto VoxCPM2 dentro il runtime. Non occorre chiamarlo nuovo modello per spiegare perché interessa a chi usa già llama.cpp. Resta però un artefatto marcato prerelease: per una prova conviene fissare questa versione, senza assumere che un tag successivo abbia esattamente lo stesso comportamento. llama.cpp b12531: note della prerelease · llama.cpp: pull request 32443 integrata.
Italiano e 48 kHz: che cosa dichiara il produttore?
OpenBMB descrive VoxCPM2 come modello text-to-speech, cioè da testo a voce, con 2 miliardi di parametri e 30 lingue, italiano incluso. I pesi sono i file numerici necessari a eseguire il modello. La scheda dichiara uscita a 48 kHz, ma quel numero indica la frequenza di campionamento, non la naturalezza della pronuncia. Anche la presenza dell'italiano è un requisito documentato, non un ascolto riuscito. Le prestazioni pubblicate per l'implementazione del produttore non vanno trasferite automaticamente al nuovo backend llama.cpp o a un altro hardware. OpenBMB: scheda ufficiale VoxCPM2.
Perché servono sia GGUF sia mmproj?
La guida al commit dell'integrazione mostra un file VoxCPM2.gguf e un secondo file mmproj-VoxCPM2.gguf. Il primo contiene il modello principale; il secondo include i componenti necessari al percorso audio, tra cui il modello linguistico residuo e l'AudioVAE. Scaricare soltanto il programma o soltanto il GGUF principale non completa quindi la preparazione descritta. Il documento propone anche due conversioni distinte a partire dai pesi originali. Non viene qui indicato un pacchetto GGUF di terzi come equivalente verificato: provenienza, conversione e corrispondenza dei due file restano controlli da fare prima dell'esecuzione. Guida TTS al commit e4b620a: requisiti e limiti VoxCPM2.
Quali funzioni non sono ancora equivalenti?
Nel backend la lingua segue il testo e il parametro --tts-lang non viene usato. La guida descrive una voce tramite istruzione iniziale tra parentesi e un percorso opzionale con audio di riferimento; per una prima verifica non è necessario clonare una persona. Non sono invece supportati la continuation mode del riferimento, che usa audio e trascrizione, e il bad-case retry automatico. Gli autori avvertono che prompt brevi possono produrre audio troppo lungo e ripetizioni, suggerendo un altro seed. Sono limiti espliciti del percorso integrato, non difetti da nascondere dietro le capacità generali della scheda del modello. Guida TTS al commit e4b620a: requisiti e limiti VoxCPM2.
Come impostare una prima prova senza promettere un risultato?
Il comando seguente adatta l'esempio documentato a un testo italiano originale e non usa voci di terzi. Presuppone un eseguibile llama-tts compatibile e i due file convertiti correttamente nella cartella corrente. È un esempio da eseguire e verificare, non un comando già provato qui. Il WAV va ascoltato per intero: l'esistenza del file non basta a dimostrare che numeri, accenti e frase finale siano corretti. Per confrontare due versioni occorre conservare lo stesso testo, le impostazioni e l'hardware, riportando anche eventuali ripetizioni o tagli. Guida TTS al commit e4b620a: requisiti e limiti VoxCPM2.
llama-tts -m VoxCPM2.gguf \
  -mm mmproj-VoxCPM2.gguf \
  -p "Benvenuti. Oggi leggiamo una breve frase in italiano, con il numero ventitré." \
  --output prova-italiano.wav
Quando è utile e quando serve un'altra misura?
L'integrazione è utile a chi vuole valutare la sintesi vocale nello stesso ambiente dei propri modelli locali. Non comprende però da sola riconoscimento del parlato, gestione del turno e telefonia. Un centralino deve misurare l'intera conversazione, non soltanto la generazione del WAV. Il giudizio operativo resta circoscritto: supporto presente e requisiti documentati; memoria, velocità e resa italiana ancora non misurate in questo lavoro. Prima di sostituire un servizio funzionante serve una prova controllata con criteri dichiarati, non una conclusione ricavata dalle note di rilascio. llama.cpp b12531: note della prerelease · Guida TTS al commit e4b620a: requisiti e limiti VoxCPM2.
Condizioni e limitazioni
Analisi delle fonti, non prova audio: nessuna inferenza eseguita e nessuna misura di memoria, velocità o qualità italiana. Il backend non supporta ancora continuation mode e bad-case retry; la guida avverte di possibili ripetizioni con prompt brevi. b12531 è una prerelease, non una release stabile. llama.cpp b12531: note della prerelease · Guida TTS al commit e4b620a: requisiti e limiti VoxCPM2.
Checklist pratica
- Fissare versione e commit del runtime; annotare sistema operativo, CPU, GPU e memoria disponibile.
- Verificare origine e licenza dei pesi, conversione e hash di entrambi i file GGUF e mmproj.
- Usare un testo italiano originale, senza dati personali e senza clonare voci di terzi.
- Conservare comando completo, seed, log, WAV e durata dell'elaborazione.
- Ascoltare l'intero file e annotare ripetizioni, numeri errati, tagli o silenzi.
- Separare la durata del file dal tempo di calcolo; non chiamare il risultato latenza di un centralino.