
L’ANALISI
llama.cpp b10955: perché il fix CPU evita la corruzione heap
Una differenza nella dimensione della cache line poteva rendere troppo piccolo il buffer RoPE. La nuova build elimina la dipendenza dall’ordine degli include.
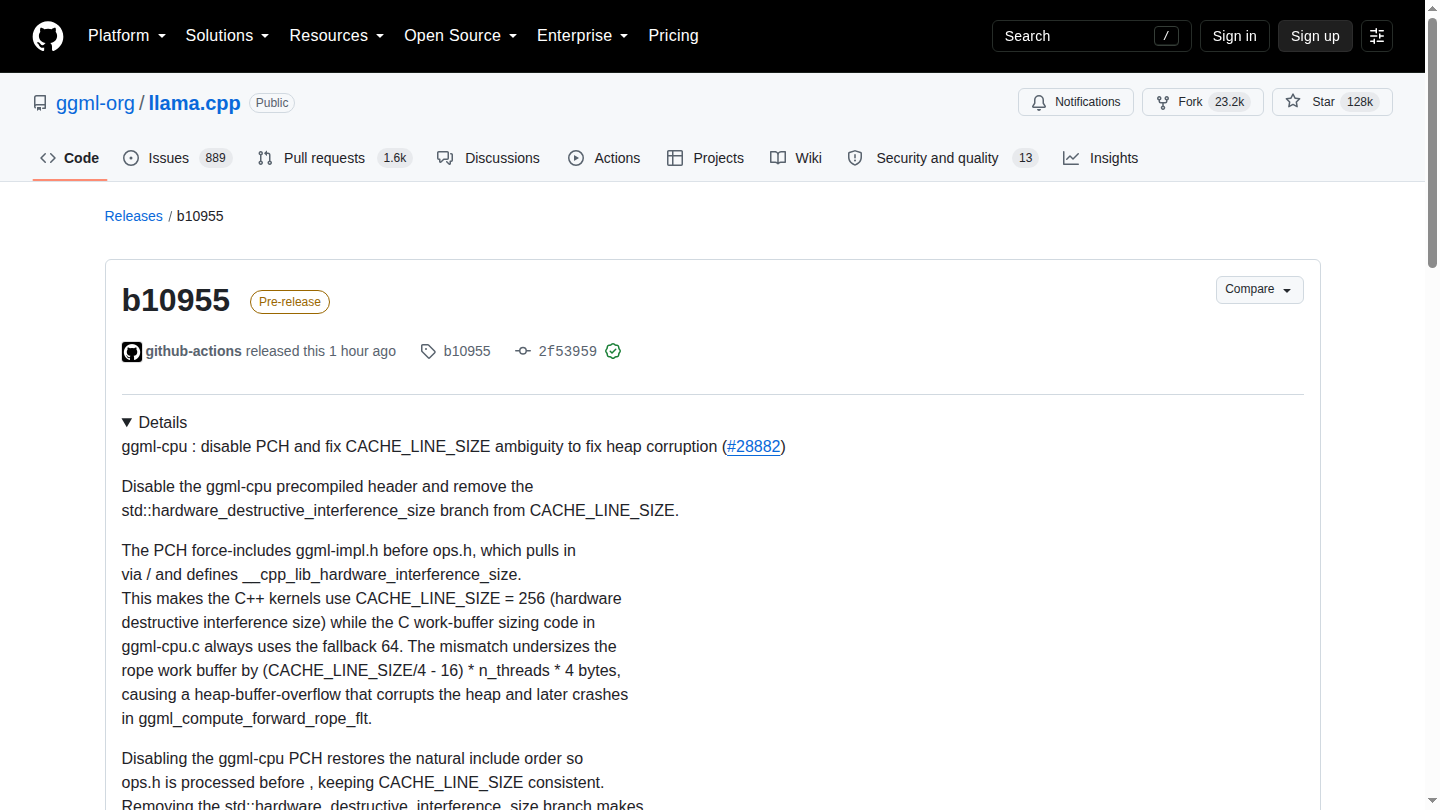
In breve: Aggiornare a b10955 o a una revisione successiva che includa il fix evita che due unità di compilazione calcolino CACHE_LINE_SIZE in modo diverso. Quel disallineamento poteva sottodimensionare il buffer RoPE e corrompere l’heap.
Il difetto corretto
Il precompiled header di ggml-cpu forzava un ordine degli include diverso. Nei kernel C++ CACHE_LINE_SIZE poteva diventare 256, mentre il codice C che dimensionava il work buffer conservava il fallback 64.
Perché il crash appariva più tardi
Il buffer risultava più piccolo di quanto i kernel si aspettassero. La scrittura oltre il limite avveniva nel calcolo RoPE, ma la corruzione dell’heap poteva manifestarsi con un crash successivo, rendendo meno immediata l’origine del problema.
Come cambia b10955
La patch disattiva il precompiled header per ggml-cpu e rimuove il ramo basato su std::hardware_destructive_interference_size. Il valore diventa deterministico e indipendente dall’ordine degli include.
Cosa cambia per chi distribuisce llama.cpp
Sono disponibili nuovi binari per macOS, Linux, Android e Windows. Il delta è di affidabilità: non aggiunge modelli o velocità, ma elimina una causa documentata di overflow e crash nelle build interessate.
Condizioni e limitazioni
b10955 è una pre-release. La causa è specifica del backend CPU e della configurazione di compilazione descritta nella patch. Prima del rollout va riprodotto il carico che attivava RoPE e controllata l’assenza di errori con un memory sanitizer quando possibile.
Checklist pratica
- Annotare commit e opzioni della build che mostra il crash.
- Riprodurre il workload RoPE con la build precedente e conservare il log.
- Installare b10955 o verificare la presenza del commit 2f539596.
- Ripetere lo stesso carico con numero di thread e modello invariati.
- Eseguire ASan o un controllo equivalente se la toolchain lo consente.
- Distribuire solo dopo la prova sul backend CPU e mantenere il rollback.